
NVIDIA P106 100

NVIDIA P106 100
Análisis de la tarjeta gráfica NVIDIA P106 100

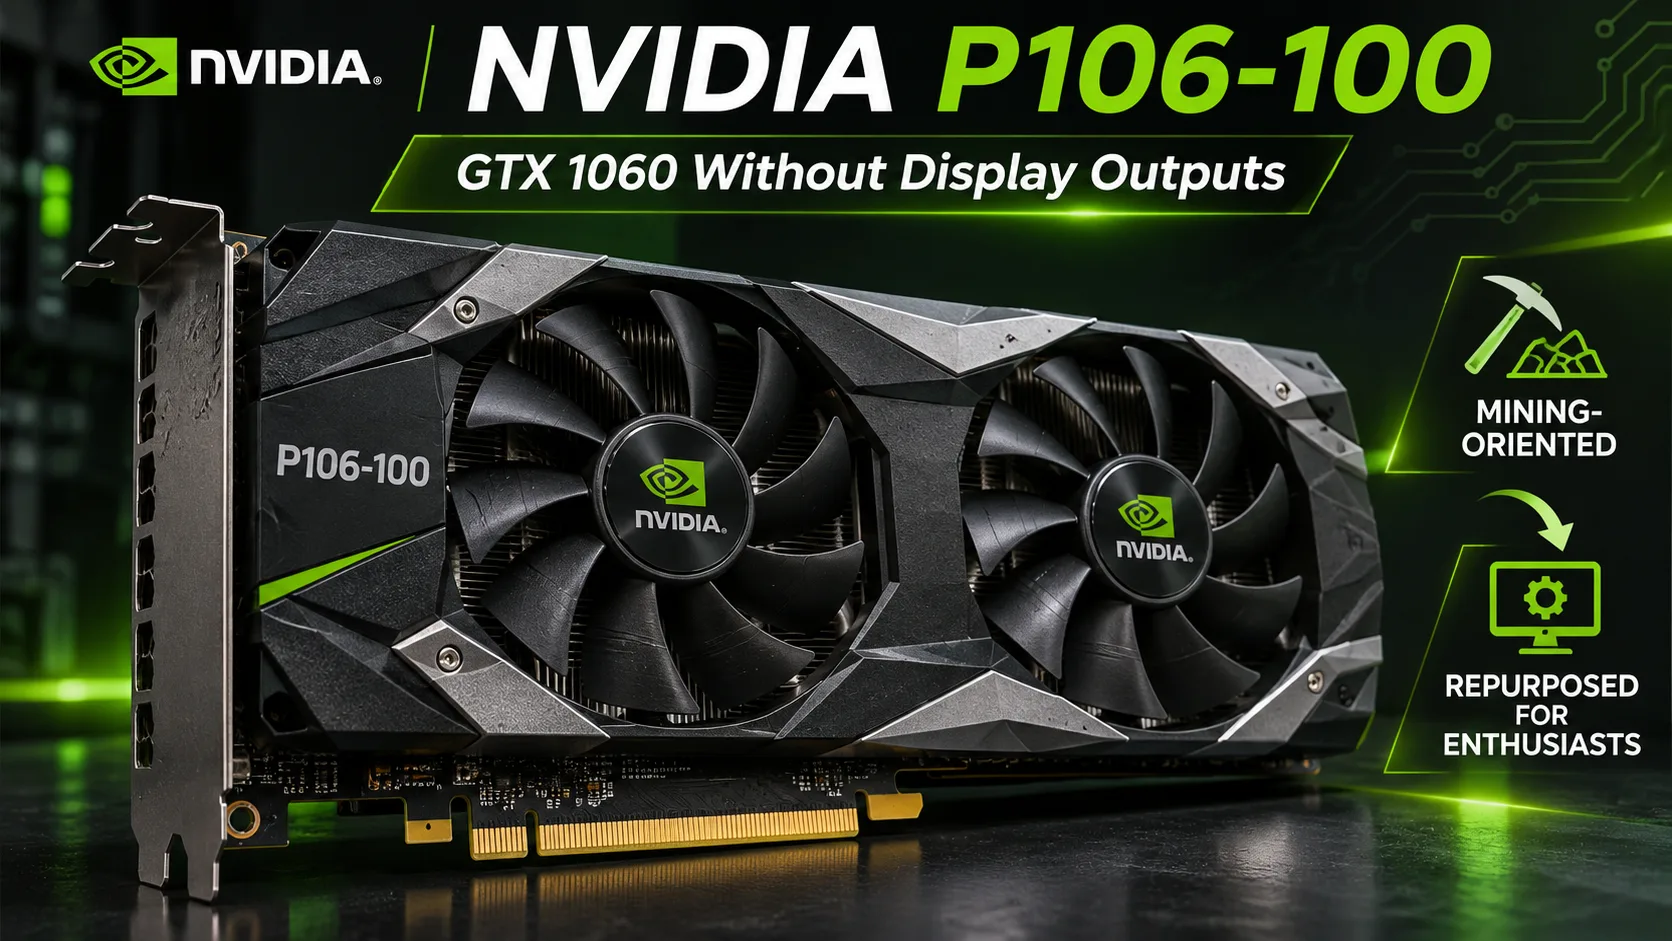
NVIDIA P106-100: una GTX 1060 sin salidas de vídeo ni controladores para juegos

La NVIDIA P106-100 salió en junio de 2017 para minar criptomonedas. Por sus especificaciones, es casi idéntica a la GeForce GTX 1060 6 GB: procesador GP106, 1280 núcleos CUDA y 6 GB de GDDR5. Sin embargo, la P106-100 no tiene salidas de vídeo, sus controladores para juegos requieren modificaciones y la interfaz PCIe está limitada en muchas unidades.

En 2026, la P106-100 se encuentra en el mercado de segunda mano por $30-50, frente a los $50-70 de una GTX 1060 6 GB convencional. El ahorro es pequeño, mientras que los problemas de compatibilidad son considerablemente mayores.

Diferencias respecto a la GTX 1060

Característica P106-100 GTX 1060 6 GB
Salidas de vídeo Ninguna HDMI, DisplayPort, DVI
Interfaz A menudo PCIe 1.1 x16 PCIe 3.0 x16
Controladores para juegos Modificaciones no oficiales Oficiales
NVENC Normalmente no disponible Compatible
Conexión del monitor A través de otra GPU Directamente

La P106-100 está basada en la arquitectura Pascal de 16 nm. Cuenta con 10 multiprocesadores de streaming (SM), 80 unidades de texturas y 48 unidades de rasterización. Sus frecuencias son de 1506-1709 MHz, mientras que el ancho de banda de su memoria de 192 bits es de 192 GB/s. El consumo alcanza los 120 W y la alimentación se suministra mediante un conector de 6 pines.

Su rendimiento teórico en FP32 es de 4.375 TFLOPS, prácticamente el mismo que el de la GTX 1060 6 GB.

Por qué la P106-100 rinde peor en juegos

Al no tener salidas de vídeo, la P106-100 debe transferir los fotogramas terminados a través de PCIe hacia los gráficos integrados del procesador o hacia otra tarjeta gráfica a la que esté conectado el monitor.

En muchas unidades, la interfaz de la P106-100 funciona en modo PCIe 1.1 x16, con un ancho de banda de aproximadamente 4 GB/s. En una GTX 1060 convencional con PCIe 3.0 x16, esta cifra es de 15.75 GB/s.

Esto se traduce en tres limitaciones:

  • En juegos exigentes con un FPS bajo, las pérdidas pueden ser pequeñas.
  • En juegos ligeros con un FPS alto, la transferencia de fotogramas puede reducir notablemente el rendimiento.
  • La velocidad depende del controlador, de la configuración del PC y del método utilizado para mostrar la imagen.

Incluso con la misma potencia de GPU, el rendimiento en juegos puede variar.

Rendimiento

En 3DMark Time Spy, la P106-100 obtiene 4126 puntos, frente a los 4099 de la GTX 1060 6 GB. La diferencia es inferior al 1%.

Tarjeta gráfica Time Spy (Graphics) Steel Nomad
GeForce GTX 1660 5521 1047
NVIDIA P106-100 4126 898
GeForce GTX 1060 6 GB 4099 906
Radeon RX 570 3953 885

La GTX 1660 es aproximadamente un 34% más rápida que la P106-100 en Time Spy. La RX 570 y la GTX 1060 se encuentran en un nivel similar.

En juegos, los resultados son menos predecibles. Con controladores modificados, la P106-100 es adecuada para juegos antiguos y poco exigentes a 1920 x 1080. Los juegos modernos pueden requerir ajustes bajos o no iniciarse en absoluto.

No dispone de trazado de rayos por hardware ni de DLSS. En los juegos compatibles están disponibles FSR y algunos modos de XeSS.

CUDA y redes neuronales

La P106-100 es compatible con CUDA Compute Capability 6.1. En Blender obtiene alrededor de 391 puntos, frente a los 802 de la Tesla P40. Esto es suficiente para renderizado sencillo y experimentos.

Con las redes neuronales la situación es más complicada:

  • No tiene núcleos Tensor, y el rendimiento en FP16 es de 1/64 del de FP32.
  • En sus 6 GB de memoria caben LLM pequeñas. Los modelos de 7-8 mil millones de parámetros requieren una cuantización agresiva y un contexto limitado.
  • CUDA Toolkit 13.0 ya no admite la compilación para Pascal. Para compilar programas será necesario utilizar CUDA 12.x.

La tarjeta es adecuada para aplicaciones CUDA antiguas y tareas educativas. Para las LLM locales modernas, su uso está limitado por la memoria, la velocidad y un soporte de software que se reduce gradualmente.

Controladores y compatibilidad

Para jugar con la P106-100 se necesitan controladores modificados. Su instalación puede requerir pasos adicionales relacionados con la firma digital y la configuración de la salida de imagen.

En octubre de 2025, NVIDIA dejó de publicar controladores Game Ready para Pascal. Las GeForce compatibles reciben actualizaciones de seguridad hasta octubre de 2028, pero estas garantías no se aplican automáticamente a la P106-100 destinada a minería.

Por lo general, NVENC no está disponible, por lo que no conviene contar con la codificación de vídeo por hardware sin comprobar la tarjeta concreta.

¿Vale la pena comprar una P106-100 en 2026?

Por $20-30, la P106-100 puede tener sentido como acelerador CUDA barato o tarjeta para experimentar. Para jugar será necesario contar con una configuración compatible y ajustar los controladores.

Por $40-50, la compra no resulta rentable. Una GTX 1060 6 GB por $50-70 tiene salidas de vídeo, controladores oficiales y no requiere soluciones alternativas. La GTX 1660, por $90-100, ofrece aproximadamente un tercio más de rendimiento en Time Spy.

Antes de comprarla, conviene comprobar la memoria, la refrigeración y la estabilidad bajo carga. La P106-100 fue diseñada originalmente para funcionar durante largos periodos en minería, por lo que el estado de cada unidad concreta es más importante que su antigüedad.

Para un PC gaming convencional, es preferible la GTX 1060. La P106-100 solo merece la pena por su bajo precio y si se está dispuesto a resolver por cuenta propia los problemas de compatibilidad.

Comparación de GPU

Comparar P106 100 con otros GPUs

Seleccione GPU de la lista desplegable.

Básico

Nombre de Etiqueta
NVIDIA
Plataforma
Desktop
Fecha de Lanzamiento
June 2017
Nombre del modelo
P106 100
Generación
Mining GPUs
Reloj base
1506MHz
Reloj de impulso
1709MHz
Interfaz de bus
PCIe 1.1 x16
Transistores
4,400 million
TMUs
Las unidades de mapeo de texturas (TMUs) funcionan como componentes de la GPU, capaces de rotar, escalar y distorsionar imágenes binarias, para luego colocarlas como texturas sobre cualquier plano de un modelo 3D dado. Este proceso se llama mapeo de texturas.
80
Fundición
TSMC
Tamaño proceso
16 nm
Arquitectura
Pascal

Especificaciones de Memoria

Tamaño de memoria
6GB
Tipo de memoria
GDDR5
Bus de memoria
La anchura del bus de memoria se refiere al número de bits de datos que la memoria de video puede transferir en un solo ciclo de reloj. Cuanto mayor sea la anchura del bus, mayor será la cantidad de datos que se pueden transmitir instantáneamente, lo que lo convierte en uno de los parámetros cruciales de la memoria de video. El ancho de banda de memoria se calcula como: Ancho de banda de memoria = Frecuencia de memoria x Anchura de bus de memoria / 8. Por lo tanto, cuando las frecuencias de memoria son similares, la anchura del bus de memoria determinará el tamaño del ancho de banda de memoria.
192bit
Reloj de memoria
2002MHz
Ancho de banda
La "ancho de banda de memoria" se refiere a la tasa de transferencia de datos entre el chip gráfico y la memoria de video. Se mide en bytes por segundo, y la fórmula para calcularlo es: ancho de banda de memoria = frecuencia de trabajo × ancho de bus de memoria / 8 bits.
192.2 GB/s

Pantalla y multimedia

Salidas
No outputs

Rendimiento teórico

Tasa de píxeles
La tasa de llenado de píxeles se refiere al número de píxeles que una unidad de procesamiento gráfico (GPU) puede renderizar por segundo, medida en MPíxeles/s (millones de píxeles por segundo) o GPíxeles/s (miles de millones de píxeles por segundo). Es la métrica más comúnmente utilizada para evaluar el rendimiento de procesamiento de píxeles de una tarjeta gráfica.
82.03 GPixel/s
Tasa de texturas
La tasa de llenado de texturas se refiere al número de elementos del mapa de textura (texels) que una GPU puede asignar a píxeles en un solo segundo.
136.7 GTexel/s
FP16 (mitad)
Una métrica importante para medir el rendimiento de la GPU es la capacidad de cómputo de punto flotante. Los números de punto flotante de media precisión (16 bits) se utilizan para aplicaciones como el aprendizaje automático, donde se acepta una menor precisión. Los números de punto flotante de precisión simple (32 bits) se utilizan para tareas comunes de procesamiento multimedia y gráfico, mientras que los números de punto flotante de doble precisión (64 bits) son necesarios para la computación científica que requiere un amplio rango numérico y alta precisión.
68.36 GFLOPS
FP64 (doble)
Una métrica importante para medir el rendimiento de la GPU es la capacidad de cómputo de punto flotante. Los números de punto flotante de media precisión (16 bits) se utilizan para aplicaciones como el aprendizaje automático, donde se acepta una menor precisión. Los números de punto flotante de precisión simple (32 bits) se utilizan para tareas comunes de procesamiento multimedia y gráfico, mientras que los números de punto flotante de doble precisión (64 bits) son necesarios para la computación científica que requiere un amplio rango numérico y alta precisión.
136.7 GFLOPS
FP32 (flotante)
Una métrica importante para medir el rendimiento de la GPU es la capacidad de cómputo de punto flotante. Los números de punto flotante de media precisión (16 bits) se utilizan para aplicaciones como el aprendizaje automático, donde se acepta una menor precisión. Los números de punto flotante de precisión simple (32 bits) se utilizan para tareas comunes de procesamiento multimedia y gráfico, mientras que los números de punto flotante de doble precisión (64 bits) son necesarios para la computación científica que requiere un amplio rango numérico y alta precisión.
4.375 TFLOPS

Misceláneos

Cuenta de SM
Múltiples Procesadores de Transmisión (SP), junto con otros recursos, forman un Multiprocesador de Transmisión (SM), que también se conoce como el núcleo principal de una GPU. Estos recursos adicionales incluyen componentes como planificadores de bloques, registros y memoria compartida. El SM puede considerarse como el corazón de la GPU, similar a un núcleo de CPU, donde los registros y la memoria compartida son recursos escasos dentro del SM.
10
Unidades de sombreado
La unidad de procesamiento más fundamental es el Procesador de Secuencias (SP), donde se ejecutan instrucciones y tareas específicas. Las GPU realizan cómputo paralelo, lo que significa que varios SP trabajan simultáneamente para procesar tareas.
1280
Caché L1
48 KB (per SM)
Caché L2
1536KB
TDP
120W
Vulkan Versión
Vulkan es una API de gráficos y computación multiplataforma de Khronos Group, ofrece alto rendimiento y bajo consumo de CPU. Permite a los desarrolladores controlar la GPU directamente, reduce el overhead de renderización y soporta multi-threading y procesadores multi-núcleo.
1.4
OpenCL Versión
3.0
OpenGL
4.6
CUDA
6.1
DirectX
12 (12_1)
Conectores de alimentación
1x 6-pin
ROPs
La tubería de operaciones raster (ROPs) es principalmente responsable de manejar los cálculos de iluminación y reflexión en los juegos, así como de administrar efectos como el anti-aliasing (AA), alta resolución, humo y fuego. Cuanto más exigentes sean el anti-aliasing y los efectos de iluminación en un juego, mayores serán los requisitos de rendimiento para los ROPs; de lo contrario, puede resultar en una caída brusca en la velocidad de fotogramas.
48
Modelo de sombreado
6.8
PSU sugerida
300W

Clasificaciones

FP32 (flotante)
Puntaje
4.375 TFLOPS
3DMark Steel Nomad
Puntaje
898
3DMark Time Spy
Puntaje
4126
Blender
Puntaje
391
Vulkan
Puntaje
31357
OpenCL
Puntaje
34533
Hashcat
Puntaje
175982 H/s

Comparado con Otras GPU

FP32 (flotante) / TFLOPS
4.762 +8.8%
A2
4.622 +5.6%
4.375
3DMark Time Spy
7479 +81.3%
5521 +33.8%
4126
2049 -50.3%
3DMark Steel Nomad
951 +5.9%
898
885 -1.4%
849 -5.5%
Blender
1399.99 +258.1%
802 +105.1%
391
191.62 -51%
53.65 -86.3%
Vulkan
79178 +152.5%
52494 +67.4%
31357
16654 -46.9%
9056 -71.1%
OpenCL
69550 +101.4%
52079 +50.8%
34533
18448 -46.6%
11820 -65.8%
Hashcat / H/s
196096 +11.4%
189947 +7.9%
175982
175296 -0.4%
161084 -8.5%