NVIDIA P106 100

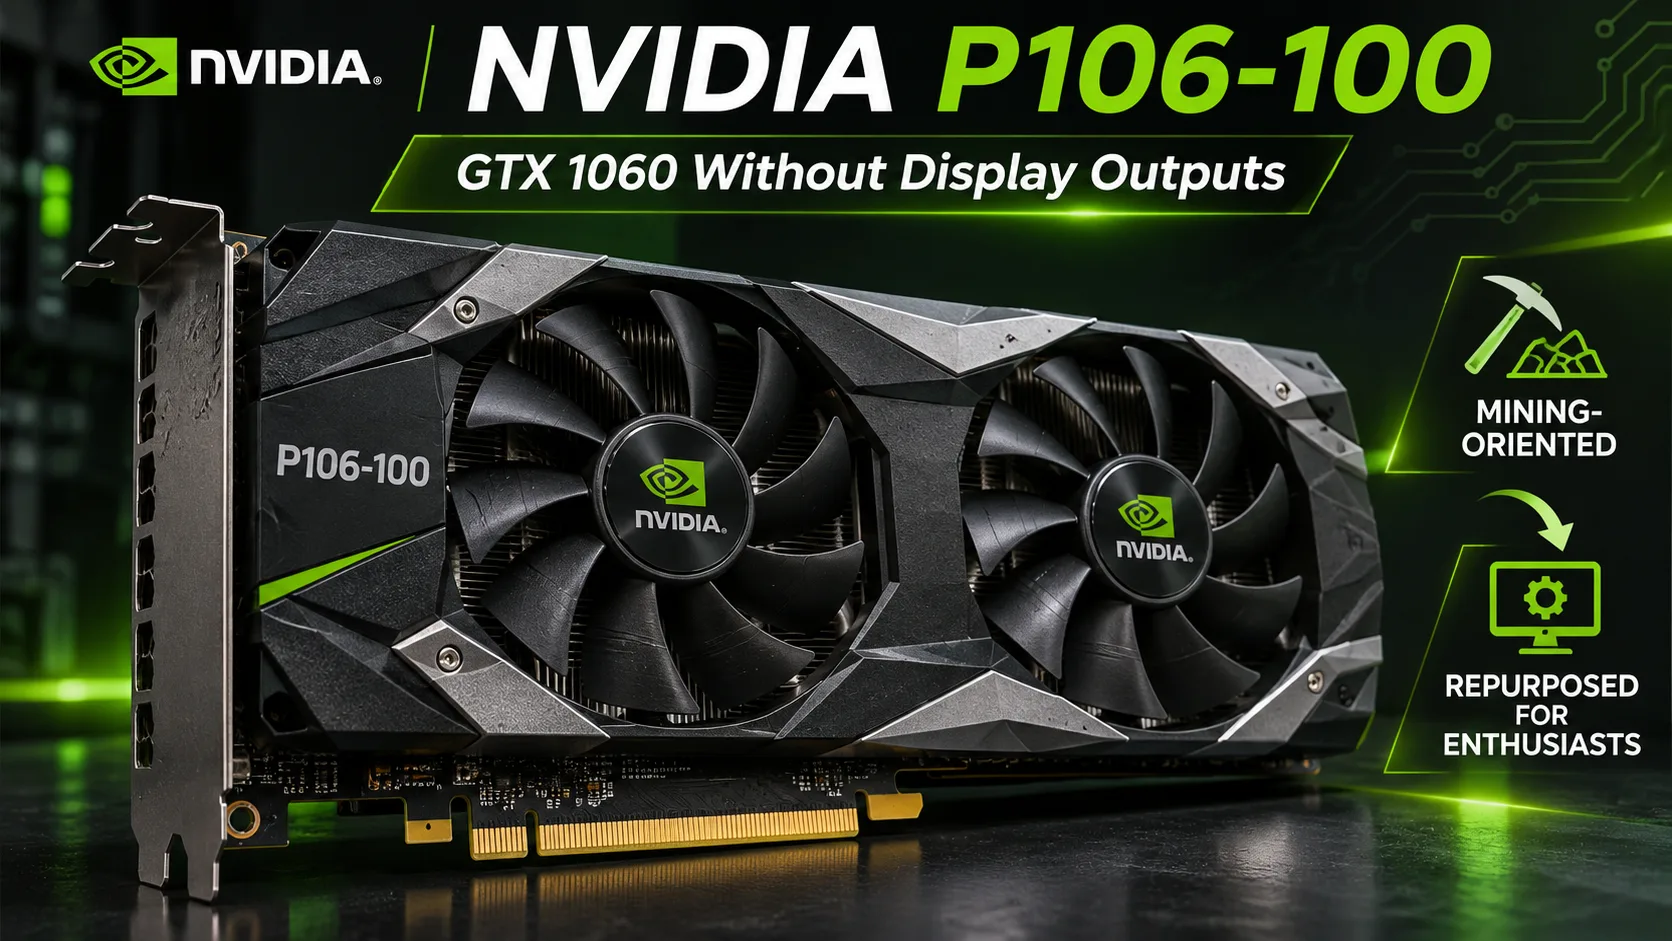
NVIDIA P106-100: GTX 1060 ohne Videoausgänge und Gaming-Treiber
Die NVIDIA P106-100 kam im Juni 2017 für das Mining von Kryptowährungen auf den Markt. Von den technischen Daten her entspricht sie fast der GeForce GTX 1060 6 GB: GP106-Grafikprozessor, 1280 CUDA-Kerne und 6 GB GDDR5. Allerdings besitzt die P106-100 keine Videoausgänge, für Gaming sind modifizierte Treiber erforderlich, und die PCIe-Schnittstelle ist bei vielen Exemplaren eingeschränkt.
Im Jahr 2026 ist die P106-100 auf dem Gebrauchtmarkt für $30-50 zu finden, während eine gewöhnliche GTX 1060 6 GB $50-70 kostet. Die Ersparnis ist gering, die Kompatibilitätsprobleme sind jedoch deutlich größer.
Unterschiede zur GTX 1060
| Merkmal | P106-100 | GTX 1060 6 GB |
|---|---|---|
| Videoausgänge | Keine | HDMI, DisplayPort, DVI |
| Schnittstelle | Häufig PCIe 1.1 x16 | PCIe 3.0 x16 |
| Gaming-Treiber | Inoffizielle Modifikationen | Offizielle Treiber |
| NVENC | Normalerweise nicht verfügbar | Unterstützt |
| Monitoranschluss | Über eine andere GPU | Direkt |
Die P106-100 basiert auf Pascals 16-nm-Architektur. Sie verfügt über 10 Streaming-Multiprozessoren (SM), 80 Textureinheiten und 48 Rastereinheiten. Die Frequenzen liegen bei 1506-1709 MHz, die Bandbreite des 192-Bit-Speichers beträgt 192 GB/s. Die Leistungsaufnahme erreicht 120 W, die Stromversorgung erfolgt über einen 6-Pin-Anschluss.
Die theoretische FP32-Leistung beträgt 4,375 TFLOPS und liegt damit praktisch auf dem Niveau der GTX 1060 6 GB.
Warum die P106-100 beim Gaming schlechter ist
Da die P106-100 keine Videoausgänge besitzt, muss sie fertige Frames über PCIe an die integrierte Grafikeinheit des Prozessors oder an eine andere Grafikkarte übertragen, an die der Monitor angeschlossen ist.
Bei vielen Exemplaren arbeitet die Schnittstelle im PCIe-1.1-x16-Modus mit einer Bandbreite von etwa 4 GB/s. Bei einer gewöhnlichen GTX 1060 mit PCIe 3.0 x16 beträgt dieser Wert 15,75 GB/s.
Daraus ergeben sich drei Einschränkungen:
- In anspruchsvollen Spielen mit niedriger FPS können die Verluste gering sein.
- In weniger anspruchsvollen Spielen mit hoher FPS kann die Übertragung der Frames die Leistung deutlich reduzieren.
- Die Geschwindigkeit hängt vom Treiber, der PC-Konfiguration und der Methode zur Bildausgabe ab.
Selbst bei identischer GPU-Leistung kann sich die Gaming-Performance unterscheiden.
Leistung
Im 3DMark Time Spy erreicht die P106-100 4126 Punkte gegenüber 4099 Punkten bei der GTX 1060 6 GB. Der Unterschied beträgt weniger als 1 %.
| Grafikkarte | Time Spy (Graphics) | Steel Nomad |
|---|---|---|
| GeForce GTX 1660 | 5521 | 1047 |
| NVIDIA P106-100 | 4126 | 898 |
| GeForce GTX 1060 6 GB | 4099 | 906 |
| Radeon RX 570 | 3953 | 885 |
Die GTX 1660 ist im Time Spy etwa 34 % schneller als die P106-100. RX 570 und GTX 1060 liegen auf einem ähnlichen Niveau.
In Spielen sind die Ergebnisse weniger vorhersehbar. Mit modifizierten Treibern eignet sich die P106-100 für ältere und weniger anspruchsvolle Spiele in 1920 × 1080. Moderne Spiele können niedrige Einstellungen erfordern oder überhaupt nicht starten.
Hardware-Raytracing und DLSS fehlen. In unterstützten Spielen stehen FSR und einige XeSS-Modi zur Verfügung.
CUDA und neuronale Netze
Die P106-100 unterstützt CUDA Compute Capability 6.1. In Blender erreicht sie etwa 391 Punkte gegenüber 802 Punkten bei der Tesla P40. Für einfaches Rendering und Experimente ist das ausreichend.
Bei neuronalen Netzen ist die Situation schwieriger:
- Tensor-Kerne fehlen, die FP16-Leistung beträgt 1/64 der FP32-Leistung.
- In den 6 GB Speicher passen kleine LLMs. Modelle mit 7-8 Milliarden Parametern erfordern eine starke Quantisierung und einen begrenzten Kontext.
- Das CUDA Toolkit 13.0 unterstützt die Kompilierung für Pascal nicht mehr. Für die Erstellung von Programmen wird CUDA 12.x benötigt.
Die Karte eignet sich für ältere CUDA-Anwendungen und Lernaufgaben. Für moderne lokale LLMs sind Speicher, Geschwindigkeit und die zunehmend eingeschränkte Softwareunterstützung limitierende Faktoren.
Treiber und Kompatibilität
Für Spiele werden auf der P106-100 modifizierte Treiber benötigt. Ihre Installation kann zusätzliche Schritte bei der digitalen Signatur und der Einrichtung der Bildausgabe erfordern.
Im Oktober 2025 stellte NVIDIA die Veröffentlichung von Game-Ready-Treibern für Pascal ein. Unterstützte GeForce-Karten erhalten bis Oktober 2028 Sicherheitsupdates, doch diese Zusagen gelten nicht automatisch für die Mining-Karte P106-100.
NVENC ist normalerweise nicht verfügbar. Daher sollte man ohne Prüfung des konkreten Kartenmodells nicht mit hardwarebeschleunigter Videokodierung rechnen.
Lohnt sich der Kauf einer P106-100 im Jahr 2026?
Für $20-30 kann die P106-100 als günstiger CUDA-Beschleuniger oder für Experimente sinnvoll sein. Für Spiele sind eine kompatible Konfiguration und eine Anpassung der Treiber erforderlich.
Für $40-50 lohnt sich der Kauf nicht. Eine GTX 1060 6 GB für $50-70 verfügt über Videoausgänge, offizielle Treiber und benötigt keine Umgehungslösungen. Eine GTX 1660 für $90-100 bietet im Time Spy eine etwa um ein Drittel höhere Leistung.
Vor dem Kauf sollten Speicher, Kühlung und Stabilität unter Last geprüft werden. Die P106-100 war ursprünglich für den Dauerbetrieb beim Mining vorgesehen, daher ist der Zustand des konkreten Exemplars wichtiger als sein Alter.
Für einen gewöhnlichen Gaming-PC ist die GTX 1060 die bessere Wahl. Die P106-100 lohnt sich nur wegen ihres niedrigen Preises und wenn man bereit ist, Kompatibilitätsprobleme selbst zu lösen.
GPU-Vergleich
P106 100 mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs

In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/de/gpu/nvidia-p106-100" target="_blank">NVIDIA P106 100</a>