NVIDIA GeForce RTX 5080

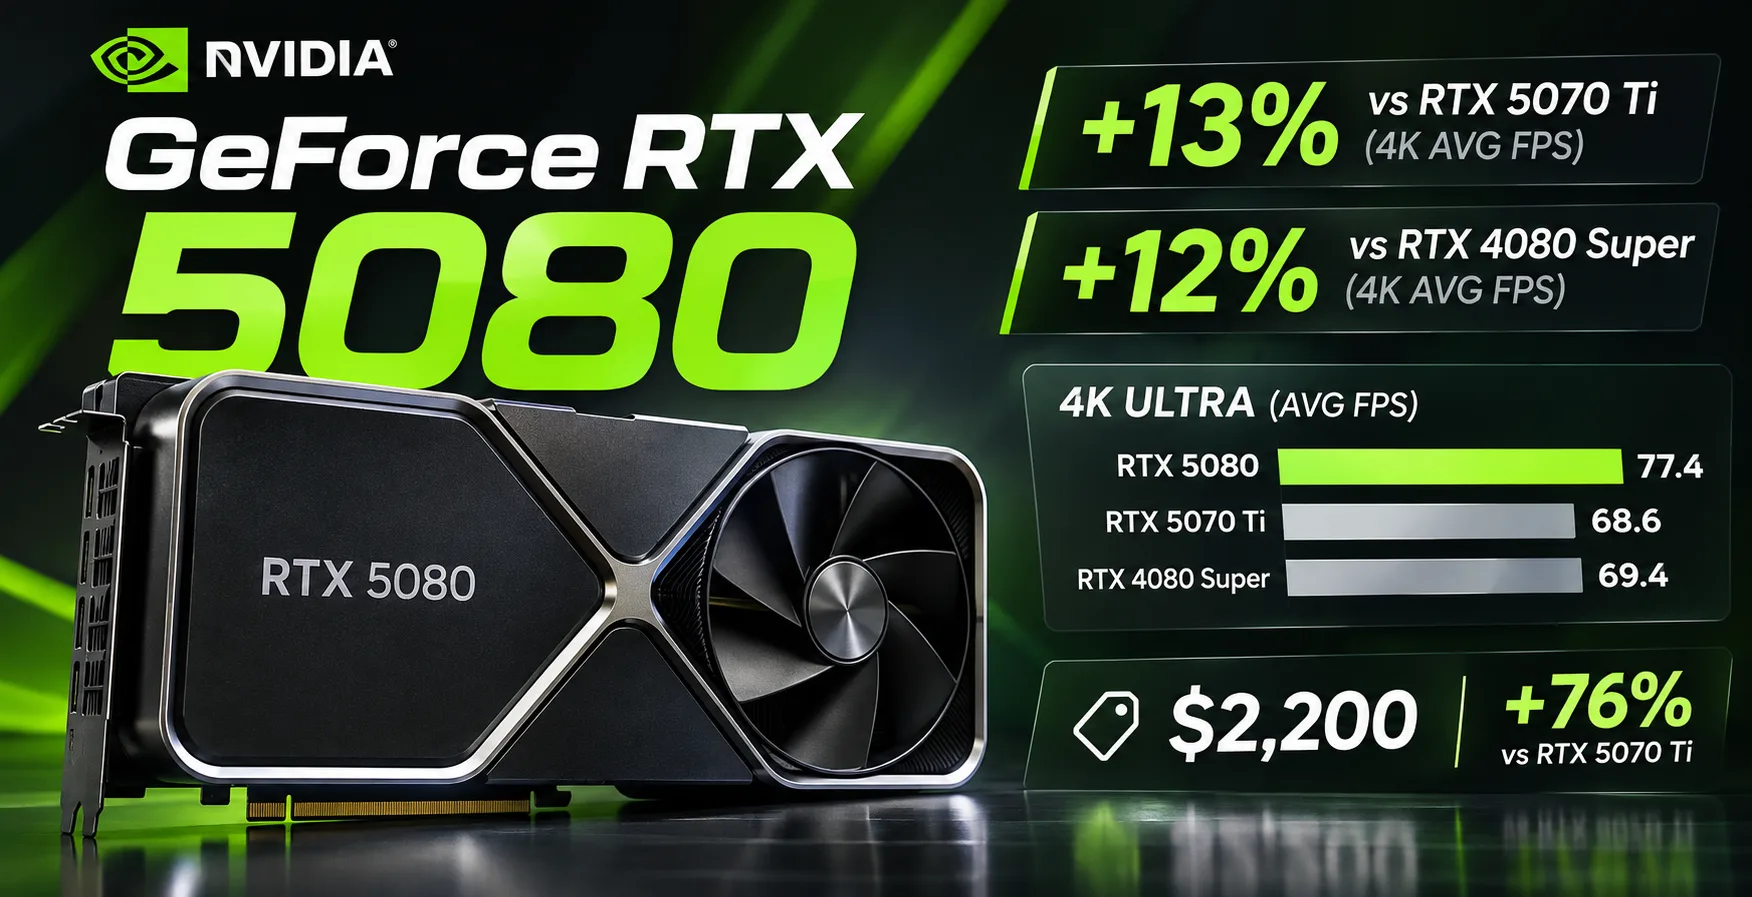
GeForce RTX 5080: un 13% más rápida que la RTX 5070 Ti en 4K, pero un 76% más cara
La GeForce RTX 5080 salió a la venta en enero de 2025 por $999, pero para octubre de 2026 el precio mínimo de las ofertas disponibles en Estados Unidos había alcanzado los $2200. Mientras tanto, la RTX 5070 Ti, con un precio de $1250, queda de media solo un 13% por detrás en frecuencia de fotogramas en 4K. La diferencia de precio es de $950, aunque ambas tarjetas tienen 16 GB de memoria de vídeo y son compatibles con DLSS Multi Frame Generation.
La mejora respecto a la RTX 4080 Super también resultó modesta. Según las pruebas de Tom's Hardware, la RTX 5080 es aproximadamente un 12% más rápida que su predecesora en 4K sin trazado de rayos. Su ventaja más notable frente a la RTX 5070 Ti aparece en los juegos con trazado de rayos exigente, pero ni siquiera ahí el aumento de rendimiento justifica la diferencia de precio.
Blackwell y GDDR7: qué ha cambiado
La RTX 5080 está construida alrededor de la GPU GB203, con 10 752 núcleos CUDA. Utiliza memoria GDDR7 con un ancho de banda de 960 GB/s, en lugar de la GDDR6X de la RTX 4080 Super. El ancho de banda ha aumentado un 30%, pero la cantidad de memoria sigue siendo la misma.
| Característica | RTX 5080 | RTX 4080 Super | RTX 5070 Ti |
|---|---|---|---|
| Arquitectura | Blackwell | Ada Lovelace | Blackwell |
| Núcleos CUDA | 10 752 | 10 240 | 8 960 |
| Memoria | 16 GB GDDR7 | 16 GB GDDR6X | 16 GB GDDR7 |
| Ancho de banda | 960 GB/s | 736 GB/s | 896 GB/s |
| Frecuencia Boost | 2617 MHz | 2550 MHz | 2452 MHz |
| TGP | 360 W | 320 W | 300 W |
La RTX 5080 incorpora núcleos RT de cuarta generación, núcleos Tensor de quinta generación, PCIe 5.0 y DisplayPort 2.1b.
El TGP nominal ha aumentado de 320 a 360 W, aunque el consumo real depende de la carga. NVIDIA recomienda una fuente de alimentación de 850 W. Para la conexión se utiliza un cable de alimentación de 16 pines o el adaptador incluido para tres conectores de 8 pines.
3DMark Time Spy
| Tarjeta gráfica | Puntuación de gráficos |
|---|---|
| GeForce RTX 4090 | 36 676 |
| GeForce RTX 5080 | 31 987 |
| Radeon RX 9070 XT | 29 464 |
| GeForce RTX 4080 Super | 27 920 |
| GeForce RTX 5070 Ti | 27 727 |
Resultados de ComputerBase.
La RTX 5080 supera aproximadamente en un 15% a la RTX 4080 Super y a la RTX 5070 Ti, pero queda por detrás de la RTX 4090 de la generación anterior.
Pruebas en juegos: 1440p y 4K sin reescalado
Los resultados agregados de Tom's Hardware de junio de 2026 permiten comparar las tarjetas gráficas sin DLSS, FSR ni generación de fotogramas.
| Tarjeta gráfica | 1440p Ultra | 4K Ultra | 4K con RT |
|---|---|---|---|
| RTX 4090 | 143,4 | 89,1 | 52,2 |
| RTX 5080 | 128,3 | 77,4 | 42,1 |
| RTX 4080 Super | 118,6 | 69,4 | 38,5 |
| RTX 5070 Ti | 116,8 | 68,6 | 36,7 |
| Radeon RX 9070 XT | 116,5 | 65,8 | 30,1 |
FPS medios. La rasterización y el trazado de rayos se midieron en conjuntos de juegos independientes.
En 1440p, la RTX 5080 es un 10% más rápida que la RTX 5070 Ti; en 4K, la ventaja aumenta hasta el 13%. La RTX 4080 Super queda aproximadamente un 12% por detrás de la nueva tarjeta en 4K, mientras que la RTX 4090 mantiene el liderazgo.
Con trazado de rayos, la ventaja de la RTX 5080 sobre la RTX 5070 Ti alcanza el 15%, y sobre la Radeon RX 9070 XT, el 40%. Sin embargo, los 42 FPS medios en 4K con RT indican que para obtener una frecuencia de fotogramas más alta será necesario utilizar reescalado o reducir la configuración gráfica.
Death Stranding 2: comparación con DLSS y FSR
En las pruebas de ComputerBase de marzo de 2026 se utilizaron ajustes gráficos muy altos, DLSS 4 Quality para NVIDIA y FSR 4.1 Quality para la Radeon RX 9000. La generación de fotogramas estaba desactivada.
| Tarjeta gráfica | 1440p | 4K | 4K con RT |
|---|---|---|---|
| RTX 4090 | 124,8 | 105,5 | 65,5 |
| RTX 5080 | 125,8 | 96,4 | 57,0 |
| RTX 4080 Super | 104,1 | 82,3 | 49,2 |
| RTX 5070 Ti | 110,4 | 84,6 | 49,2 |
| Radeon RX 9070 XT | 106,9 | 79,0 | 41,2 |
FPS medios. En el modo RT se utiliza el trazado de rayos al máximo. La calidad de imagen con DLSS y FSR puede variar.
La RTX 5080 es un 14% más rápida que la RTX 5070 Ti en 4K y un 16% más rápida con trazado de rayos. La RTX 4090 mantiene el liderazgo en 4K, aunque en 1440p queda ligeramente por detrás de la nueva tarjeta.
Precio: cuánto cuesta el rendimiento adicional
Según un estudio de TechSpot publicado el 2 de noviembre de 2026, los precios mínimos de las tarjetas gráficas disponibles en las tiendas estadounidenses durante octubre fueron de $2200 para la RTX 5080, $1250 para la RTX 5070 Ti y $870 para la Radeon RX 9070 XT.
| Tarjeta gráfica | Precio en EE. UU. | FPS en 4K | Precio por FPS |
|---|---|---|---|
| RTX 5080 | $2200 | 77,4 | $28,42 |
| RTX 5070 Ti | $1250 | 68,6 | $18,22 |
| Radeon RX 9070 XT | $870 | 65,8 | $13,22 |
El precio por FPS se calcula a partir de los resultados medios en 4K Ultra sin trazado de rayos. Esta métrica se utiliza únicamente para comparar el coste del rendimiento.
Calculado por FPS, la RTX 5080 cuesta un 56% más que la RTX 5070 Ti. La Radeon RX 9070 XT ofrece alrededor del 85% del rendimiento de la RTX 5080 por un precio 2,5 veces menor.
La RTX 5070 Ti también ha subido considerablemente de precio respecto a los $749 recomendados, pero sigue siendo una compra más rentable que la RTX 5080.
DLSS y trazado de rayos
La RTX 5080 es compatible con DLSS Multi Frame Generation, que crea fotogramas adicionales entre los calculados por el motor del juego. La tecnología mejora la fluidez visual, pero no proporciona una mejora proporcional en la respuesta de los controles.
La RTX 5070 Ti también es compatible con la misma tecnología. La ventaja de la RTX 5080 está en su mayor frecuencia de fotogramas inicial, especialmente en los juegos con path tracing. Para los propietarios de monitores 4K con una alta frecuencia de actualización, esta diferencia puede ser importante, aunque incluso la RTX 5080 no siempre permite prescindir del reescalado en los juegos más exigentes.
Blender, edición de vídeo e inteligencia artificial
La RTX 5080 es compatible con CUDA, OptiX y la codificación de vídeo por hardware AV1. Sus dos codificadores NVENC de novena generación permiten acelerar el procesamiento de formatos de vídeo compatibles, incluido HEVC de 10 bits 4:2:2.
En las pruebas de Puget Systems, los resultados de Blender Benchmark son los siguientes:
| Tarjeta gráfica | Blender Benchmark |
|---|---|
| RTX 5090 | 15 872 |
| RTX 5080 | 9 035 |
| RTX 5070 Ti | 7 882 |
| Radeon RX 9070 XT | 3 722 |
La RTX 5080 es un 15% más rápida que la RTX 5070 Ti. La Radeon RX 9070 XT queda muy por detrás en el renderizado mediante HIP, por lo que los aceleradores de NVIDIA son preferibles para trabajar habitualmente con Blender.
Para la inteligencia artificial local, la RTX 5080 está limitada por sus 16 GB de memoria de vídeo. Por ejemplo, un modelo de lenguaje de 32 000 millones de parámetros con cuantización de 4 bits normalmente no cabe por completo en esa capacidad si se tienen en cuenta los datos auxiliares y la caché KV. Los requisitos exactos dependen del formato de cuantización y del tamaño del contexto.
Si el modelo cabe en la VRAM, la RTX 5080 ofrece una alta velocidad de cálculo. Para los modelos más grandes, una mayor cantidad de memoria de vídeo suele ser más útil que una GPU más potente.
¿Merece la pena comprar la GeForce RTX 5080 en 2026?
Con un precio de $2200, resulta difícil recomendar la RTX 5080 para jugar de forma habitual. La RTX 5070 Ti cuesta $950 menos, tiene los mismos 16 GB de memoria y queda de media solo un 13% por detrás en FPS en 4K. La Radeon RX 9070 XT ofrece aún mejor relación calidad-precio si no se necesita un alto rendimiento con trazado de rayos.
La RTX 5080 tiene sentido para jugar en 4K con efectos gráficos exigentes, trabajar con Blender y ejecutar tareas CUDA que no requieran más de 16 GB de memoria de vídeo. Los propietarios de una RTX 4080 Super no deberían actualizar: el aumento de aproximadamente un 12% en 4K es demasiado pequeño para justificar un cambio tan caro.
Comparación de GPU
Comparar GeForce RTX 5080 con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
3x DisplayPort 2.1b
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Comparaciones de GPU relacionadas


Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/es/gpu/nvidia-geforce-rtx-5080" target="_blank">NVIDIA GeForce RTX 5080</a>