NVIDIA T1000
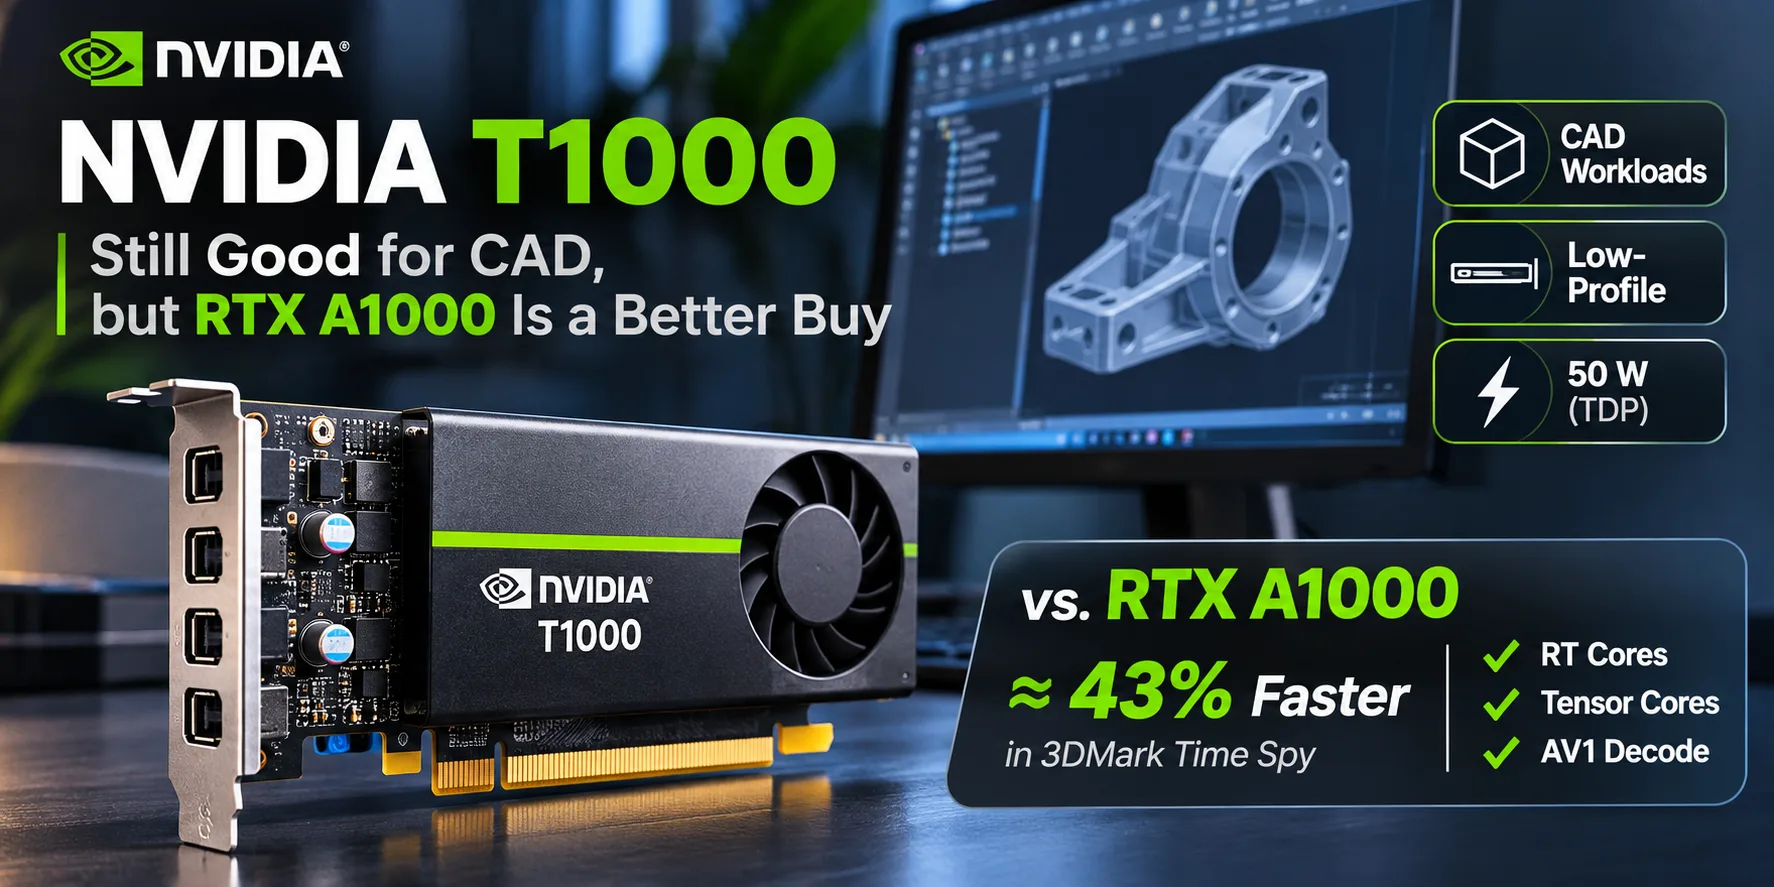
NVIDIA T1000: ainda serve para CAD, mas a RTX A1000 é mais vantajosa
A NVIDIA T1000 é uma placa de vídeo profissional de 2021 para estações de trabalho compactas. Ela usa o mesmo chip TU117 da GeForce GTX 1650. No entanto, a T1000 não foi projetada para jogos, e sim para trabalhar com aplicações CAD: há drivers profissionais disponíveis para ela e certificação para determinadas versões de software de engenharia. A placa ocupa um único slot, consome até 50 W e dispensa alimentação adicional. A principal questão hoje é: vale a pena comprá-la nova quando existe a RTX A1000?
| Modelo | Núcleos CUDA | Largura de banda | Núcleos RT / Tensor | Decodificação AV1 |
|---|---|---|---|---|
| NVIDIA T1000 8 GB | 896 | 160 GB/s | Não / não | Não |
| NVIDIA RTX A1000 8 GB | 2304 | 192 GB/s | 18 / 72 | Sim |
Para quais tarefas a T1000 é adequada
A T1000 é oferecida com 4 e 8 GB de GDDR6 em um barramento de 128 bits. As duas versões têm os mesmos 896 núcleos CUDA, desempenho FP32 de até 2,5 TFLOPS e interface PCIe 3.0 x16. A placa de baixo perfil e slot único conta com quatro Mini DisplayPort 1.4, permitindo conectar quatro monitores 5K a 60 Hz.
No AutoCAD, Inventor e SolidWorks, a placa é adequada para desenhos 2D, peças individuais e pequenas montagens 3D. Para modelos complexos, são importantes o tamanho do projeto, os recursos do processador e a quantidade de memória de vídeo. Por isso, entre as duas versões da T1000, é mais sensato escolher a de 8 GB: a versão de 4 GB oferece menos margem de memória. Porém, com a mesma carga na GPU, os 4 GB adicionais, por si só, não aceleram os cálculos.
A T1000 oferece suporte a CUDA e pode renderizar cenas no Blender. No entanto, o chip TU117 não possui núcleos RT nem Tensor dedicados. Em tarefas de ray tracing, ela fica consideravelmente atrás das RTX mais recentes, e DLSS e decodificação de AV1 por hardware não estão disponíveis.
Desempenho: T1000 contra RTX A1000
No 3DMark Time Spy Graphics, a RTX A1000 para desktop supera a T1000 em aproximadamente 43%. Para a comparação, foram usados resultados medianos de uma mesma base agregada, e não testes das duas placas no mesmo PC.
| Placa de vídeo | 3DMark Time Spy Graphics |
|---|---|
| NVIDIA T1000 | 3084 |
| NVIDIA RTX A1000 | 4396 |
Um teste separado da T1000 na Lenovo ThinkStation P3 Tiny, com Core i9-14900 e 64 GB de RAM, obteve 3088 pontos, um resultado próximo. Nesse benchmark, o nível de desempenho é comparável ao da Radeon 890M integrada, mas, em aplicações CAD, esse resultado não substitui testes especializados.
No Blender 3.3, na mesma ThinkStation, a cena Classroom foi renderizada em 159 segundos tanto com CUDA quanto com OptiX. Sem núcleos RT, a T1000 não obtém o ganho de desempenho em ray tracing disponível nas placas de vídeo RTX.
Nos jogos, a T1000 se aproxima da GeForce GTX 1650. A 1920 × 1080, a ThinkStation de teste obteve 45,1 FPS no Cyberpunk 2077 (Low, FSR desativado) e 82,6 FPS no F1 24 (Medium, TAA). É um nível suficiente para jogos pouco exigentes, mas não um motivo para comprar uma placa profissional em vez de uma placa para jogos.
Resultados em estações de trabalho
A StorageReview testou a T1000 em dois computadores prontos. No SPECviewperf 2020, os resultados variam conforme a aplicação:
| Estação de trabalho | CPU | GPU | SolidWorks | Siemens NX | Creo |
|---|---|---|---|---|---|
| Lenovo ThinkStation P3 Tiny | Core i7-14700 | T1000 8 GB | 39,28 | 165,51 | 42,71 |
| HP Z2 G8 Tower | Core i7-11700 | T1000 4 GB | 16,92 | 97,8 | 41,62 |
SPECviewperf 2020, pontos; quanto maior, melhor. A análise da Lenovo informa resolução do sistema de 3840 × 2160; nos testes da HP, a resolução foi de 3800 × 2120. A identidade das configurações do SPECviewperf e dos drivers não foi confirmada, portanto esta não é uma comparação direta entre as duas versões da T1000.
No Creo, os valores são quase iguais, enquanto no SolidWorks e no Siemens NX a diferença é muito maior. Além disso, há diferenças no CPU, na quantidade de memória de vídeo e, possivelmente, nas configurações do teste e nos drivers. Esses resultados não comprovam que a mudança de 4 para 8 GB proporcione um ganho correspondente. Antes de comprar uma estação de trabalho, é mais útil verificar o desempenho especificamente no pacote CAD utilizado e a certificação para sua versão.
Preços e alternativas
Nas ofertas verificadas em 11 de novembro de 2026, a PNY T1000 8 GB nova era encontrada por $449, enquanto a PNY RTX A1000 8 GB custava $550. Nos preços indicados, o adicional é de cerca de $100. Por esse valor, o comprador obtém uma GPU mais rápida, núcleos RT e Tensor dedicados e suporte à decodificação de AV1. A RTX A1000 também consome até 50 W, ocupa um único slot de baixo perfil e dispõe de quatro Mini DisplayPort.
Para outras tarefas, há alternativas possíveis:
- Intel Arc Pro B50 16 GB - oferece o dobro de memória de vídeo, consumo de 70 W e formato de baixo perfil, mas a placa ocupa dois slots. Na oferta verificada na Newegg, ela custa cerca de $700, portanto não é mais barata que a RTX A1000. Vale escolhê-la pelos 16 GB e quando houver confirmação do suporte ao software necessário.
- GeForce RTX 3050 6 GB - opção para gráficos convencionais, jogos e CUDA quando não há exigência de drivers profissionais certificados. Algumas versões de baixo perfil ocupam dois slots.
- Radeon 890M - solução gráfica integrada de nível próximo no Time Spy. Para trabalho de escritório e gráficos pouco exigentes, uma T1000 dedicada pode não ser necessária, mas os resultados em aplicações CAD e o suporte dos drivers serão diferentes.
Conclusão
A T1000 continua adequada para estações de trabalho compactas que precisam de um único slot, quatro saídas de vídeo e drivers profissionais. Em projetos 2D e pequenas montagens 3D, ela continua sendo uma solução viável; ao escolher entre as duas versões, a de 8 GB é preferível.
É difícil recomendar uma T1000 nova por $449 quando há uma RTX A1000 por $550. Nos resultados apresentados do Time Spy, a última é aproximadamente 43% mais rápida e mais adequada para renderização pela GPU, sem exigir espaço ou potência adicionais. A compra da T1000 se justifica quando uma configuração específica da estação de trabalho é consideravelmente mais barata ou quando sua compatibilidade já foi verificada e tem prioridade sobre o desempenho.
Comparação de GPU
Comparar T1000 com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Comparações de GPU relacionadas

Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/pt/gpu/nvidia-t1000" target="_blank">NVIDIA T1000</a>