NVIDIA T1000

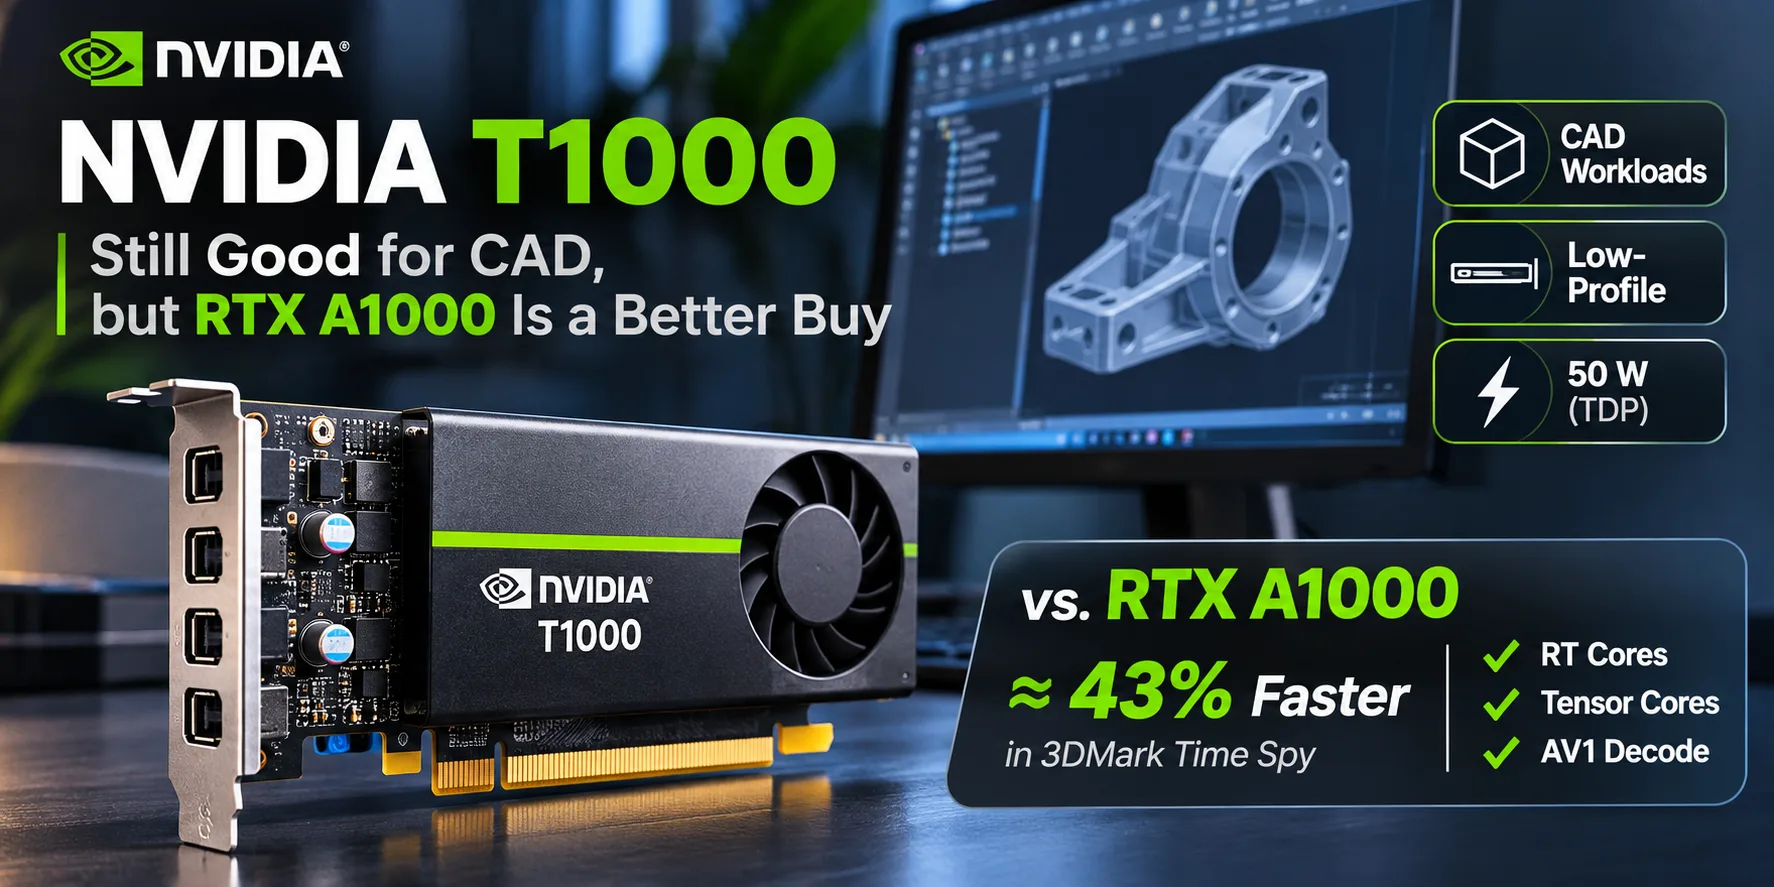
NVIDIA T1000:CADにはまだ使えるが、RTX A1000のほうが割安
NVIDIA T1000は、2021年に登場したコンパクトワークステーション向けのプロフェッショナルGPUだ。GeForce GTX 1650と同じTU117チップを採用している。ただし、T1000はゲームではなくCADアプリケーションでの利用を想定しており、プロフェッショナルドライバーや、特定バージョンのエンジニアリングソフトウェア向け認証を利用できる。カードは1スロットで、消費電力は最大50 W、補助電源も必要ない。現在の主な問題は、RTX A1000が存在するなかで、T1000を新品で購入する価値があるかどうかだ。
| モデル | CUDAコア | 帯域幅 | RT / Tensorコア | AV1デコード |
|---|---|---|---|---|
| NVIDIA T1000 8 GB | 896 | 160 GB/s | なし / なし | なし |
| NVIDIA RTX A1000 8 GB | 2304 | 192 GB/s | 18 / 72 | あり |
T1000に適した用途
T1000には、128-bitバスの4 GB版と8 GB版のGDDR6が用意されている。どちらも896基のCUDAコア、最大2.5 TFLOPSのFP32性能、PCIe 3.0 x16インターフェースを備える。ロープロファイルの1スロット基板には4基のMini DisplayPort 1.4が搭載されており、5K・60 Hzのモニターを4台接続できる。
AutoCAD、Inventor、SolidWorksでは、2D図面、個別の部品、小規模な3Dアセンブリに適している。複雑なモデルでは、プロジェクトのサイズ、CPUの性能、ビデオメモリ容量が重要になる。そのため、T1000の2モデルから選ぶなら、メモリ容量に余裕のある8 GB版のほうが合理的だ。ただし、GPU負荷が同じであれば、4 GB多いこと自体が計算を高速化するわけではない。
T1000はCUDAをサポートしており、Blenderでシーンをレンダリングできる。ただし、TU117チップにはハードウェアRTコアとTensorコアがない。レイトレーシングの処理では新しいRTXシリーズに大きく劣り、DLSSとハードウェアAV1デコードも利用できない。
性能:T1000対RTX A1000
3DMark Time Spy Graphicsでは、デスクトップ向けRTX A1000がT1000を約43%上回る。比較には、同じPCで2枚のカードをテストした結果ではなく、1つの集計データベースの中央値を使用している。
| ビデオカード | 3DMark Time Spy Graphics |
|---|---|
| NVIDIA T1000 | 3084 |
| NVIDIA RTX A1000 | 4396 |
Core i9-14900と64 GB RAMを搭載したLenovo ThinkStation P3 TinyでT1000を個別にテストしたところ、3088ポイントという近い結果になった。このベンチマークでの性能レベルは内蔵Radeon 890Mと同程度だが、CADアプリケーションについては、この数値だけで専用のテストを代替することはできない。
同じThinkStationでBlender 3.3のClassroomシーンをレンダリングした場合、CUDAでもOptiXでも所要時間は159秒だった。RTコアを持たないT1000では、RTXビデオカードで利用できるレイトレーシングの高速化は得られない。
ゲームでは、T1000はGeForce GTX 1650に近い性能となる。テスト用ThinkStationで1920 × 1080に設定した場合、Cyberpunk 2077では45.1 FPS(Low、FSRオフ)、F1 24では82.6 FPS(Medium、TAA)を記録した。要求の少ないゲームには十分なレベルだが、ゲーミングカードではなくプロフェッショナルカードを購入する理由にはならない。
ワークステーションでの結果
StorageReviewは、2台の完成済みPCでT1000をテストした。SPECviewperf 2020では、アプリケーションによって結果が異なっている。
| ワークステーション | CPU | GPU | SolidWorks | Siemens NX | Creo |
|---|---|---|---|---|---|
| Lenovo ThinkStation P3 Tiny | Core i7-14700 | T1000 8 GB | 39.28 | 165.51 | 42.71 |
| HP Z2 G8 Tower | Core i7-11700 | T1000 4 GB | 16.92 | 97.8 | 41.62 |
SPECviewperf 2020、ポイント。高いほど良い。Lenovoのレビューではシステム解像度が3840 × 2160、HPのテストでは3800 × 2120と記載されている。SPECviewperfの設定とドライバーが同一であることは確認されていないため、T1000の2モデルを直接比較した結果ではない。
Creoでは数値がほぼ一致している一方、SolidWorksとSiemens NXでは大きな差が出ている。CPU、ビデオメモリ容量、さらにテスト設定やドライバーも異なる可能性がある。これらの結果から、4 GBから8 GBに増やせば同等の性能向上が得られるとは証明できない。ワークステーションを購入する前に、使用するCADパッケージでの速度と、そのバージョンの認証を確認するほうが有用だ。
価格と代替製品
2026年11月11日に確認した販売情報では、新品のPNY T1000 8 GBが449ドル、PNY RTX A1000 8 GBが550ドルで販売されている。記載された価格では、追加負担は約100ドルだ。その金額で、購入者はより高速なGPU、ハードウェアRTコアとTensorコア、AV1デコードのサポートを得られる。RTX A1000も消費電力は最大50 Wで、1基のロープロファイルスロットを占有し、4基のMini DisplayPortを備えている。
用途によっては、次の代替製品も考えられる。
- Intel Arc Pro B50 16 GB - ビデオメモリ容量は2倍で、消費電力は70 W、ロープロファイル仕様だが、2スロット占有となる。確認したNeweggの販売価格は約700ドルで、RTX A1000より安くはない。16 GBの容量が必要で、用途に必要なソフトウェアのサポートが確認できている場合に選ぶ意味がある。
- GeForce RTX 3050 6 GB - 認証済みのプロフェッショナルドライバーを必要としない、一般的なグラフィックス、ゲーム、CUDA向けの選択肢。一部のロープロファイルモデルは2スロットを占有する。
- Radeon 890M - Time Spyでは近い水準の内蔵グラフィックス。オフィス作業や要求の少ないグラフィックス用途であれば、ディスクリートのT1000は必要ないかもしれない。ただし、CADアプリケーションでの結果とドライバーのサポートは異なる。
結論
T1000は、1スロット、4系統のビデオ出力、プロフェッショナルドライバーを必要とするコンパクトワークステーションには、今でも適している。2D設計や小規模な3Dアセンブリでは、依然として実用的な選択肢だ。2つのモデルから選ぶなら、8 GB版が望ましい。
RTX A1000が550ドルで購入できる状況では、449ドルの新品T1000を推奨するのは難しい。 ここで示したTime Spyの結果では、後者のRTX A1000が約43%高速で、追加のスペースや電力を必要とせず、GPUレンダリングにも適している。T1000を購入する理由があるのは、特定のワークステーション構成が大幅に安い場合、またはその互換性がすでに確認されており、性能よりも互換性が優先される場合だ。
GPUの比較
T1000を他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較
関連する GPU の比較

ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/ja/gpu/nvidia-t1000" target="_blank">NVIDIA T1000</a>