NVIDIA T1000

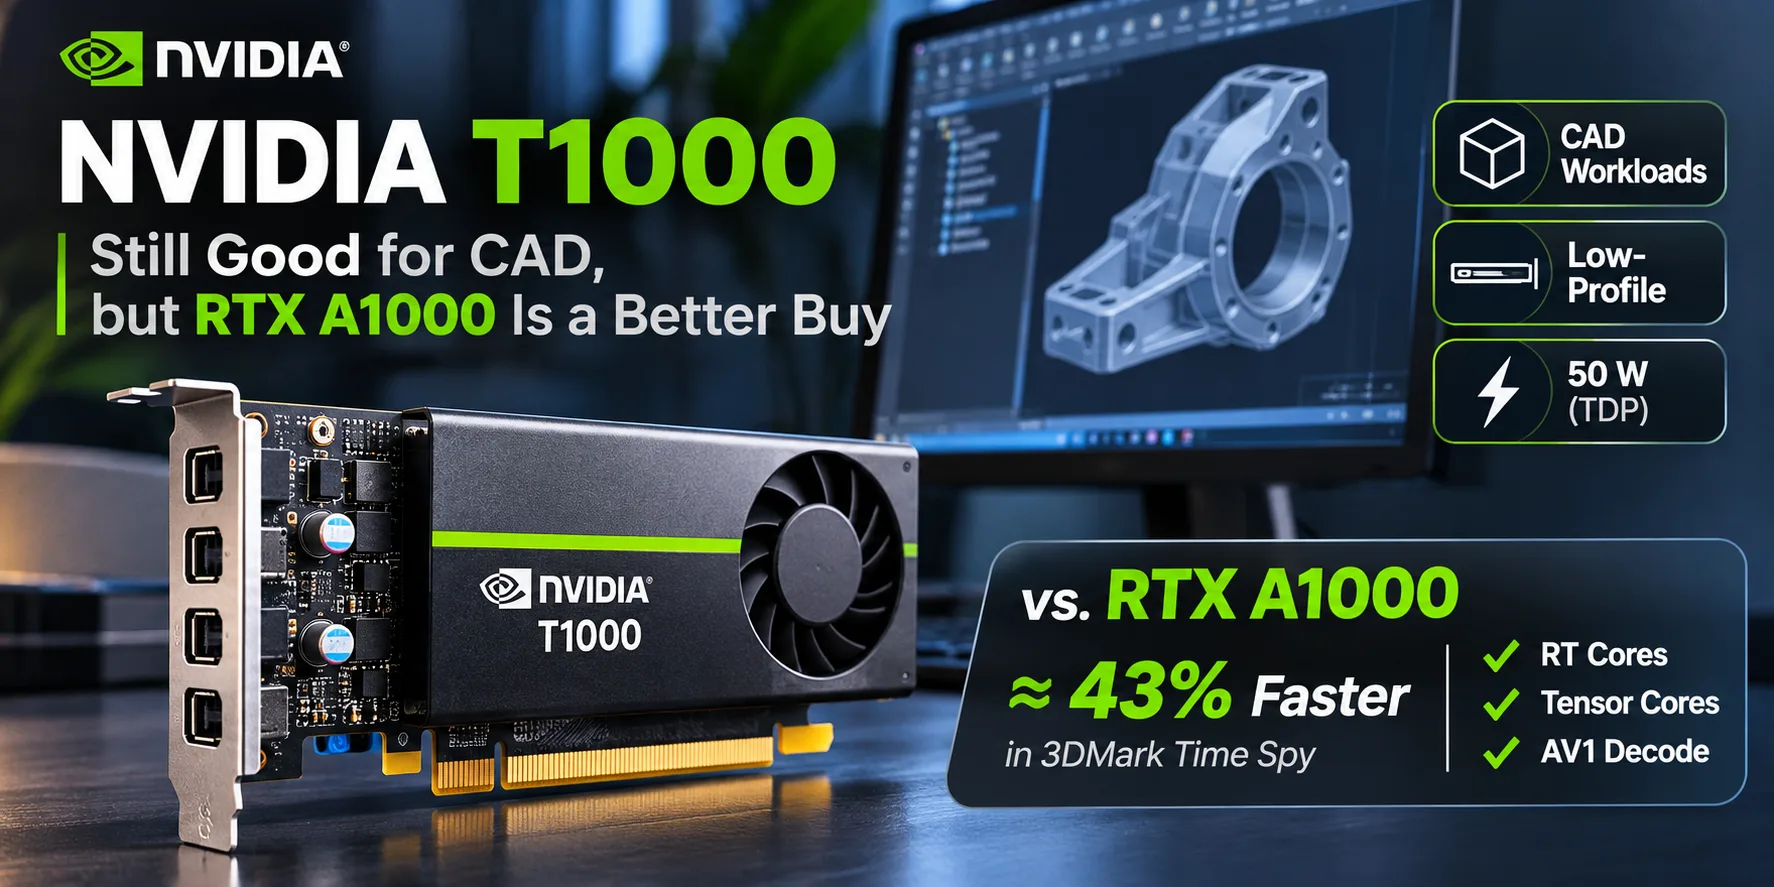
NVIDIA T1000: ancora adatta al CAD, ma RTX A1000 conviene di più
NVIDIA T1000 è una scheda video professionale del 2021 per workstation compatte. Si basa sullo stesso chip TU117 della GeForce GTX 1650. Tuttavia, la T1000 non è pensata per i giochi, bensì per lavorare con applicazioni CAD: sono disponibili driver professionali e la certificazione per specifiche versioni del software di ingegneria. La scheda occupa un solo slot, consuma fino a 50 W e non richiede alimentazione supplementare. La domanda principale oggi è: vale la pena acquistarla nuova, quando esiste la RTX A1000?
| Modello | Core CUDA | Banda passante | Core RT / Tensor | Decodifica AV1 |
|---|---|---|---|---|
| NVIDIA T1000 8 GB | 896 | 160 GB/s | No / no | No |
| NVIDIA RTX A1000 8 GB | 2304 | 192 GB/s | 18 / 72 | Sì |
Per quali attività è adatta la T1000
La T1000 è disponibile con 4 e 8 GB di GDDR6 su bus a 128 bit. Entrambe le versioni hanno gli stessi 896 core CUDA, prestazioni FP32 fino a 2,5 TFLOPS e interfaccia PCIe 3.0 x16. La scheda low-profile a singolo slot è dotata di quattro Mini DisplayPort 1.4: è possibile collegare quattro monitor 5K a 60 Hz.
In AutoCAD, Inventor e SolidWorks la scheda è adatta a disegni 2D, singoli componenti e piccoli assiemi 3D. Per i modelli complessi sono importanti le dimensioni del progetto, le capacità del processore e la quantità di memoria video. Per questo, tra le due versioni della T1000 è più ragionevole scegliere quella da 8 GB: il margine di memoria della versione da 4 GB è inferiore. Tuttavia, a parità di carico della GPU, i 4 GB aggiuntivi non accelerano di per sé i calcoli.
La T1000 supporta CUDA e può eseguire il rendering di scene in Blender. Tuttavia, il chip TU117 non dispone di core RT né di core Tensor hardware. Nei carichi di lavoro di ray tracing è nettamente più lenta delle RTX più recenti, mentre DLSS e decodifica hardware AV1 non sono disponibili.
Prestazioni: T1000 contro RTX A1000
In 3DMark Time Spy Graphics, la RTX A1000 desktop supera la T1000 di circa il 43%. Per il confronto sono stati utilizzati risultati mediani provenienti da un unico database aggregato, non test delle due schede nello stesso PC.
| Scheda video | 3DMark Time Spy Graphics |
|---|---|
| NVIDIA T1000 | 3084 |
| NVIDIA RTX A1000 | 4396 |
Un test separato della T1000 nella Lenovo ThinkStation P3 Tiny con Core i9-14900 e 64 GB di RAM ha prodotto 3088 punti, un risultato molto vicino. In questo benchmark il livello prestazionale è paragonabile a quello della Radeon 890M integrata, ma per le applicazioni CAD un simile risultato non sostituisce test specializzati.
In Blender 3.3, sulla stessa ThinkStation, la scena Classroom è stata renderizzata in 159 secondi sia utilizzando CUDA sia tramite OptiX. Senza core RT, la T1000 non beneficia dell'accelerazione nel ray tracing disponibile sulle schede video RTX.
Nei giochi, la T1000 è vicina alla GeForce GTX 1650. A 1920 × 1080, sulla ThinkStation di prova sono stati ottenuti 45,1 FPS in Cyberpunk 2077 (Low, FSR disattivato) e 82,6 FPS in F1 24 (Medium, TAA). È un livello sufficiente per i giochi non impegnativi, ma non un motivo per acquistare una scheda professionale invece di una scheda gaming.
Risultati nelle workstation
StorageReview ha testato la T1000 in due computer già assemblati. In SPECviewperf 2020, i risultati variano a seconda dell'applicazione:
| Workstation | CPU | GPU | SolidWorks | Siemens NX | Creo |
|---|---|---|---|---|---|
| Lenovo ThinkStation P3 Tiny | Core i7-14700 | T1000 8 GB | 39,28 | 165,51 | 42,71 |
| HP Z2 G8 Tower | Core i7-11700 | T1000 4 GB | 16,92 | 97,8 | 41,62 |
SPECviewperf 2020, punti; valori più alti sono migliori. Nella recensione della Lenovo è indicata una risoluzione di sistema di 3840 × 2160, mentre per i test HP è indicata 3800 × 2120. Non è stata confermata l'identità delle impostazioni di SPECviewperf e dei driver, quindi non si tratta di un confronto diretto tra le due versioni della T1000.
In Creo i valori sono quasi identici, mentre in SolidWorks e Siemens NX divergono molto di più. Inoltre, differiscono la CPU, la quantità di memoria video e, probabilmente, le impostazioni dei test e i driver. Questi risultati non dimostrano che il passaggio da 4 a 8 GB garantisca un incremento proporzionale. Prima di acquistare una workstation è più utile verificare le prestazioni proprio nel pacchetto CAD utilizzato e la certificazione per la relativa versione.
Prezzi e alternative
Nelle offerte verificate l'11 novembre 2026, la PNY T1000 8 GB nuova si trova a $449, mentre la PNY RTX A1000 8 GB costa $550. Ai prezzi indicati, il sovrapprezzo è di circa $100. In cambio, l'acquirente ottiene una GPU più veloce, core RT e Tensor hardware e il supporto alla decodifica AV1. Anche la RTX A1000, inoltre, consuma fino a 50 W, occupa un solo slot low-profile e dispone di quattro Mini DisplayPort.
Per altre attività sono possibili alcune alternative:
- Intel Arc Pro B50 16 GB: il doppio della memoria video, 70 W e formato low-profile, ma la scheda occupa due slot. Nell'offerta verificata su Newegg costa circa $700, quindi non è più economica della RTX A1000. Ha senso sceglierla per i 16 GB e se è stato confermato il supporto al software necessario.
- GeForce RTX 3050 6 GB: un'opzione per la grafica comune, i giochi e CUDA, senza il requisito di driver professionali certificati. Alcune versioni low-profile occupano due slot.
- Radeon 890M: grafica integrata di livello simile in Time Spy. Per il lavoro d'ufficio e la grafica non impegnativa potrebbe non essere necessaria una T1000 dedicata, ma i risultati nelle applicazioni CAD e il supporto dei driver saranno diversi.
Conclusioni
La T1000 è ancora adatta alle workstation compatte che richiedono un solo slot, quattro uscite video e driver professionali. Nella progettazione 2D e nei piccoli assiemi 3D rimane una soluzione adeguata; tra le due versioni è preferibile quella da 8 GB.
È difficile consigliare una T1000 nuova a $449 quando è disponibile una RTX A1000 a $550. Nei risultati riportati di Time Spy, quest'ultima è più veloce di circa il 43% e si presta meglio al rendering GPU, senza richiedere spazio o potenza aggiuntivi. L'acquisto della T1000 è giustificato se la specifica configurazione della workstation è notevolmente più economica oppure se la compatibilità con essa è già stata verificata e ha la priorità rispetto alle prestazioni.
Confronto di GPU
Confronta T1000 con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati

Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/it/gpu/nvidia-t1000" target="_blank">NVIDIA T1000</a>