NVIDIA GeForce RTX 5080

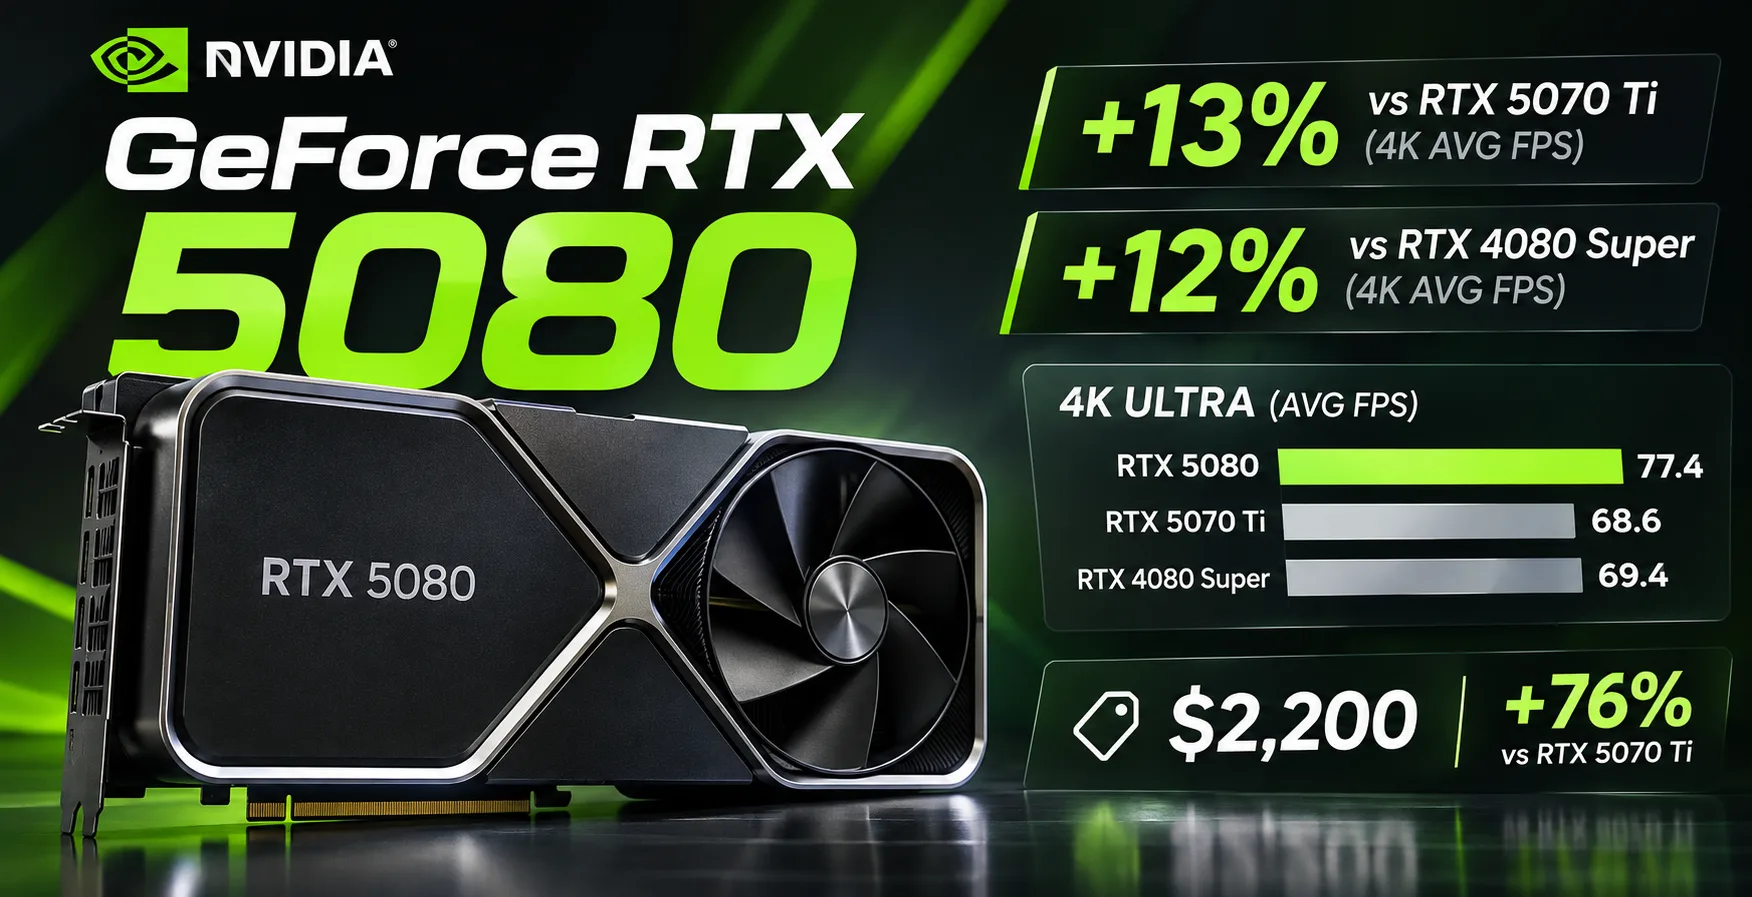
GeForce RTX 5080: il 13% più veloce della RTX 5070 Ti in 4K, ma costa il 76% in più
La GeForce RTX 5080 è uscita nel gennaio 2025 al prezzo di $999, ma entro ottobre 2026 il prezzo minimo delle offerte disponibili negli Stati Uniti ha raggiunto $2200. La RTX 5070 Ti, venduta a $1250, è in media solo il 13% più lenta in termini di frame rate a 4K. La differenza di prezzo è di $950, anche se entrambe le schede hanno 16 GB di memoria video e supportano DLSS Multi Frame Generation.
Anche il miglioramento rispetto alla RTX 4080 Super si è rivelato modesto. Secondo i test di Tom's Hardware, la RTX 5080 è più veloce della precedente di circa il 12% in 4K senza ray tracing. Il vantaggio più evidente rispetto alla RTX 5070 Ti si registra nei giochi con ray tracing pesante, ma anche in questo caso l'incremento non giustifica la differenza di prezzo.
Blackwell e GDDR7: cosa è cambiato
La RTX 5080 è basata sul processore grafico GB203, con 10 752 CUDA core. Utilizza memoria GDDR7 con una larghezza di banda di 960 GB/s, invece della GDDR6X della RTX 4080 Super. La larghezza di banda è aumentata del 30%, ma la quantità di memoria è rimasta invariata.
| Caratteristica | RTX 5080 | RTX 4080 Super | RTX 5070 Ti |
|---|---|---|---|
| Architettura | Blackwell | Ada Lovelace | Blackwell |
| CUDA core | 10 752 | 10 240 | 8 960 |
| Memoria | 16 GB GDDR7 | 16 GB GDDR6X | 16 GB GDDR7 |
| Larghezza di banda | 960 GB/s | 736 GB/s | 896 GB/s |
| Frequenza Boost | 2617 MHz | 2550 MHz | 2452 MHz |
| TGP | 360 W | 320 W | 300 W |
La RTX 5080 integra RT core di quarta generazione, Tensor core di quinta generazione, PCIe 5.0 e DisplayPort 2.1b.
Il TGP nominale è aumentato da 320 a 360 W, anche se il consumo effettivo dipende dal carico. NVIDIA raccomanda un alimentatore da 850 W. Per il collegamento si utilizza un cavo di alimentazione a 16 pin oppure l'adattatore incluso per tre connettori a 8 pin.
3DMark Time Spy
| Scheda video | Punteggio grafico |
|---|---|
| GeForce RTX 4090 | 36 676 |
| GeForce RTX 5080 | 31 987 |
| Radeon RX 9070 XT | 29 464 |
| GeForce RTX 4080 Super | 27 920 |
| GeForce RTX 5070 Ti | 27 727 |
Risultati di ComputerBase.
La RTX 5080 supera la RTX 4080 Super e la RTX 5070 Ti di circa il 15%, ma è più lenta della RTX 4090 della generazione precedente.
Test nei giochi: 1440p e 4K senza upscaling
I risultati aggregati di Tom's Hardware relativi a giugno 2026 consentono di confrontare le schede video senza DLSS, FSR e generazione dei fotogrammi.
| Scheda video | 1440p Ultra | 4K Ultra | 4K con RT |
|---|---|---|---|
| RTX 4090 | 143,4 | 89,1 | 52,2 |
| RTX 5080 | 128,3 | 77,4 | 42,1 |
| RTX 4080 Super | 118,6 | 69,4 | 38,5 |
| RTX 5070 Ti | 116,8 | 68,6 | 36,7 |
| Radeon RX 9070 XT | 116,5 | 65,8 | 30,1 |
FPS medi. Rasterizzazione e ray tracing sono stati misurati in raccolte separate di giochi.
A 1440p la RTX 5080 è più veloce della RTX 5070 Ti del 10%; in 4K il vantaggio sale al 13%. La RTX 4080 Super è più lenta della nuova scheda di circa il 12% in 4K, mentre la RTX 4090 mantiene il primato.
Con il ray tracing, il vantaggio della RTX 5080 sulla RTX 5070 Ti raggiunge il 15% e quello sulla Radeon RX 9070 XT il 40%. Tuttavia, una media di 42 FPS in 4K con RT significa che per ottenere un frame rate più elevato sarà necessario ricorrere all'upscaling o ridurre le impostazioni.
Death Stranding 2: confronto con DLSS e FSR
Nei test di ComputerBase del marzo 2026 sono state utilizzate impostazioni grafiche molto elevate, DLSS 4 Quality per le schede NVIDIA e FSR 4.1 Quality per la Radeon RX 9000. La generazione dei fotogrammi era disattivata.
| Scheda video | 1440p | 4K | 4K con RT |
|---|---|---|---|
| RTX 4090 | 124,8 | 105,5 | 65,5 |
| RTX 5080 | 125,8 | 96,4 | 57,0 |
| RTX 4080 Super | 104,1 | 82,3 | 49,2 |
| RTX 5070 Ti | 110,4 | 84,6 | 49,2 |
| Radeon RX 9070 XT | 106,9 | 79,0 | 41,2 |
FPS medi. In modalità RT viene utilizzato il ray tracing al livello massimo. La qualità dell'immagine con DLSS e FSR può variare.
La RTX 5080 è più veloce della RTX 5070 Ti del 14% in 4K e del 16% con il ray tracing. La RTX 4090 mantiene il primato in 4K, anche se a 1440p è leggermente più lenta della nuova scheda.
Prezzo: quanto costa la prestazione aggiuntiva
Secondo un'analisi di TechSpot pubblicata il 2 novembre 2026, i prezzi minimi delle schede video disponibili nei negozi statunitensi a ottobre erano di $2200 per la RTX 5080, $1250 per la RTX 5070 Ti e $870 per la Radeon RX 9070 XT.
| Scheda video | Prezzo negli USA | FPS in 4K | Prezzo per FPS |
|---|---|---|---|
| RTX 5080 | $2200 | 77,4 | $28,42 |
| RTX 5070 Ti | $1250 | 68,6 | $18,22 |
| Radeon RX 9070 XT | $870 | 65,8 | $13,22 |
Il prezzo per FPS è calcolato sulla base dei risultati medi in 4K Ultra senza ray tracing. L'indicatore viene utilizzato solo per confrontare il costo della prestazione.
Considerando il costo per singolo FPS, la RTX 5080 è il 56% più costosa della RTX 5070 Ti. La Radeon RX 9070 XT offre circa l'85% delle prestazioni della RTX 5080 a un prezzo 2,5 volte inferiore.
Anche la RTX 5070 Ti è diventata molto più costosa rispetto ai $749 del prezzo consigliato, ma continua a essere un acquisto più conveniente della RTX 5080.
DLSS e ray tracing
La RTX 5080 supporta DLSS Multi Frame Generation, che crea fotogrammi aggiuntivi tra quelli calcolati dal motore di gioco. La tecnologia aumenta la fluidità visiva, ma non offre un miglioramento proporzionale della reattività dei comandi.
La RTX 5070 Ti supporta la stessa tecnologia. Il vantaggio della RTX 5080 consiste nel frame rate iniziale più elevato, soprattutto nei giochi con path tracing. Per i possessori di monitor 4K ad alta frequenza di aggiornamento questa differenza può essere importante, anche se nei giochi più impegnativi nemmeno la RTX 5080 consente sempre di fare a meno dell'upscaling.
Blender, editing video e reti neurali
La RTX 5080 supporta CUDA, OptiX e la codifica hardware AV1. I due encoder video NVENC di nona generazione accelerano l'elaborazione dei formati video compatibili, incluso HEVC 4:2:2 a 10 bit.
Nei test di Puget Systems, i risultati del Blender Benchmark sono i seguenti:
| Scheda video | Blender Benchmark |
|---|---|
| RTX 5090 | 15 872 |
| RTX 5080 | 9 035 |
| RTX 5070 Ti | 7 882 |
| Radeon RX 9070 XT | 3 722 |
La RTX 5080 è più veloce della RTX 5070 Ti del 15%. La Radeon RX 9070 XT è nettamente più lenta nel rendering tramite HIP, quindi per lavorare regolarmente con Blender gli acceleratori NVIDIA sono preferibili.
Per le reti neurali locali, la RTX 5080 è limitata dai suoi 16 GB di memoria video. Per esempio, un modello linguistico da 32 miliardi di parametri con quantizzazione a 4 bit di solito non entra interamente in questa capacità, considerando i dati ausiliari e la KV cache. I requisiti esatti dipendono dal formato di quantizzazione e dalla dimensione del contesto.
Se il modello entra nella VRAM, la RTX 5080 garantisce un'elevata velocità di calcolo. Per i modelli più grandi, una maggiore quantità di memoria video è spesso più utile di una GPU più potente.
Conviene acquistare la GeForce RTX 5080 nel 2026?
Al prezzo di $2200, è difficile consigliare la RTX 5080 per il gaming tradizionale. La RTX 5070 Ti costa $950 in meno, ha gli stessi 16 GB di memoria e offre in media appena il 13% di FPS in meno in 4K. La Radeon RX 9070 XT è ancora più conveniente se non è necessaria un'elevata prestazione nel ray tracing.
La RTX 5080 ha senso per il 4K con effetti grafici pesanti, per Blender e per i carichi di lavoro CUDA che siano compatibili con 16 GB di memoria video. I possessori di una RTX 4080 Super non dovrebbero effettuare l'upgrade: un incremento di circa il 12% in 4K è troppo ridotto per giustificare una sostituzione così costosa.
Confronto di GPU
Confronta GeForce RTX 5080 con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
3x DisplayPort 2.1b
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati

Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/it/gpu/nvidia-geforce-rtx-5080" target="_blank">NVIDIA GeForce RTX 5080</a>