NVIDIA T1000
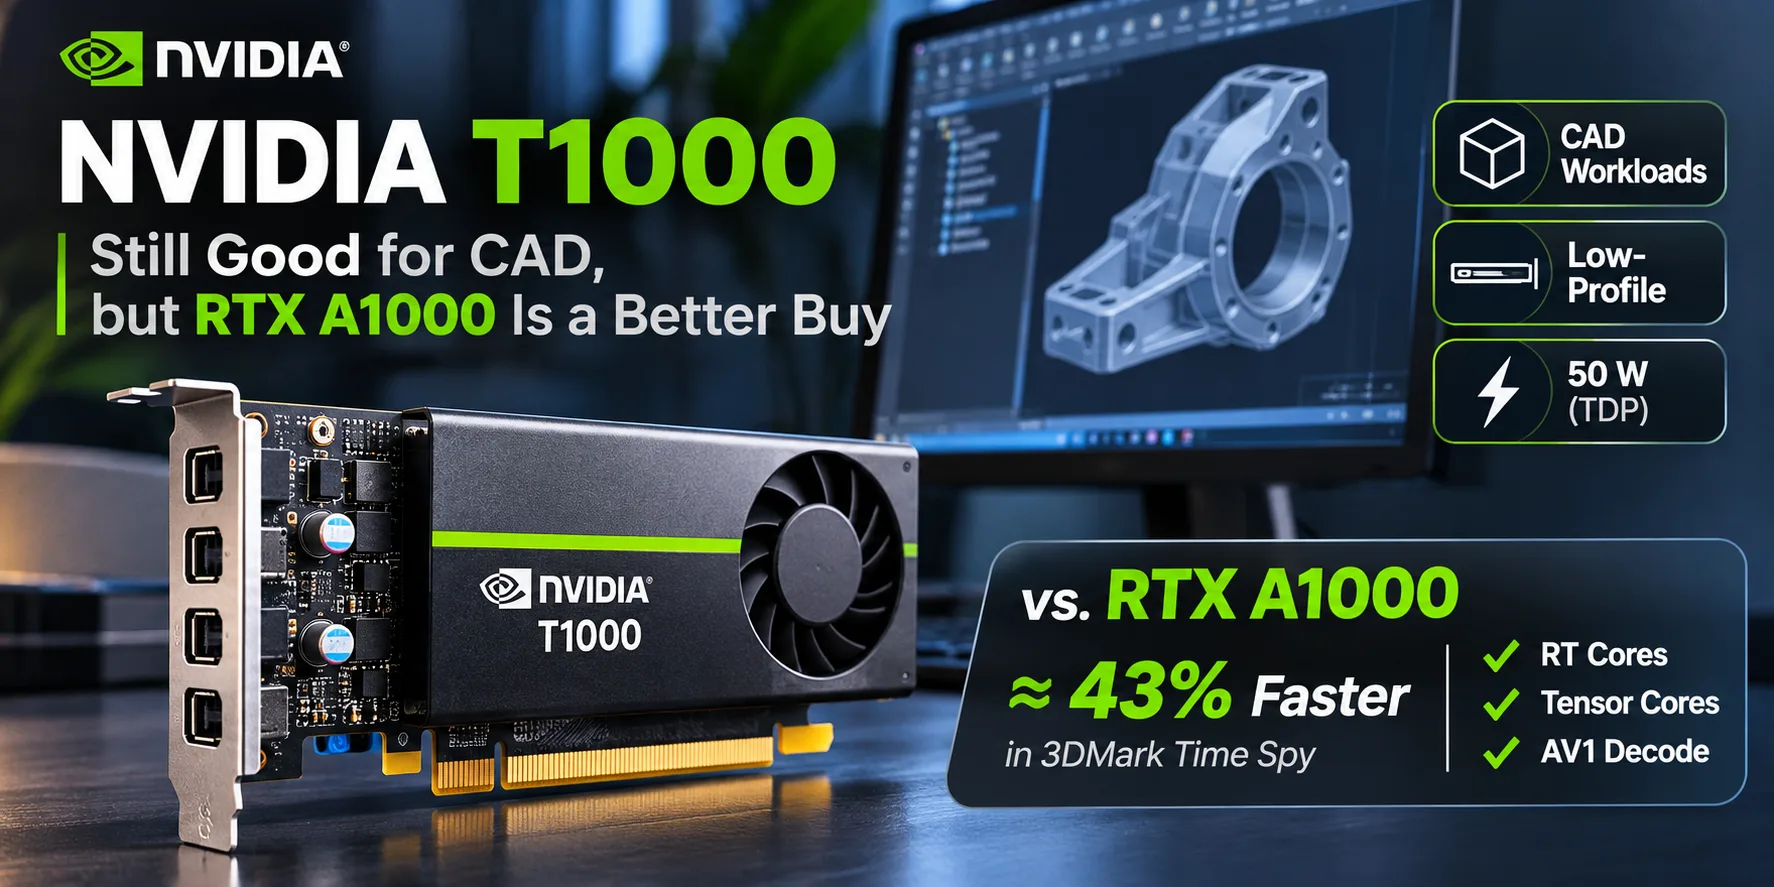
NVIDIA T1000 : encore valable pour la CAO, mais la RTX A1000 est plus intéressante
La NVIDIA T1000 est une carte graphique professionnelle de 2021 destinée aux stations de travail compactes. Elle repose sur la même puce TU117 que la GeForce GTX 1650. Toutefois, la T1000 n’est pas conçue pour le jeu, mais pour les applications de CAO : elle bénéficie de pilotes professionnels et d’une certification pour certaines versions de logiciels d’ingénierie. La carte n’occupe qu’un seul emplacement, consomme jusqu’à 50 W et ne nécessite pas d’alimentation supplémentaire. La principale question est aujourd’hui de savoir s’il est pertinent de l’acheter neuve alors que la RTX A1000 existe.
| Modèle | Cœurs CUDA | Bande passante | Cœurs RT / Tensor | Décodage AV1 |
|---|---|---|---|---|
| NVIDIA T1000 8 GB | 896 | 160 GB/s | Non / non | Non |
| NVIDIA RTX A1000 8 GB | 2304 | 192 GB/s | 18 / 72 | Oui |
Pour quelles tâches la T1000 convient-elle ?
La T1000 est proposée avec 4 ou 8 GB de GDDR6 sur un bus 128 bits. Les deux versions disposent des mêmes 896 cœurs CUDA, offrent jusqu’à 2,5 TFLOPS en FP32 et utilisent une interface PCIe 3.0 x16. La carte low-profile simple slot possède quatre sorties Mini DisplayPort 1.4 : il est possible de connecter quatre moniteurs 5K à 60 Hz.
Dans AutoCAD, Inventor et SolidWorks, la carte convient aux plans 2D, aux pièces isolées et aux petites assemblages 3D. Pour les modèles complexes, la taille du projet, les capacités du processeur et la quantité de mémoire vidéo sont importantes. Entre les deux versions de la T1000, il est donc plus raisonnable de choisir le modèle 8 GB : la version 4 GB dispose d’une réserve mémoire plus limitée. Toutefois, à charge GPU identique, 4 GB supplémentaires n’accélèrent pas les calculs à eux seuls.
La T1000 prend en charge CUDA et peut effectuer le rendu de scènes dans Blender. Cependant, la puce TU117 ne possède pas de cœurs RT ni de cœurs Tensor matériels. Dans les tâches de ray tracing, elle est nettement moins performante que les RTX plus récentes, tandis que le DLSS et le décodage matériel de l’AV1 ne sont pas disponibles.
Performances : T1000 contre RTX A1000
Dans 3DMark Time Spy Graphics, la RTX A1000 de bureau devance la T1000 d’environ 43 %. La comparaison repose sur les résultats médians d’une seule base de données agrégée, et non sur des tests réalisés avec les deux cartes dans le même PC.
| Carte graphique | 3DMark Time Spy Graphics |
|---|---|
| NVIDIA T1000 | 3084 |
| NVIDIA RTX A1000 | 4396 |
Un test distinct de la T1000 dans une Lenovo ThinkStation P3 Tiny équipée d’un Core i9-14900 et de 64 GB de RAM a obtenu un score proche de 3088 points. Dans ce benchmark, le niveau de performances est comparable à celui du GPU intégré Radeon 890M, mais pour les applications de CAO, un tel score ne remplace pas des tests spécialisés.
Dans Blender 3.3, sur la même ThinkStation, la scène Classroom a été rendue en 159 secondes, aussi bien avec CUDA qu’avec OptiX. Dépourvue de cœurs RT, la T1000 ne bénéficie pas de l’accélération du ray tracing disponible sur les cartes graphiques RTX.
Dans les jeux, la T1000 est proche de la GeForce GTX 1650. En 1920 × 1080, la ThinkStation de test a obtenu 45,1 FPS dans Cyberpunk 2077 (Low, FSR désactivé) et 82,6 FPS dans F1 24 (Medium, TAA). Ce niveau est suffisant pour les jeux peu exigeants, mais ne justifie pas l’achat d’une carte professionnelle plutôt que d’une carte gaming.
Résultats dans les stations de travail
StorageReview a testé la T1000 dans deux ordinateurs prêts à l’emploi. Dans SPECviewperf 2020, les résultats varient selon l’application :
| Station de travail | CPU | GPU | SolidWorks | Siemens NX | Creo |
|---|---|---|---|---|---|
| Lenovo ThinkStation P3 Tiny | Core i7-14700 | T1000 8 GB | 39,28 | 165,51 | 42,71 |
| HP Z2 G8 Tower | Core i7-11700 | T1000 4 GB | 16,92 | 97,8 | 41,62 |
SPECviewperf 2020, points ; plus élevé = meilleur. La présentation de la Lenovo indique une résolution système de 3840 × 2160, contre 3800 × 2120 pour les tests de la HP. L’identité des paramètres de SPECviewperf et des pilotes n’est pas confirmée ; il ne s’agit donc pas d’une comparaison directe des deux versions de la T1000.
Dans Creo, les valeurs sont presque identiques, tandis qu’elles diffèrent beaucoup davantage dans SolidWorks et Siemens NX. Les processeurs, la quantité de mémoire vidéo et, éventuellement, les paramètres de test et les pilotes sont également différents. Ces résultats ne prouvent pas que le passage de 4 à 8 GB apporte un gain proportionnel. Avant d’acheter une station de travail, il est plus utile de vérifier les performances précisément dans le logiciel de CAO utilisé et la certification de sa version.
Prix et alternatives
Dans les offres vérifiées le 11 novembre 2026, la PNY T1000 8 GB neuve est proposée à $449, tandis que la PNY RTX A1000 8 GB coûte $550. Aux prix indiqués, le supplément s’élève à environ $100. En contrepartie, l’acheteur bénéficie d’un GPU plus rapide, de cœurs RT et Tensor matériels et de la prise en charge du décodage AV1. La RTX A1000 consomme elle aussi jusqu’à 50 W, occupe un seul emplacement low-profile et dispose de quatre sorties Mini DisplayPort.
D’autres tâches peuvent justifier les alternatives suivantes :
- Intel Arc Pro B50 16 GB : deux fois plus de mémoire vidéo, 70 W et format low-profile, mais la carte occupe deux emplacements. Dans l’offre Newegg vérifiée, elle coûte environ $700, soit pas moins cher que la RTX A1000. Il peut être pertinent de la choisir pour ses 16 GB et si la prise en charge des logiciels nécessaires est confirmée.
- GeForce RTX 3050 6 GB : une option pour la 2D classique, les jeux et CUDA, lorsqu’il n’est pas nécessaire de disposer de pilotes professionnels certifiés. Certains modèles low-profile occupent deux emplacements.
- Radeon 890M : un GPU intégré d’un niveau proche dans Time Spy. Pour la bureautique et les applications graphiques peu exigeantes, une T1000 dédiée peut ne pas être nécessaire, mais les résultats dans les applications de CAO et la prise en charge par les pilotes seront différents.
Conclusion
La T1000 reste adaptée aux stations de travail compactes qui nécessitent un seul emplacement, quatre sorties vidéo et des pilotes professionnels. Pour la conception 2D et les petites assemblages 3D, elle demeure une solution fonctionnelle ; entre les deux versions, le modèle 8 GB est préférable.
Il est difficile de recommander une T1000 neuve à $449 lorsqu’une RTX A1000 est disponible à $550. Dans les résultats présentés pour Time Spy, cette dernière est environ 43 % plus rapide et convient mieux au rendu GPU, sans nécessiter davantage d’espace ou de puissance. L’achat de la T1000 peut se justifier si la configuration concrète de la station de travail est nettement moins chère, ou si sa compatibilité a déjà été vérifiée et prime sur les performances.
Comparaison de GPU
Comparer T1000 avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Comparaisons de GPU associées

Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/fr/gpu/nvidia-t1000" target="_blank">NVIDIA T1000</a>