NVIDIA T1000

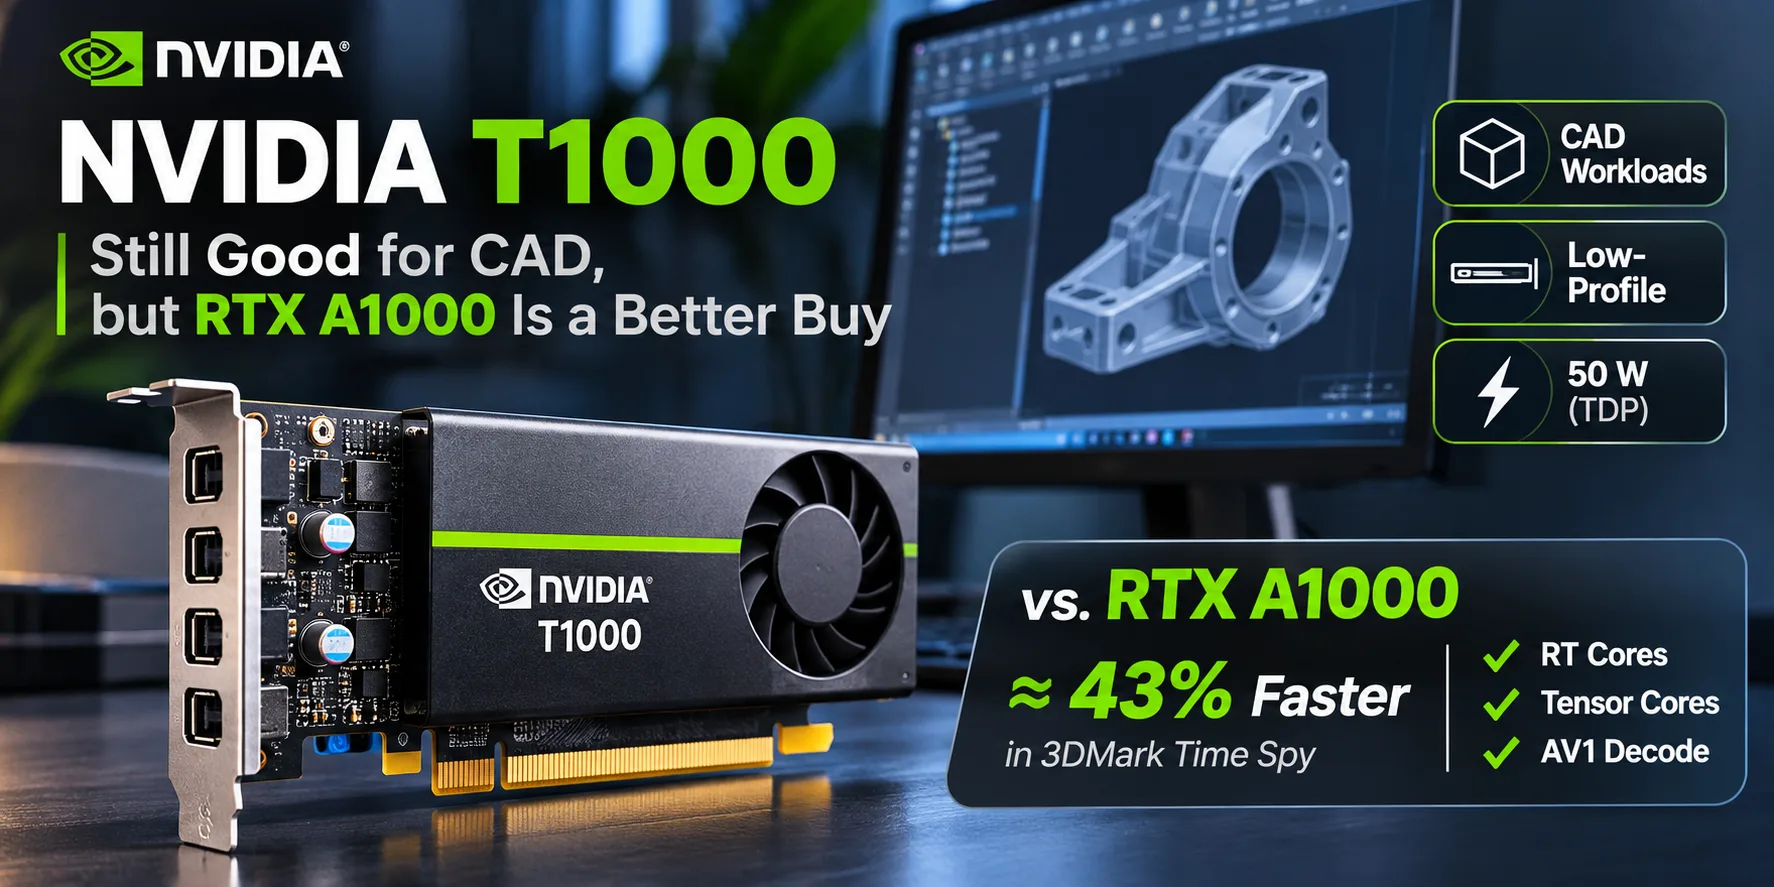
NVIDIA T1000: для CAD ещё годится, но RTX A1000 выгоднее
NVIDIA T1000 - профессиональная видеокарта 2021 года для компактных рабочих станций. В её основе тот же чип TU117, что и в GeForce GTX 1650. Однако T1000 рассчитана не на игры, а на работу с CAD-приложениями: для неё доступны профессиональные драйверы и сертификация под определённые версии инженерного ПО. Карта занимает один слот, потребляет до 50 W и обходится без дополнительного питания. Главный вопрос сегодня - стоит ли покупать её новой, когда существует RTX A1000.
| Модель | CUDA cores | Пропускная способность | RT / Tensor cores | Декодирование AV1 |
|---|---|---|---|---|
| NVIDIA T1000 8 GB | 896 | 160 GB/s | Нет / нет | Нет |
| NVIDIA RTX A1000 8 GB | 2304 | 192 GB/s | 18 / 72 | Есть |
Для каких задач подходит T1000
T1000 выпускается с 4 и 8 GB GDDR6 на 128-bit шине. У обеих версий одинаковые 896 CUDA cores, производительность FP32 до 2,5 TFLOPS и интерфейс PCIe 3.0 x16. Низкопрофильная однослотовая плата оснащена четырьмя Mini DisplayPort 1.4: можно подключить четыре монитора 5K при 60 Hz.
В AutoCAD, Inventor и SolidWorks карта подходит для 2D-чертежей, отдельных деталей и небольших 3D-сборок. Для сложных моделей важны размер проекта, возможности процессора и объём видеопамяти. Поэтому из двух исполнений T1000 разумнее выбирать 8 GB: у версии 4 GB запас по памяти меньше. Но при одинаковой загрузке GPU дополнительные 4 GB сами по себе не ускоряют вычисления.
T1000 поддерживает CUDA и может рендерить сцены в Blender. Однако у чипа TU117 нет аппаратных RT- и тензорных ядер. В задачах трассировки лучей она заметно уступает более новым RTX, а DLSS и аппаратное декодирование AV1 недоступны.
Производительность: T1000 против RTX A1000
В 3DMark Time Spy Graphics настольная RTX A1000 опережает T1000 примерно на 43%. Для сравнения использованы медианные результаты одной сводной базы, а не тесты двух карт в одинаковом ПК.
| Видеокарта | 3DMark Time Spy Graphics |
|---|---|
| NVIDIA T1000 | 3084 |
| NVIDIA RTX A1000 | 4396 |
Отдельный тест T1000 в Lenovo ThinkStation P3 Tiny с Core i9-14900 и 64 GB RAM дал близкие 3088 баллов. Уровень производительности сопоставим со встроенной Radeon 890M в этом бенчмарке, но для CAD-приложений такой показатель не заменяет специализированных испытаний.
В Blender 3.3 на той же ThinkStation сцена Classroom рендерилась за 159 секунд - как при использовании CUDA, так и через OptiX. Без RT-ядер T1000 не получает того ускорения трассировки, которое доступно видеокартам RTX.
В играх T1000 близка к GeForce GTX 1650. При 1920 × 1080 в тестовой ThinkStation получено 45,1 FPS в Cyberpunk 2077 (Low, FSR выключен) и 82,6 FPS в F1 24 (Medium, TAA). Это достаточный уровень для нетребовательных игр, но не причина покупать профессиональную карту вместо игровой.
Результаты в рабочих станциях
StorageReview проверила T1000 в двух готовых компьютерах. В SPECviewperf 2020 результаты различаются в зависимости от приложения:
| Рабочая станция | CPU | GPU | SolidWorks | Siemens NX | Creo |
|---|---|---|---|---|---|
| Lenovo ThinkStation P3 Tiny | Core i7-14700 | T1000 8 GB | 39,28 | 165,51 | 42,71 |
| HP Z2 G8 Tower | Core i7-11700 | T1000 4 GB | 16,92 | 97,8 | 41,62 |
SPECviewperf 2020, баллы; больше - лучше. В обзоре Lenovo указано разрешение системы 3840 × 2160, для тестов HP - 3800 × 2120. Идентичность настроек SPECviewperf и драйверов не подтверждена, поэтому это не прямое сравнение двух вариантов T1000.
В Creo значения почти совпадают, тогда как в SolidWorks и Siemens NX расходятся гораздо сильнее. При этом различаются CPU, объём видеопамяти и, возможно, настройки теста и драйверы. Эти результаты не доказывают, что переход с 4 на 8 GB обеспечивает соответствующий прирост. Перед покупкой рабочей станции полезнее проверять скорость именно в используемом CAD-пакете и сертификацию его версии.
Цены и альтернативы
В предложениях, проверенных 11 ноября 2026 года, новая PNY T1000 8 GB встречается за $449, а PNY RTX A1000 8 GB - за $550. При указанных ценах доплата составляет около $100. За неё покупатель получает более быстрый GPU, аппаратные RT- и тензорные ядра и поддержку декодирования AV1. При этом RTX A1000 также потребляет до 50 W, занимает один низкопрофильный слот и располагает четырьмя Mini DisplayPort.
Для других задач возможны альтернативы:
- Intel Arc Pro B50 16 GB - вдвое больше видеопамяти, 70 W и низкопрофильное исполнение, но карта двухслотовая. В проверенном предложении Newegg она стоит около $700, то есть не дешевле RTX A1000. Выбирать её имеет смысл ради 16 GB и при подтверждённой поддержке нужного ПО.
- GeForce RTX 3050 6 GB - вариант для обычной графики, игр и CUDA без требования сертифицированных профессиональных драйверов. Некоторые низкопрофильные исполнения занимают два слота.
- Radeon 890M - встроенная графика близкого уровня в Time Spy. Для офисной работы и нетребовательной графики отдельная T1000 может не понадобиться, но результаты CAD-приложений и поддержка драйверов будут отличаться.
Вывод
T1000 по-прежнему подходит для компактных рабочих станций, которым нужны один слот, четыре видеовыхода и профессиональные драйверы. В 2D-проектировании и небольших 3D-сборках она остаётся работоспособным решением; при выборе между двумя версиями предпочтительнее 8 GB.
Новую T1000 за $449 трудно рекомендовать при наличии RTX A1000 за $550. В приведённых результатах Time Spy последняя быстрее примерно на 43% и лучше подходит для GPU-рендеринга, не требуя дополнительного места или мощности. Покупка T1000 оправданна, если конкретная конфигурация рабочей станции заметно дешевле либо совместимость с ней уже проверена и имеет приоритет над производительностью.
Сравнение GPU
Сравнить T1000 с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Похожие сравнения видеокарт

Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/ru/gpu/nvidia-t1000" target="_blank">NVIDIA T1000</a>