NVIDIA Tesla P100 PCIe 16 GB

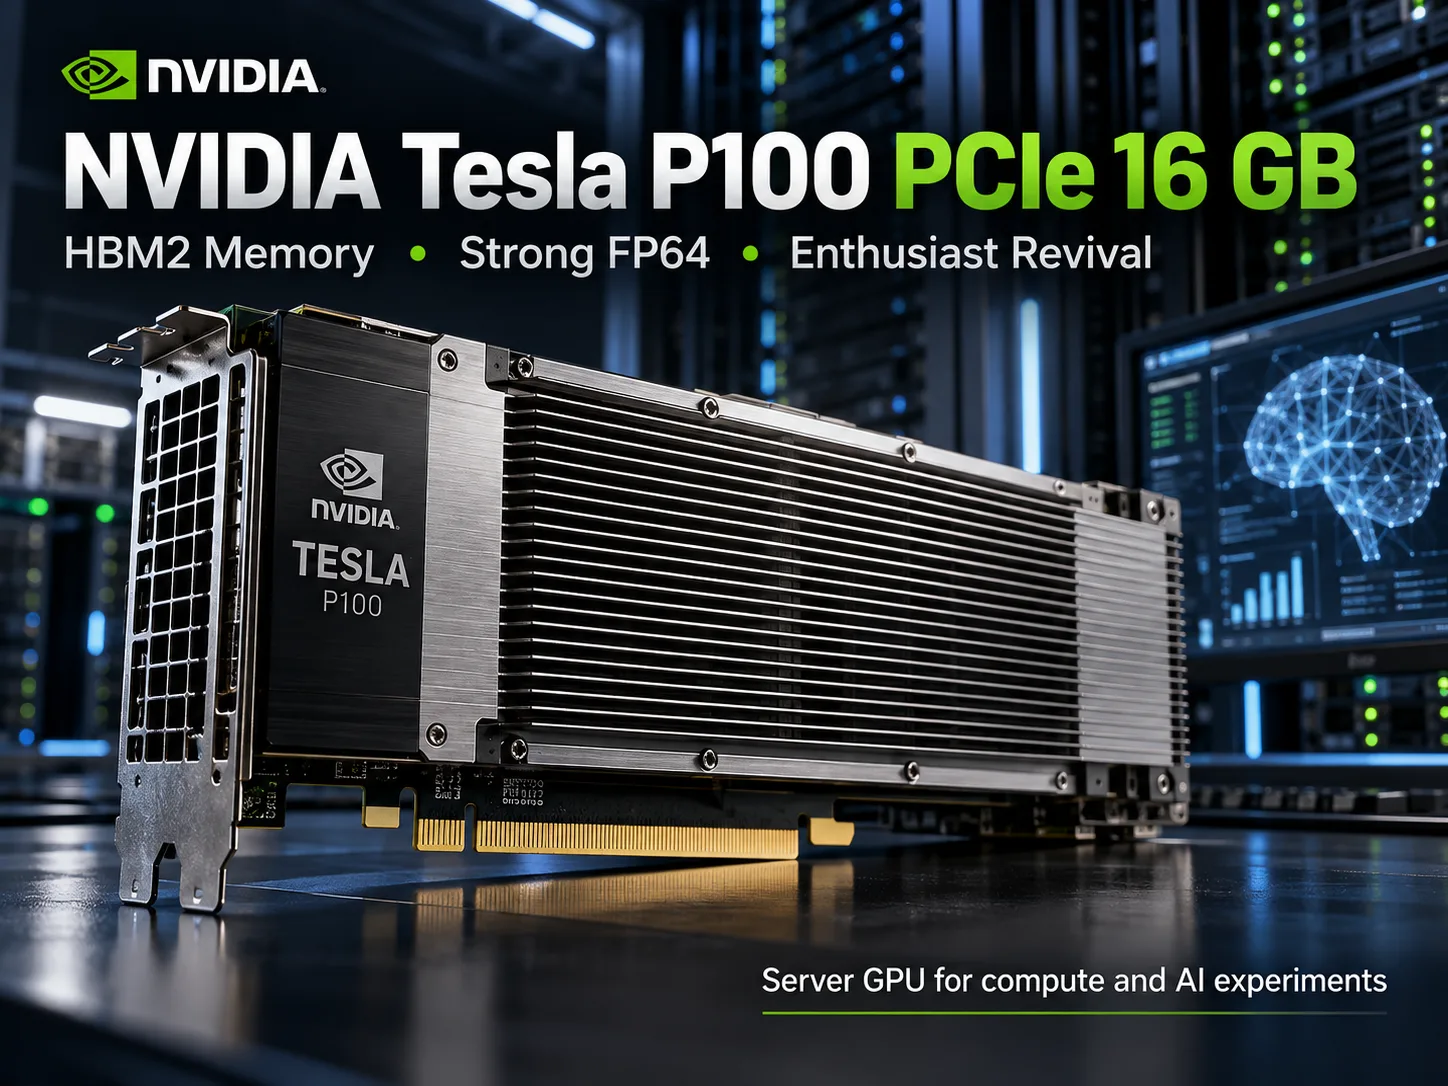
NVIDIA Tesla P100 PCIe 16 GB: por que uma Tesla antiga voltou a interessar aos entusiastas
A NVIDIA Tesla P100 PCIe 16 GB foi lançada em 2016 como aceleradora para cálculos científicos e supercomputadores. Dez anos depois, placas de servidor desativadas ganharam uma segunda vida: entusiastas as compram para servidores domésticos, experimentos com redes neurais e programas CUDA. O motivo é simples: 16 GB de memória HBM2 e alta potência computacional agora estão disponíveis por pouco dinheiro. Mas o preço baixo esconde alguns problemas: refrigeração passiva, suporte CUDA cada vez mais desatualizado e ausência de Tensor Cores.
Como a P100 difere da P40 e da V100
A Tesla P100 é baseada no processador GP100 de 16 nm, da arquitetura Pascal. Ela recebeu 3584 núcleos CUDA e um barramento de memória de 4096 bits. Sua principal característica são os poderosos blocos FP64, praticamente inexistentes nas placas de vídeo para consumidores daquela geração.
| Característica | Tesla P100 PCIe | Tesla P40 | Tesla V100 PCIe |
|---|---|---|---|
| Arquitetura | Pascal | Pascal | Volta |
| Núcleos CUDA | 3584 | 3840 | 5120 |
| Memória | 16 GB HBM2 | 24 GB GDDR5 | 16 GB HBM2 |
| Largura de banda | 732 GB/s | 346 GB/s | 900 GB/s |
| FP32 | 9,3 TFLOPS | 12 TFLOPS | 14 TFLOPS |
| FP64 | 4,7 TFLOPS | ~0,375 TFLOPS | 7 TFLOPS |
| Tensor Cores | Não | Não | 640 |
A P40 oferece mais memória de vídeo, mas a P100 supera sua largura de banda em mais de duas vezes e, em desempenho teórico FP64, é aproximadamente 12,5 vezes mais rápida.
A V100 é significativamente mais potente que ambas. Sua vantagem não está apenas na velocidade de cálculo, mas também na presença de Tensor Cores, que aceleram operações usadas em aprendizado de máquina.
Desempenho em benchmarks
No Geekbench 7 OpenCL, a P100 PCIe fica entre a Tesla T4 e a GeForce RTX 3060. A V100 para servidores, baseada na arquitetura Volta, é mais de duas vezes mais rápida.
| Placa de vídeo | Geekbench 7 OpenCL |
|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 |
| NVIDIA GeForce RTX 3060 | 88 251 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 |
| NVIDIA Tesla T4 16 GB | 60 483 |
São resultados agregados do Geekbench Browser, obtidos em sistemas diferentes. Eles servem para uma comparação geral entre GPUs, mas não mostram a velocidade de cálculos científicos FP64 nem do processamento de modelos de linguagem.
A P100 PCIe supera a T4 em aproximadamente 19%, mas fica 18% atrás da própria versão SXM2. Ao mesmo tempo, a SXM2 exige uma plataforma de servidor específica e não pode ser instalada em um slot PCIe comum.
Por que a P100 ainda é interessante para cálculos
Em aplicações científicas, o FP64 é usado em cálculos que exigem alta precisão numérica: modelagem de processos físicos, dinâmica dos fluidos computacional e algumas tarefas de engenharia.
Por exemplo, ao executar operações de matriz de dupla precisão, a Tesla P100 oferece desempenho teórico de 4,7 TFLOPS, contra aproximadamente 0,375 TFLOPS da P40. A diferença é enorme, embora o ganho real dependa do algoritmo, do volume de transferência de dados com a memória e da eficiência do programa.
A memória HBM2 também ajuda em tarefas que processam grandes conjuntos de dados. Sua largura de banda de 732 GB/s é especialmente útil em cargas com leitura e gravação intensivas. O suporte a ECC aumenta adicionalmente a confiabilidade de cálculos prolongados.
Por isso, não se pode considerar a P100 simplesmente uma placa de vídeo obsoleta. Em aplicações científicas compatíveis, ela ainda é capaz de realizar um trabalho útil.
Uma segunda vida no mercado de usados
Em 2026, a Tesla P100 chamou a atenção de proprietários de servidores domésticos e de pessoas que gostam de experimentar com equipamentos baratos. Placas que antes operavam em data centers aparecem no mercado de usados por preços desproporcionais ao seu valor original.
Em outubro de 2026, havia anúncios no eBay americano de P100 PCIe 16 GB por aproximadamente $100-160. Alguns entusiastas relatam ter comprado unidades por $75-80. O preço depende do estado da placa, do vendedor e da região.
Por relativamente pouco dinheiro, o comprador recebe 16 GB de memória de vídeo com alta largura de banda. É justamente isso que atrai pessoas que montam servidores domésticos para computação ou tentam executar LLMs localmente sem comprar aceleradoras modernas caras.
No entanto, a P100 não é uma placa de vídeo comum que basta instalar no computador:
- Refrigeração. A placa possui um dissipador passivo e foi projetada para receber um forte fluxo de ar direcionado. Em um PC doméstico, normalmente é necessário instalar um ventilador separado com duto de ar.
- Alimentação. É usado um conector de oito pinos para CPU/EPS. Um cabo PCIe comum de 8 pinos não deve ser conectado sem verificar a pinagem.
- Compatibilidade. Em algumas placas-mãe antigas, é necessário configurar o Above 4G Decoding.
- Software. As bibliotecas CUDA mais recentes nem sempre oferecem suporte à arquitetura Pascal. Alguns aplicativos precisam ser compilados pelo próprio usuário com dependências antigas.
Ao comprar, vale solicitar os resultados do diagnóstico do nvidia-smi, verificar se há erros de memória e confirmar se a placa passou por um teste prolongado sob carga. Uma unidade barata com HBM2 defeituosa é praticamente inútil.
A P100 é adequada para redes neurais locais?
A P100 consegue executar modelos de linguagem compatíveis em formatos quantizados. Muitos modelos da classe de 7-8 bilhões de parâmetros cabem nos 16 GB de memória, assim como alguns modelos maiores, dependendo do nível de quantização e do tamanho do contexto.
Mas a alta velocidade da memória não compensa a ausência de Tensor Cores. Além disso, o GP100 não oferece suporte nativo a BF16, e o Compute Capability 6.0 limita a compatibilidade com bibliotecas modernas de ML.
A partir do CUDA 13.0, a NVIDIA excluiu o suporte à compilação para Pascal. Para desenvolver na P100, é necessário usar o CUDA 12.x e versões compatíveis das bibliotecas. Isso não significa que todos os aplicativos antigos tenham deixado de funcionar, mas a instalação de stacks modernos de ML ficou mais difícil.
Para experimentar com LLMs, a P100 é adequada, especialmente se você já possui a placa. No entanto, quem pretende comprá-la especificamente para modelos de linguagem deve compará-la com a P40 de 24 GB e a V100. A primeira permite manter modelos maiores inteiramente na memória, enquanto a segunda oferece Tensor Cores e um desempenho computacional significativamente maior. Ter mais memória não garante uma velocidade de geração mais alta.
Vale a pena comprar uma Tesla P100 em 2026?
Por cerca de $100, uma P100 PCIe 16 GB em funcionamento continua atraente para entusiastas dispostos a organizar a refrigeração por conta própria e configurar o CUDA. Isso é especialmente válido quando se busca uma aceleradora barata para cálculos FP64.
Para LLMs locais, a compra é menos óbvia. Além da própria placa, é preciso considerar a refrigeração, a alimentação, o consumo de até 250 W e o tempo necessário para configurar um software compatível. Se o objetivo principal é executar modelos modernos com praticidade, uma V100 ou RTX mais recente é preferível.
A Tesla P100 não se tornou uma placa de vídeo moderna por causa do preço baixo. Mas, como aceleradora de computação barata com 16 GB de HBM2, ela manteve seu espaço. Para cálculos científicos e experimentos, é um equipamento interessante. Para um PC doméstico versátil e um uso de IA sem complicações, é uma escolha ruim.
Comparação de GPU
Comparar Tesla P100 PCIe 16 GB com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Comparações de GPU relacionadas


Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/pt/gpu/nvidia-tesla-p100-pcie-16-gb" target="_blank">NVIDIA Tesla P100 PCIe 16 GB</a>