NVIDIA CMP 50HX

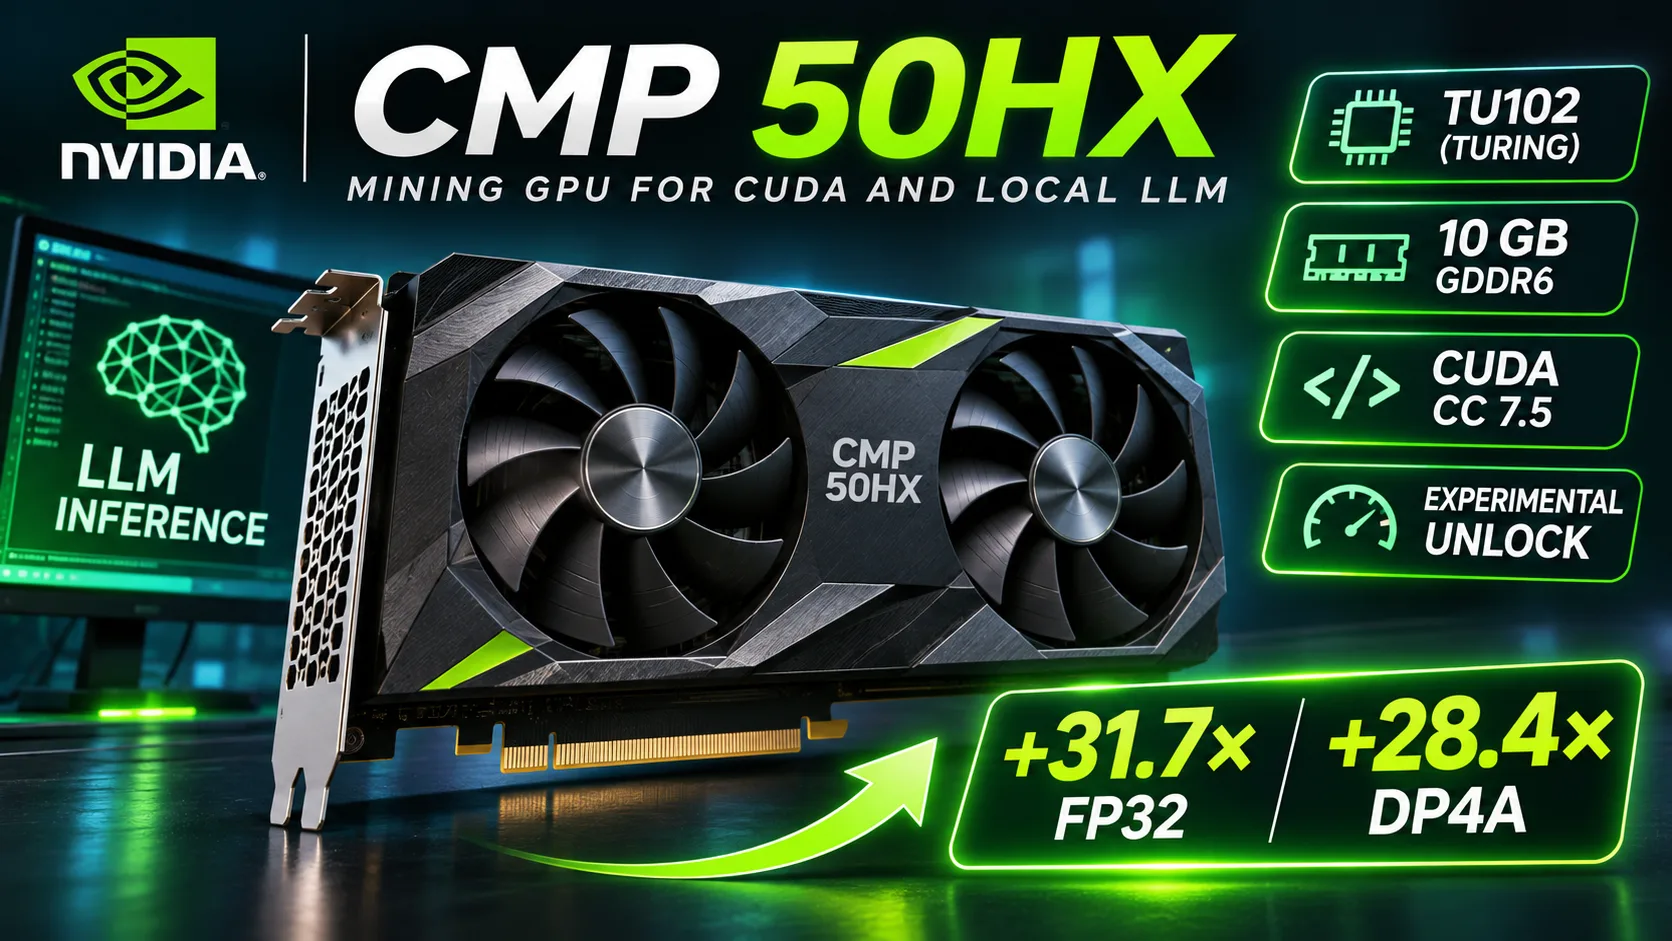
NVIDIA CMP 50HX: 10 GB de memória para CUDA e LLMs locais
A NVIDIA CMP 50HX é uma placa de vídeo especializada em mineração, lançada em 2021. Ela usa a GPU TU102 da arquitetura Turing, relacionada à GPU da GeForce RTX 2080 Ti. A placa recebeu 3584 núcleos CUDA e 10 GB de memória GDDR6, mas não possui saídas de vídeo e tem limitações de desempenho computacional.
Após a transição do Ethereum para Proof of Stake, a CMP 50HX passou a ser usada em experimentos com CUDA e redes neurais locais. Em algumas LLMs, ela oferece cerca de 30 tokens/s, mas a velocidade depende do tipo de cálculo e da configuração do software. Em 2026, surgiram métodos experimentais para remover parte dessas limitações.
Arquitetura e especificações
A CMP 50HX é baseada na GPU TU102 de 12 nm, com 56 multiprocessadores de streaming. Em comparação com a RTX 2080 Ti, ela tem menos blocos computacionais ativos e um barramento de memória mais estreito.
| Característica | CMP 50HX | RTX 2080 Ti |
|---|---|---|
| Núcleos CUDA | 3584 | 4352 |
| Multiprocessadores de streaming | 56 | 68 |
| Memória GDDR6 | 10 GB | 11 GB |
| Barramento de memória | 320-bit | 352-bit |
| Largura de banda | 560 GB/s | 616 GB/s |
| Frequência Boost | 1545 MHz | 1545 MHz |
| PCIe | 1.0 x4 | 3.0 x16 |
| Consumo de energia | 225 W | 250 W |
| Saídas de vídeo | Não | Sim |
Especificações da MSI CMP 50HX MINER e da RTX 2080 Ti padrão.
A CMP 50HX opera em frequências de 1350-1545 MHz. A memória GDDR6, com velocidade de 14 Gb/s, oferece largura de banda de 560 GB/s. O desempenho teórico em FP32 na frequência Boost é de aproximadamente 11.07 TFLOPS.
No entanto, na configuração padrão, o desempenho computacional disponível é significativamente menor.
Principais características da CMP 50HX:
- Suporte a CUDA Compute Capability 7.5.
- 10 GB de GDDR6 para cálculos e armazenamento de modelos.
- Ausência de HDMI e DisplayPort.
- Interface PCIe 1.0 x4 limitada.
- Dois conectores de alimentação adicionais de 8 pinos.
- Dependência das funções disponíveis em relação aos drivers.
A versão da MSI consome 225 W, enquanto a especificação de referência da NVIDIA prevê 250 W. Para operação prolongada, é necessário garantir fluxo de ar suficiente dentro do gabinete.
Desempenho em FP32, FP16 e INT8
A principal característica da CMP 50HX são as limitações de software aplicadas a determinadas operações computacionais. Na configuração padrão, a velocidade de FP32 e DP4A é especialmente reduzida, enquanto FP16 opera em velocidade significativamente maior.
Em setembro de 2026, os desenvolvedores de um desbloqueio experimental compararam o desempenho de uma placa com um driver comum e com o mesmo driver após a aplicação da modificação.
| Cálculos | Antes do desbloqueio | Depois do desbloqueio | Ganho |
|---|---|---|---|
| FP32, TFLOPS | 0.427 | 13.512 | 31.7× |
| FP16 half2, TFLOPS | 26.923 | 26.698 | ≈1× |
| DP4A / INT8, TIOPS | 1.689 | 47.984 | 28.4× |
Resultados de um experimento comparativo com a mesma base de software. As medições após o desbloqueio não são especificações de fábrica.
O desempenho em FP32 aumentou quase 32 vezes, enquanto o de DP4A cresceu mais de 28 vezes. Ao mesmo tempo, a velocidade das operações FP16 comuns praticamente não mudou.
Isso confirma que as limitações afetam blocos computacionais e instruções específicos, e não toda a GPU.
Após o desbloqueio, o FP32 atingiu 13.51 TFLOPS - acima dos 11.07 TFLOPS teóricos na frequência Boost de fábrica. A razão foi a frequência de operação mais alta durante o experimento. Comparar esses resultados sem levar as frequências em conta seria incorreto.
Em um teste separado, o FP16 Tensor WMMA atingiu 106.8 TFLOPS após o desbloqueio. Esse resultado se refere a operações tensoriais e não é diretamente comparável ao FP16 comum da tabela.
Desbloqueio experimental em 2026
Os desenvolvedores conseguiram restaurar o desempenho computacional da CMP 50HX por meio de uma modificação da UEFI e de alterações na configuração do software.
Para a versão testada, é usado o driver NVIDIA 610.43.03. O desbloqueio exige o carregamento da UEFI e o Above 4G Decoding ativado. O Secure Boot pode ser mantido com a assinatura correta do aplicativo UEFI e o registro da chave.
Modificações adicionais permitem ativar o PCIe Gen2 e o suporte experimental a ReBAR. No entanto, essas funções podem exigir alterações separadas nos drivers.
Os resultados foram confirmados em configurações de teste específicas. A compatibilidade com outras placas e sistemas precisa ser verificada separadamente.
Desempenho em LLMs locais
Os 10 GB de memória de vídeo permitem carregar muitos modelos de linguagem quantizados com 7-9 bilhões de parâmetros na CMP 50HX.
Nos testes com o Ollama e drivers modificados, foram obtidos os seguintes resultados de geração:
| Modelo | CMP 50HX, tokens/s |
|---|---|
| Qwen3 8B Q4_K_M | cerca de 28 |
| Llama 3.1 8B Instruct Q6_K | 32 |
| Dolphin3 8B | 28 |
| Gemma 2 9B | 33 |
| Gemma 3 4B Q8_0 | 57 |
Velocidade de geração antes do desbloqueio experimental das operações computacionais em 2026.
Esses resultados explicam por que a CMP 50HX continuava adequada para inferência mesmo com um desempenho FP32 extremamente baixo.
No entanto, a limitação do DP4A também é importante. Ao processar modelos quantizados, o CUDA pode usar operações inteiras, incluindo DP4A. A redução na velocidade dessas operações pode limitar tanto a geração de tokens quanto o processamento do contexto de entrada.
O processamento de prompts longos (prefill) pode ser especialmente afetado, pois a carga computacional é maior. Entretanto, ainda não há medições comparativas de prefill confirmadas em quantidade suficiente para conclusões quantitativas antes e depois do desbloqueio.
A CMP 50HX tem largura de banda de memória de 560 GB/s, contra 360 GB/s da RTX 3060 12 GB. Porém, uma largura de banda elevada, por si só, não garante uma geração mais rápida: as limitações computacionais, as características dos núcleos CUDA e a quantização também influenciam o resultado.
O desbloqueio do DP4A cria condições para acelerar LLMs, mas o ganho de 28 vezes em um teste sintético não pode ser extrapolado para a velocidade de geração de tokens.
Com uma quantização adequada e um contexto pequeno, modelos específicos com 12-14 bilhões de parâmetros também podem caber em 10 GB de VRAM. Isso depende do tamanho dos pesos, do cache KV e do overhead da aplicação. Se parte das camadas for transferida para a CPU, a velocidade cairá significativamente.
Limitações do PCIe
Para a MSI CMP 50HX, é especificada uma interface PCIe 1.0 x4, com largura de banda teórica de aproximadamente 1 GB/s em cada direção.
Isso não era crítico para a mineração, pois a troca de dados com a CPU era relativamente pequena. No entanto, ao carregar LLMs e transferir grandes blocos de dados, o PCIe lento aumenta o tempo de espera.
Modificações experimentais permitem mudar a interface para o modo PCIe Gen2 x4. Sua largura de banda teórica é de aproximadamente 2 GB/s em cada direção. No sistema de teste, após a modificação, a velocidade de transferência medida chegou a cerca de 1.7 GB/s.
Se o modelo couber completamente na VRAM, a velocidade de geração de tokens pode depender relativamente pouco do PCIe. Quando há transferência de camadas entre a RAM e a GPU, a influência da interface se torna muito mais perceptível.
Desempenho em mineração
A CMP 50HX foi originalmente destinada à mineração de Ethereum usando o algoritmo Ethash. A NVIDIA anunciava os seguintes números para a família CMP:
| Placa de vídeo | Ethash | Consumo de energia |
|---|---|---|
| CMP 30HX | 26 MH/s | 125 W |
| CMP 40HX | 36 MH/s | 185 W |
| CMP 50HX | 45 MH/s | 250 W |
| CMP 90HX | 86 MH/s | 320 W |
Especificações anunciadas pela NVIDIA para soluções de referência nas condições de 2021.
A CMP 50HX oferecia uma taxa de hash 25% maior que a CMP 40HX. Porém, após a transição do Ethereum para Proof of Stake, em setembro de 2022, a mineração de ETH em placas de vídeo foi encerrada.
O uso da CMP 50HX com outros algoritmos é possível, mas sua viabilidade econômica depende da dificuldade da rede e do custo da eletricidade.
É possível usar a CMP 50HX para jogos?
Apesar de ser relacionada à RTX 2080 Ti, a CMP 50HX não foi projetada para jogos.
A placa não tem saídas de vídeo, e a configuração padrão limita as funções gráficas. Drivers modificados permitem executar alguns aplicativos, mas não garantem compatibilidade com jogos.
Mesmo após o desbloqueio das operações computacionais, as limitações do pipeline gráfico permanecem. Por isso, o desempenho da RTX 2080 Ti não pode ser automaticamente transferido para a CMP 50HX.
Vale a pena comprar a NVIDIA CMP 50HX em 2026?
A CMP 50HX é interessante para experimentos com CUDA, LLMs locais e modificação de GPUs. Suas principais vantagens são os 10 GB de GDDR6, o amplo barramento de memória e a possibilidade de restaurar o desempenho computacional.
Mas ainda há limitações para um sistema comum: drivers não convencionais, PCIe lento e ausência de saídas de vídeo.
Para redes neurais locais, a GeForce RTX 3060 12 GB continua sendo uma alternativa mais versátil. Ela oferece mais memória de vídeo, suporte completo a CUDA e uma interface PCIe padrão.
A CMP 50HX vale a pena quando há uma economia significativa em relação à RTX 3060 e disposição para configurar o software por conta própria. Para uma operação estável sem modificações, uma GeForce comum é preferível.
Conclusão: a NVIDIA CMP 50HX é um acelerador especializado baseado no TU102, com 10 GB de GDDR6. O desbloqueio experimental de 2026 mostrou um aumento de 31.7 vezes no FP32 e de 28.4 vezes no DP4A, mas sua influência nas LLMs reais ainda exige medições específicas. A placa é interessante para experimentos computacionais, mas não é uma substituta completa da GeForce.
Comparação de GPU
Comparar CMP 50HX com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Comparações de GPU relacionadas


Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/pt/gpu/nvidia-cmp-50hx" target="_blank">NVIDIA CMP 50HX</a>