NVIDIA Tesla P40
NVIDIA Tesla P40: perché eseguire LLM su una scheda video del 2016
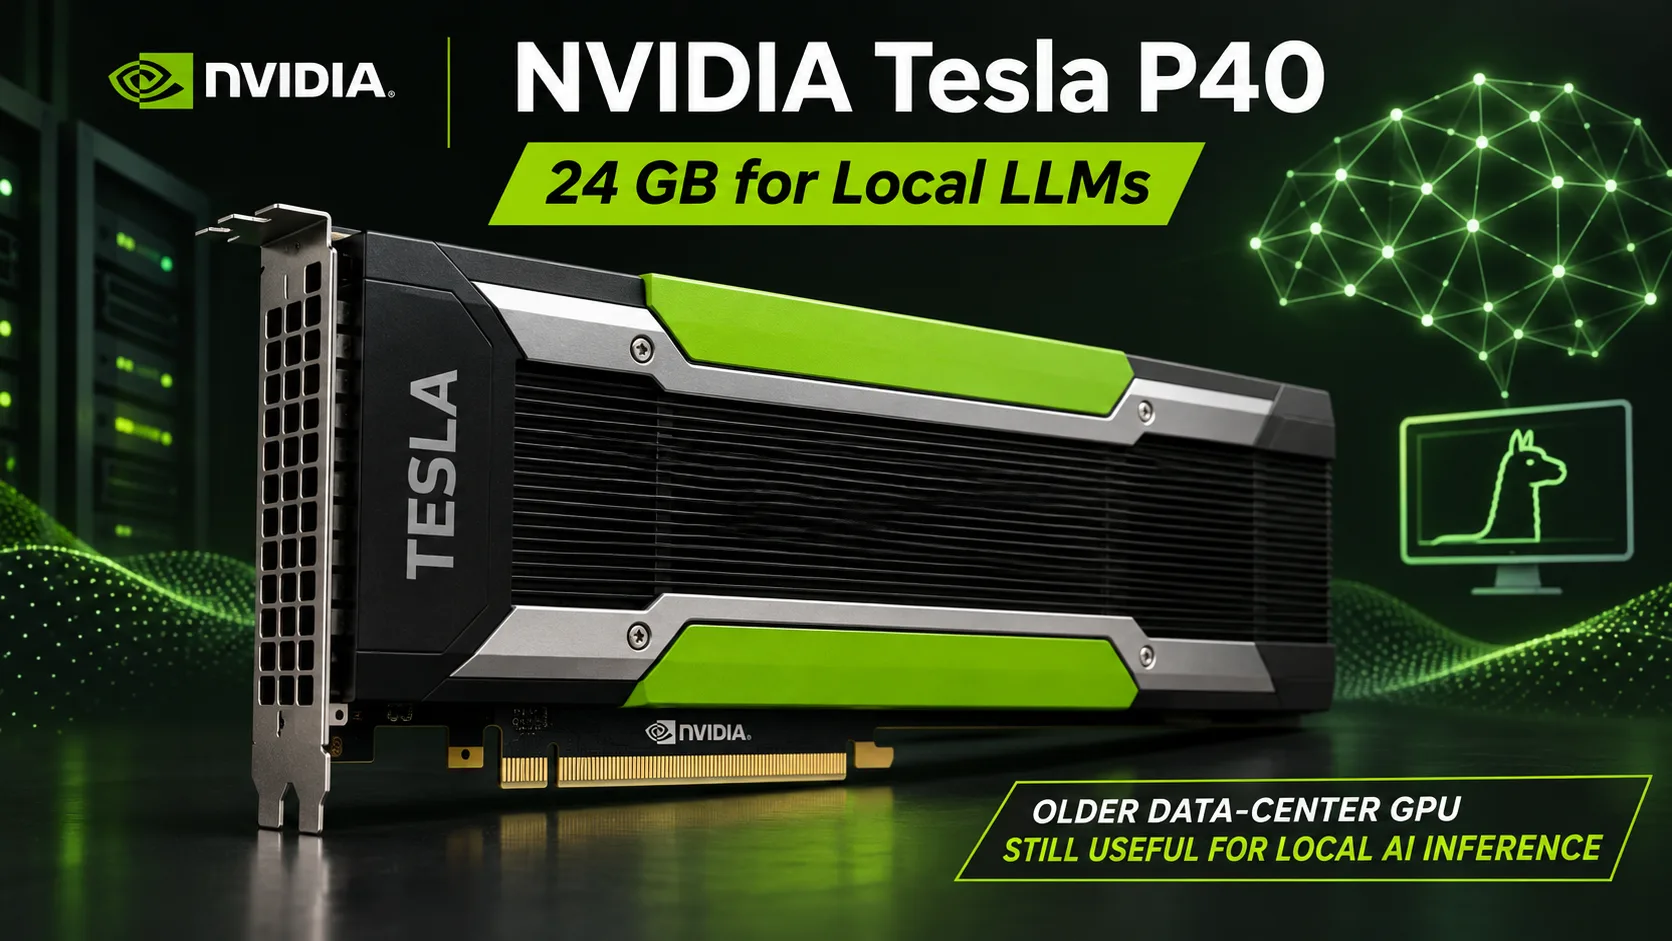
NVIDIA Tesla P40 è apparsa nel 2016 come acceleratore server per le reti neurali. Dieci anni dopo attira l’attenzione grazie ai suoi 24 GB di memoria video. Sono sufficienti per eseguire alcuni modelli linguistici da 30-32 miliardi di parametri, che non entrano nella memoria video della maggior parte delle GPU gaming economiche.
Tuttavia, l’architettura Pascal limita sensibilmente le prestazioni. Tesla P40 non dispone di Tensor Core, i calcoli FP16 vengono eseguiti lentamente e il raffreddamento passivo richiede modifiche per l’installazione in un normale computer. Quanto sono utili i suoi 24 GB nel 2026?
24 GB di memoria su architettura Pascal
Tesla P40 è basata sul chip GP102, imparentato con quello della GeForce GTX 1080 Ti. Dispone di 3840 CUDA core e una frequenza GPU di 1303-1531 MHz. La scheda è dotata di memoria GDDR5 con bus a 384 bit e una larghezza di banda di 346 GB/s.
A differenza della Tesla P100, che utilizza il chip GP100 e memoria HBM2, la P40 era orientata principalmente all’inferenza delle reti neurali. Le sue prestazioni FP16 sono di circa 0,19 TFLOPS, ossia circa 64 volte inferiori a quelle FP32.
| Scheda video | Memoria | Larghezza di banda | FP16 | Tensor Core |
|---|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB GDDR5 | 346 GB/s | ~0,19 TFLOPS | No |
| NVIDIA Tesla P100 PCIe | 16 GB HBM2 | 732 GB/s | 18,7 TFLOPS | No |
| NVIDIA Tesla V100 PCIe | 32 GB HBM2 | 900 GB/s | ~28 TFLOPS | 640 |
Per la P40, NVIDIA dichiarava fino a 12 TFLOPS in FP32 e 47 TOPS in INT8. Tuttavia, questi valori non possono essere convertiti direttamente nella velocità degli LLM moderni. Il risultato dipende dal formato del modello, dalle operazioni di calcolo utilizzate e dall’ottimizzazione software.
Prestazioni nei test con llama.cpp
Per Tesla P40, i test di generazione del testo sono i più indicativi. Di seguito sono riportati i risultati di llama.cpp con il modello Llama 2 7B quantizzato in Q4_0.
| Scheda video | Memoria | Elaborazione della richiesta, tok/s | Generazione, tok/s |
|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB | 1007 | 54,7 |
| NVIDIA Tesla P100 | 16 GB | 761 | 58,4 |
| NVIDIA Tesla V100 | 32 GB | 3043 | 129,1 |
| NVIDIA GeForce RTX 3060 | 12 GB | 2138 | 75,6 |
| NVIDIA GeForce RTX 3090 | 24 GB | 5175 | 158,2 |
Test llama-bench: elaborazione di 512 token di input (pp512) e generazione di 128 token (tg128), CUDA senza Flash Attention. I risultati sono stati ottenuti su sistemi e versioni di llama.cpp differenti, quindi il confronto ha carattere indicativo.
Durante la generazione del testo, Tesla P40 è quasi alla pari con P100, nonostante una larghezza di banda della memoria sensibilmente inferiore. RTX 3060 è più veloce di circa il 38%, mentre RTX 3090 è quasi tre volte più veloce.
Nell’elaborazione della richiesta in ingresso, la differenza è maggiore: RTX 3090 supera P40 di oltre cinque volte. Questo si nota soprattutto quando si lavora con documenti lunghi, i cui migliaia di token di input devono essere elaborati prima di generare la risposta.
Tuttavia, Llama 2 7B entra persino in 8 GB di memoria video. Un test di questo tipo mostra la velocità della GPU, ma non evidenzia il principale vantaggio della P40: la possibilità di eseguire modelli più grandi.
Quali LLM entrano in 24 GB
Un buon esempio è Qwen2.5-32B-Instruct. In formato GGUF con quantizzazione Q4_K_M, i pesi del modello occupano circa 19,9 GB. Sulla Tesla P40 rimane spazio per la cache KV e i buffer di calcolo, anche se la lunghezza del contesto disponibile dipende dalle impostazioni di avvio.
Su RTX 3060 12 GB, un modello di questo tipo non entrerà interamente. Sarà necessario utilizzare una quantizzazione più aggressiva oppure spostare parte dei calcoli nella memoria RAM.
Le possibilità della Tesla P40 dipendono dalle dimensioni e dal formato del modello:
- 7B-8B: memoria sufficiente per Q4, Q8 e un contesto relativamente lungo.
- 14B: molti modelli entrano anche in Q8_0, lasciando memoria per i dati di servizio.
- 30B-32B: è possibile l’esecuzione in Q4 con dimensioni adeguate della cache KV e degli altri buffer.
La capacità di contenimento non va confusa con le prestazioni. Un modello da 32 miliardi di parametri richiederà molti più calcoli rispetto a Llama 2 7B. I risultati riportati sopra non possono essere utilizzati per stimarne la velocità senza test separati.
Per eseguire localmente modelli GGUF quantizzati si può utilizzare llama.cpp con un backend CUDA compatibile. Quando si elaborano frequentemente documenti di grandi dimensioni o lavorano contemporaneamente più utenti, i limiti della P40 diventano più evidenti.
Installazione in un normale computer
Tesla P40 è progettata per server dotati di raffreddamento ad aria forzata. La scheda non dispone di una ventola propria e il consumo massimo raggiunge 250 W.
Durante l’installazione è necessario considerare i seguenti aspetti:
- Raffreddamento. È necessario un flusso d’aria diretto attraverso il dissipatore, in genere con una ventola separata e un convogliatore.
- Alimentazione. Viene utilizzato un connettore server CPU/EPS a 8 pin. Il normale cavo PCIe a 8 pin non può essere collegato direttamente al suo posto.
- Uscite video. HDMI e DisplayPort sono assenti. Il monitor dovrà essere collegato a un altro adattatore grafico.
- Dimensioni. La scheda è lunga circa 267 mm e occupa due slot.
Un ulteriore limite riguarda il supporto software. Tesla P40 ha Compute Capability 6.1. Con CUDA Toolkit 13.0, NVIDIA ha interrotto il supporto alla compilazione delle applicazioni per Pascal.
Per compilare programmi destinati a questa architettura sarà necessario utilizzare CUDA Toolkit 12.9 o una versione compatibile precedente. L’ultima serie di driver NVIDIA con supporto a Pascal è la R580, la cui manutenzione è prevista fino a giugno 2028.
Questo non significa che la P40 smetterà di funzionare dopo tale data. Tuttavia, le nuove versioni delle librerie di calcolo potrebbero richiedere GPU più moderne, quindi la compatibilità dei programmi dovrà essere verificata separatamente.
Vale la pena usare Tesla P40 nel 2026?
Tesla P40 conserva una sua utilità pratica grazie ai 24 GB di memoria. Permette di eseguire LLM quantizzati che non entrano in una RTX 3060 12 GB o in una Tesla P100 16 GB. Allo stesso tempo, entrambe queste schede possono essere più veloci nelle attività che non richiedono una grande quantità di memoria video.
RTX 3090, con gli stessi 24 GB, supera nettamente P40 nella velocità di generazione e di elaborazione delle richieste. Anche Tesla V100 è sensibilmente più veloce, ma la versione da 16 GB limita la scelta dei modelli più grandi, mentre quella da 32 GB risolve questo problema.
Quando si sceglie una P40 bisogna considerare non solo il costo della scheda. Il raffreddamento aggiuntivo, un’alimentazione adeguata, un consumo fino a 250 W e la necessità di utilizzare uno stack software compatibile aumentano i costi di esercizio.
Tesla P40 ha senso se per gli LLM locali servono proprio 24 GB di memoria, l’elevata velocità non è indispensabile e il costo di un sistema completo è sensibilmente inferiore rispetto alle alternative. Per una nuova workstation destinata a un utilizzo a lungo termine è preferibile una GPU più moderna.
Confronto di GPU
Confronta Tesla P40 con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati


Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/it/gpu/nvidia-tesla-p40" target="_blank">NVIDIA Tesla P40</a>