NVIDIA Tesla P40
NVIDIA Tesla P40: por que executar LLMs em uma placa de vídeo de 2016
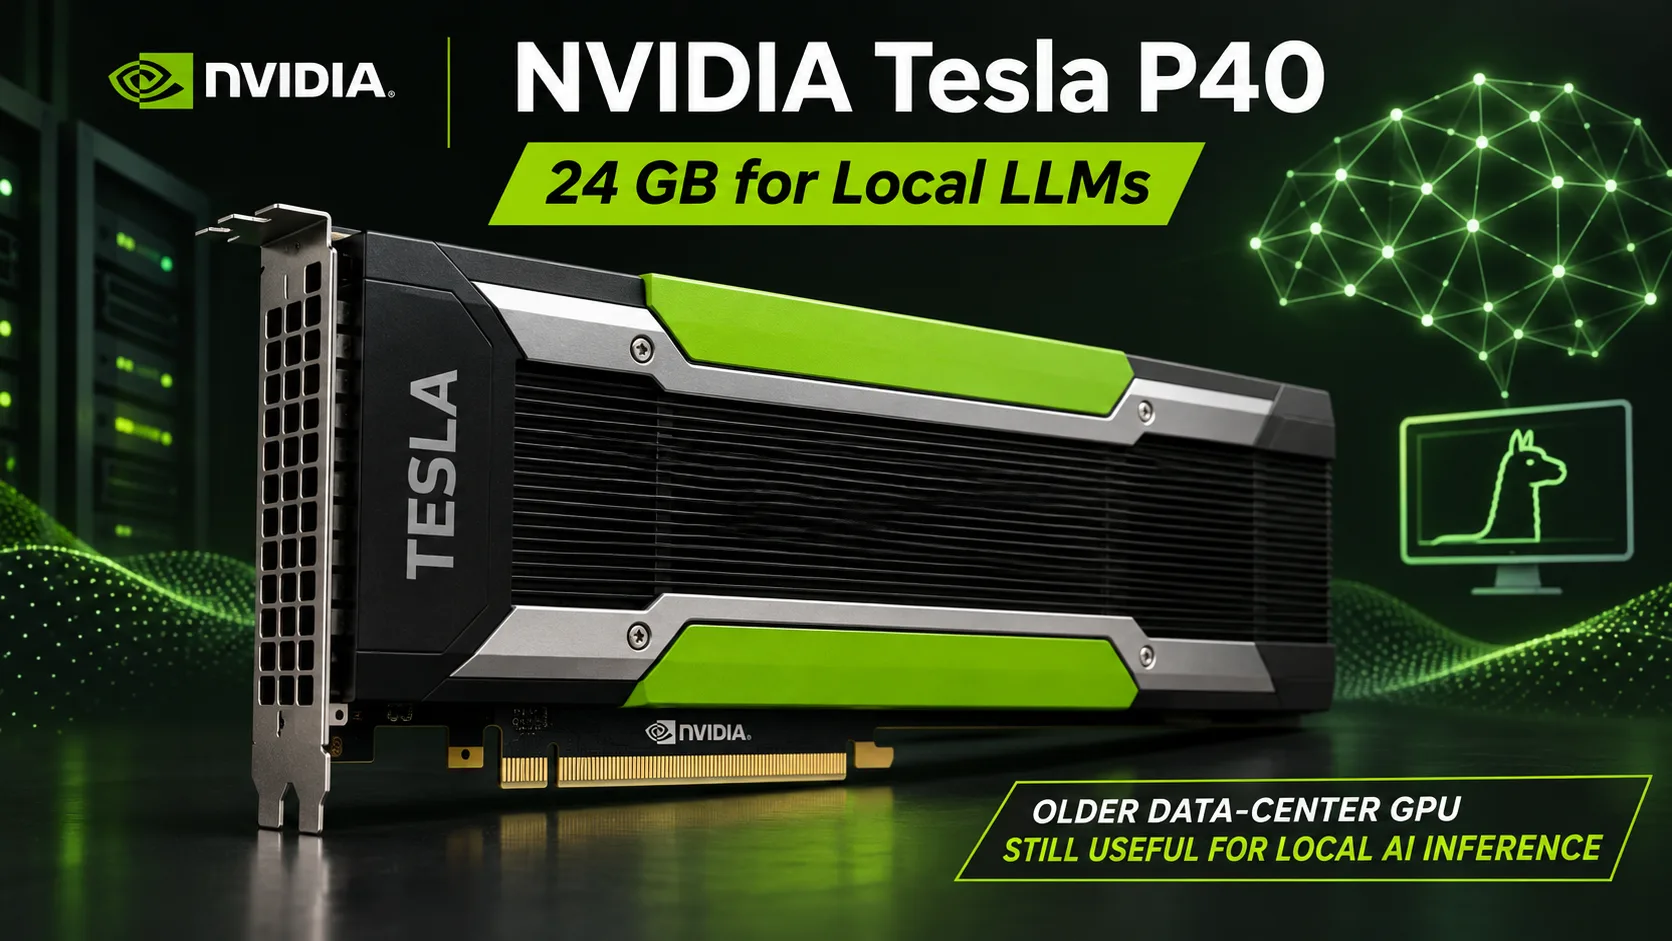
A NVIDIA Tesla P40 surgiu em 2016 como um acelerador de servidor para redes neurais. Dez anos depois, ela chama atenção graças aos 24 GB de memória de vídeo. Isso é suficiente para executar alguns modelos de linguagem com 30-32 bilhões de parâmetros, que não cabem na memória de vídeo da maioria das GPUs gamers de baixo custo.
No entanto, a arquitetura Pascal limita consideravelmente o desempenho. A Tesla P40 não tem Tensor Cores, os cálculos em FP16 são lentos, e o resfriamento passivo exige adaptações quando a placa é instalada em um computador comum. Até que ponto seus 24 GB são úteis em 2026?
24 GB de memória na arquitetura Pascal
A Tesla P40 é construída com o chip GP102, parente da GeForce GTX 1080 Ti. Ela tem 3840 núcleos CUDA, e a frequência da GPU varia de 1303 a 1531 MHz. A placa é equipada com memória GDDR5, barramento de 384 bits e largura de banda de 346 GB/s.
Ao contrário da Tesla P100, que usa o chip GP100 e memória HBM2, a P40 foi voltada principalmente para a inferência de redes neurais. Seu desempenho em FP16 é de aproximadamente 0,19 TFLOPS - cerca de 64 vezes menor que em FP32.
| Placa de vídeo | Memória | Largura de banda | FP16 | Tensor Cores |
|---|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB GDDR5 | 346 GB/s | ~0,19 TFLOPS | Não |
| NVIDIA Tesla P100 PCIe | 16 GB HBM2 | 732 GB/s | 18,7 TFLOPS | Não |
| NVIDIA Tesla V100 PCIe | 32 GB HBM2 | 900 GB/s | ~28 TFLOPS | 640 |
A NVIDIA declarava para a P40 até 12 TFLOPS em FP32 e 47 TOPS em INT8. No entanto, esses indicadores não podem ser convertidos diretamente na velocidade de LLMs modernas. O resultado depende do formato do modelo, das operações de cálculo utilizadas e da otimização do software.
Desempenho nos testes do llama.cpp
Para a Tesla P40, os testes de geração de texto são os mais representativos. A seguir estão os resultados do llama.cpp com o modelo Llama 2 7B quantizado em Q4_0.
| Placa de vídeo | Memória | Processamento do prompt, tok/s | Geração, tok/s |
|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB | 1007 | 54,7 |
| NVIDIA Tesla P100 | 16 GB | 761 | 58,4 |
| NVIDIA Tesla V100 | 32 GB | 3043 | 129,1 |
| NVIDIA GeForce RTX 3060 | 12 GB | 2138 | 75,6 |
| NVIDIA GeForce RTX 3090 | 24 GB | 5175 | 158,2 |
Teste llama-bench: processamento de 512 tokens de entrada (pp512) e geração de 128 tokens (tg128), CUDA sem Flash Attention. Os resultados foram obtidos em sistemas e versões diferentes do llama.cpp, portanto a comparação é apenas indicativa.
Na geração de texto, a Tesla P40 fica quase no mesmo nível da P100, apesar da largura de banda de memória significativamente menor. A RTX 3060 é aproximadamente 38% mais rápida, enquanto a RTX 3090 é quase três vezes mais rápida.
No processamento do prompt de entrada, a diferença é maior: a RTX 3090 supera a P40 em mais de cinco vezes. Isso é especialmente perceptível ao trabalhar com documentos longos, quando é necessário processar milhares de tokens de entrada antes de gerar a resposta.
No entanto, o Llama 2 7B cabe até mesmo em 8 GB de memória de vídeo. Esse teste mostra a velocidade da GPU, mas não revela a principal vantagem da P40: a possibilidade de executar modelos maiores.
Quais LLMs cabem em 24 GB
Um bom exemplo é o Qwen2.5-32B-Instruct. No formato GGUF com quantização Q4_K_M, os pesos do modelo ocupam cerca de 19,9 GB. Ainda sobra espaço na Tesla P40 para o cache KV e os buffers de cálculo, embora o comprimento de contexto disponível dependa das configurações de execução.
Na RTX 3060 de 12 GB, esse modelo não caberá inteiro. Será necessário usar uma quantização mais agressiva ou transferir parte dos cálculos para a memória RAM.
As possibilidades da Tesla P40 dependem do tamanho e do formato do modelo:
- 7B-8B: há memória suficiente para Q4, Q8 e um contexto relativamente longo.
- 14B: muitos modelos cabem até mesmo em Q8_0, deixando memória para dados auxiliares.
- 30B-32B: é possível executar o modelo em Q4, desde que o tamanho do cache KV e dos outros buffers seja adequado.
Não se deve confundir capacidade com desempenho. Um modelo com 32 bilhões de parâmetros exigirá muito mais cálculos que o Llama 2 7B. Os resultados apresentados acima não podem ser usados para estimar sua velocidade sem testes específicos.
Para executar localmente modelos GGUF quantizados, é possível usar o llama.cpp com um backend CUDA compatível. Ao processar documentos grandes com frequência ou trabalhar simultaneamente com vários usuários, as limitações da P40 se tornam mais evidentes.
Instalação em um computador comum
A Tesla P40 foi projetada para servidores com resfriamento por ar forçado. A placa não tem ventilador próprio, e o consumo máximo de energia chega a 250 W.
Na instalação, é necessário considerar:
- Resfriamento. É necessário direcionar um fluxo de ar através do dissipador, normalmente com um ventilador separado e um duto de ar.
- Alimentação. É usado um conector CPU/EPS de servidor de 8 pinos. Um cabo PCIe comum de 8 pinos não pode ser conectado diretamente em seu lugar.
- Saídas de vídeo. Não há HDMI nem DisplayPort. O monitor precisará ser conectado a outro adaptador gráfico.
- Dimensões. O comprimento da placa é de aproximadamente 267 mm, e sua espessura ocupa dois slots.
Há outra limitação relacionada ao suporte de software. A Tesla P40 tem Compute Capability 6.1. No CUDA Toolkit 13.0, a NVIDIA encerrou o suporte à compilação de aplicativos para Pascal.
Para compilar programas para essa arquitetura, será necessário usar o CUDA Toolkit 12.9 ou uma versão compatível anterior. A última linha de drivers da NVIDIA com suporte a Pascal é a R580, cuja manutenção está prevista até junho de 2028.
Isso não significa que a P40 deixará de funcionar após essa data. No entanto, novas versões das bibliotecas de computação podem exigir GPUs mais modernas, portanto a compatibilidade dos programas deverá ser verificada separadamente.
Vale a pena usar a Tesla P40 em 2026?
A Tesla P40 mantém seu valor prático graças aos 24 GB de memória. Ela permite executar LLMs quantizadas que não cabem em uma RTX 3060 de 12 GB ou em uma Tesla P100 de 16 GB. Ao mesmo tempo, ambas as placas podem ser mais rápidas em tarefas que não exigem muita memória de vídeo.
A RTX 3090, com os mesmos 24 GB, supera visivelmente a P40 na velocidade de geração e no processamento de prompts. A Tesla V100 também é significativamente mais rápida, mas a versão de 16 GB limita a escolha de modelos grandes, enquanto a variante de 32 GB resolve esse problema.
Ao escolher a P40, é preciso considerar não apenas o preço da placa. O resfriamento adicional, a alimentação adequada, o consumo de até 250 W e a necessidade de usar uma pilha de software compatível aumentam os custos de operação.
A Tesla P40 faz sentido se os 24 GB de memória forem indispensáveis para LLMs locais, se a alta velocidade não for obrigatória e se o custo de um sistema pronto for significativamente menor que o das alternativas. Para uma estação de trabalho nova, pensada para uso prolongado, é preferível uma GPU mais moderna.
Comparação de GPU
Comparar Tesla P40 com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Comparações de GPU relacionadas


Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/pt/gpu/nvidia-tesla-p40" target="_blank">NVIDIA Tesla P40</a>