NVIDIA CMP 50HX

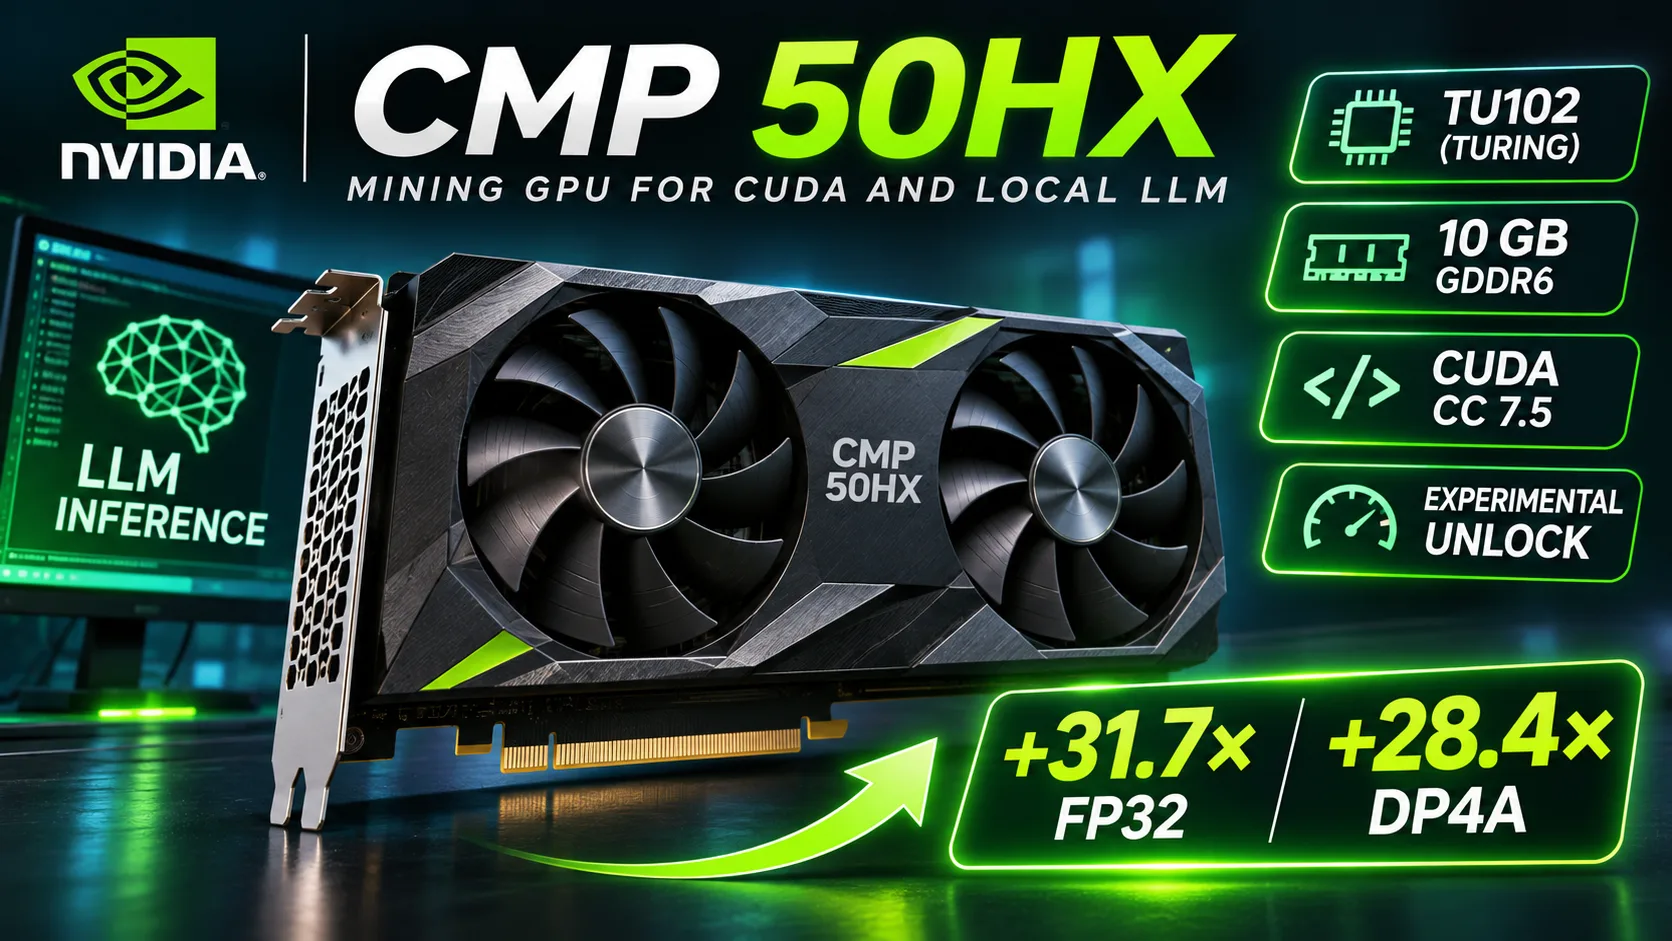
NVIDIA CMP 50HX: 10 GB di memoria per CUDA e LLM locali
NVIDIA CMP 50HX è una scheda video specializzata per il mining, lanciata nel 2021. Utilizza una GPU TU102 basata sull’architettura Turing, imparentata con quella della GeForce RTX 2080 Ti. La scheda dispone di 3584 CUDA core e 10 GB di memoria GDDR6, ma è priva di uscite video e presenta limitazioni nelle prestazioni di calcolo.
Dopo il passaggio di Ethereum al Proof of Stake, la CMP 50HX ha iniziato a essere utilizzata per esperimenti con CUDA e reti neurali locali. Con alcuni LLM raggiunge circa 30 token/s, ma la velocità dipende dal tipo di calcolo e dalla configurazione software. Nel 2026 sono comparsi metodi sperimentali per rimuovere parte delle limitazioni.
Architettura e caratteristiche
La CMP 50HX si basa sulla GPU TU102 a 12 nm con 56 multiprocessori streaming. Rispetto alla RTX 2080 Ti dispone di un numero inferiore di unità di calcolo attive e di un bus di memoria più stretto.
| Caratteristica | CMP 50HX | RTX 2080 Ti |
|---|---|---|
| CUDA core | 3584 | 4352 |
| Multiprocessori streaming | 56 | 68 |
| Memoria GDDR6 | 10 GB | 11 GB |
| Bus di memoria | 320-bit | 352-bit |
| Larghezza di banda | 560 GB/s | 616 GB/s |
| Frequenza Boost | 1545 MHz | 1545 MHz |
| PCIe | 1.0 x4 | 3.0 x16 |
| Consumo energetico | 225 W | 250 W |
| Uscite video | No | Sì |
Specifiche della MSI CMP 50HX MINER e della RTX 2080 Ti standard.
La CMP 50HX opera a frequenze comprese tra 1350 e 1545 MHz. La memoria GDDR6 a 14 Gb/s garantisce una larghezza di banda di 560 GB/s. Le prestazioni teoriche in FP32 alla frequenza Boost ammontano a circa 11.07 TFLOPS.
Tuttavia, nella configurazione standard, le prestazioni di calcolo disponibili sono sensibilmente inferiori.
Caratteristiche della CMP 50HX:
- Supporto per CUDA Compute Capability 7.5.
- 10 GB di GDDR6 per il calcolo e l’archiviazione dei modelli.
- Assenza di HDMI e DisplayPort.
- Interfaccia PCIe 1.0 x4 limitata.
- Due connettori di alimentazione aggiuntivi a 8 pin.
- Funzionalità disponibili dipendenti dai driver.
La versione MSI consuma 225 W, mentre le specifiche di riferimento NVIDIA prevedono 250 W. Per il funzionamento prolungato è necessario un flusso d’aria sufficiente all’interno del case.
Prestazioni in FP32, FP16 e INT8
La caratteristica principale della CMP 50HX sono le limitazioni software applicate ad alcune operazioni di calcolo. Nella configurazione standard, la velocità in FP32 e DP4A si riduce in modo particolarmente marcato, mentre l’FP16 è molto più veloce.
Nel settembre 2026, gli sviluppatori dello sblocco sperimentale hanno confrontato le prestazioni di una scheda con il driver normale e dello stesso driver dopo l’applicazione della modifica.
| Calcoli | Prima dello sblocco | Dopo lo sblocco | Incremento |
|---|---|---|---|
| FP32, TFLOPS | 0.427 | 13.512 | 31.7× |
| FP16 half2, TFLOPS | 26.923 | 26.698 | ≈1× |
| DP4A / INT8, TIOPS | 1.689 | 47.984 | 28.4× |
Risultati di un singolo esperimento comparativo condotto con la stessa base software. Le misurazioni dopo lo sblocco non sono specifiche di fabbrica.
Le prestazioni in FP32 sono aumentate di quasi 32 volte, mentre quelle in DP4A di oltre 28 volte. Al tempo stesso, la velocità delle normali operazioni FP16 è rimasta pressoché invariata.
Questo conferma che le limitazioni riguardano specifiche unità e istruzioni di calcolo, non l’intera GPU.
Dopo lo sblocco, l’FP32 ha raggiunto 13.51 TFLOPS, un valore superiore agli 11.07 TFLOPS teorici alla frequenza Boost di fabbrica. Il motivo è la frequenza operativa più elevata durante l’esperimento. Confrontare questi risultati senza tenere conto delle frequenze non è corretto.
In un test separato, dopo lo sblocco, l’FP16 Tensor WMMA ha raggiunto 106.8 TFLOPS. Questo risultato si riferisce alle operazioni tensoriali e non è direttamente confrontabile con l’FP16 normale riportato nella tabella.
Sblocco sperimentale nel 2026
Gli sviluppatori sono riusciti a ripristinare le prestazioni di calcolo della CMP 50HX tramite una modifica UEFI e cambiamenti alla configurazione software.
Per la versione verificata viene utilizzato il driver NVIDIA 610.43.03. Lo sblocco richiede il caricamento dell’UEFI e l’attivazione di Above 4G Decoding. È possibile mantenere Secure Boot con una firma corretta dell’applicazione UEFI e la registrazione della chiave.
Ulteriori modifiche consentono di attivare PCIe Gen2 e il supporto sperimentale a ReBAR. Tuttavia, per queste funzioni potrebbero essere necessarie modifiche separate ai driver.
I risultati sono stati confermati su specifiche configurazioni di test. La compatibilità con altre schede madri e altri sistemi deve essere verificata separatamente.
Prestazioni con gli LLM locali
I 10 GB di memoria video permettono di ospitare sulla CMP 50HX molti modelli linguistici quantizzati con 7-9 miliardi di parametri.
Nei test con Ollama e driver modificati sono stati ottenuti i seguenti risultati di generazione:
| Modello | CMP 50HX, token/s |
|---|---|
| Qwen3 8B Q4_K_M | circa 28 |
| Llama 3.1 8B Instruct Q6_K | 32 |
| Dolphin3 8B | 28 |
| Gemma 2 9B | 33 |
| Gemma 3 4B Q8_0 | 57 |
Velocità di generazione precedente allo sblocco sperimentale delle operazioni di calcolo del 2026.
Questi valori spiegano perché la CMP 50HX rimanesse adatta all’inferenza anche con prestazioni in FP32 estremamente basse.
Tuttavia, anche la limitazione della DP4A è importante. Durante l’elaborazione dei modelli quantizzati, CUDA può utilizzare operazioni intere, tra cui DP4A. La riduzione della loro velocità può limitare sia la generazione dei token sia l’elaborazione del contesto in ingresso.
L’elaborazione di prompt lunghi (prefill), in cui il carico di calcolo è maggiore, potrebbe essere particolarmente sensibile. Tuttavia, non sono ancora disponibili sufficienti misurazioni comparative confermate del prefill prima e dopo lo sblocco per trarre conclusioni quantitative.
La CMP 50HX ha una larghezza di banda della memoria di 560 GB/s, contro i 360 GB/s della RTX 3060 12 GB. Tuttavia, un’elevata larghezza di banda non garantisce di per sé una generazione più rapida: influiscono sul risultato anche le limitazioni di calcolo, le caratteristiche dei CUDA core e la quantizzazione.
Lo sblocco della DP4A crea i presupposti per accelerare gli LLM, ma l’incremento di 28 volte ottenuto nel test sintetico non può essere trasferito direttamente alla velocità di generazione dei token.
Con una quantizzazione adeguata e un contesto ridotto, anche alcuni modelli da 12-14 miliardi di parametri possono entrare nei 10 GB di VRAM. Questo dipende dalle dimensioni dei pesi, dalla KV cache e dall’overhead dell’applicazione. Se parte dei layer viene trasferita sulla CPU, la velocità diminuisce sensibilmente.
Limitazioni del PCIe
Per la MSI CMP 50HX è dichiarata un’interfaccia PCIe 1.0 x4, con una larghezza di banda teorica di circa 1 GB/s in ciascuna direzione.
Per il mining non era un limite critico, poiché lo scambio di dati con la CPU è relativamente ridotto. Tuttavia, durante il caricamento degli LLM e il trasferimento di grandi quantità di dati, il PCIe lento aumenta i tempi di attesa.
Le modifiche sperimentali consentono di portare l’interfaccia alla modalità PCIe Gen2 x4. La sua larghezza di banda teorica è di circa 2 GB/s in ciascuna direzione. Nel sistema di test, dopo la modifica, la velocità di trasferimento misurata ha raggiunto circa 1.7 GB/s.
Se il modello entra completamente nella VRAM, la velocità di generazione dei token può dipendere relativamente poco dal PCIe. Quando i layer vengono trasferiti tra la RAM e la GPU, l’influenza dell’interfaccia diventa molto più evidente.
Prestazioni nel mining
La CMP 50HX era stata inizialmente progettata per il mining di Ethereum con l’algoritmo Ethash. NVIDIA dichiarava i seguenti valori per la famiglia CMP:
| Scheda video | Ethash | Consumo energetico |
|---|---|---|
| CMP 30HX | 26 MH/s | 125 W |
| CMP 40HX | 36 MH/s | 185 W |
| CMP 50HX | 45 MH/s | 250 W |
| CMP 90HX | 86 MH/s | 320 W |
Specifiche dichiarate delle soluzioni NVIDIA di riferimento nelle condizioni del 2021.
La CMP 50HX offriva un hashrate superiore del 25% rispetto alla CMP 40HX. Tuttavia, dopo il passaggio di Ethereum al Proof of Stake nel settembre 2022, il mining di ETH sulle schede video è terminato.
L’utilizzo della CMP 50HX per altri algoritmi è possibile, ma la sua convenienza economica dipende dalla difficoltà della rete e dal costo dell’elettricità.
È possibile utilizzare la CMP 50HX per giocare?
Nonostante la parentela con la RTX 2080 Ti, la CMP 50HX non è progettata per i giochi.
La scheda non dispone di uscite video e la configurazione standard limita le funzioni grafiche. I driver modificati consentono di avviare alcune applicazioni, ma non garantiscono la compatibilità con i giochi.
Anche dopo lo sblocco delle operazioni di calcolo, rimangono le limitazioni della pipeline grafica. Pertanto, le prestazioni della RTX 2080 Ti non possono essere trasferite automaticamente alla CMP 50HX.
Conviene acquistare la NVIDIA CMP 50HX nel 2026?
La CMP 50HX è interessante per gli esperimenti con CUDA, gli LLM locali e la modifica delle GPU. I suoi principali vantaggi sono i 10 GB di GDDR6, l’ampio bus di memoria e la possibilità di ripristinare le prestazioni di calcolo.
Per un sistema di lavoro ordinario, però, rimangono alcune limitazioni: driver non standard, PCIe lento e assenza di uscite video.
Per le reti neurali locali, la GeForce RTX 3060 12 GB rimane un’alternativa più versatile. Offre più memoria video, supporto completo a CUDA e un’interfaccia PCIe standard.
La CMP 50HX può essere presa in considerazione se consente un risparmio significativo rispetto alla RTX 3060 e si è disposti a configurare autonomamente il software. Per un funzionamento stabile senza modifiche, è preferibile una normale GeForce.
Conclusione: la NVIDIA CMP 50HX è un acceleratore specializzato basato su TU102 con 10 GB di GDDR6. Lo sblocco sperimentale del 2026 ha mostrato un incremento di 31.7 volte in FP32 e di 28.4 volte in DP4A, ma il suo effetto sugli LLM reali richiede ancora misurazioni separate. La scheda è interessante per gli esperimenti di calcolo, ma non rappresenta un sostituto completo di una GeForce.
Confronto di GPU
Confronta CMP 50HX con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati


Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/it/gpu/nvidia-cmp-50hx" target="_blank">NVIDIA CMP 50HX</a>