NVIDIA GeForce RTX 5080

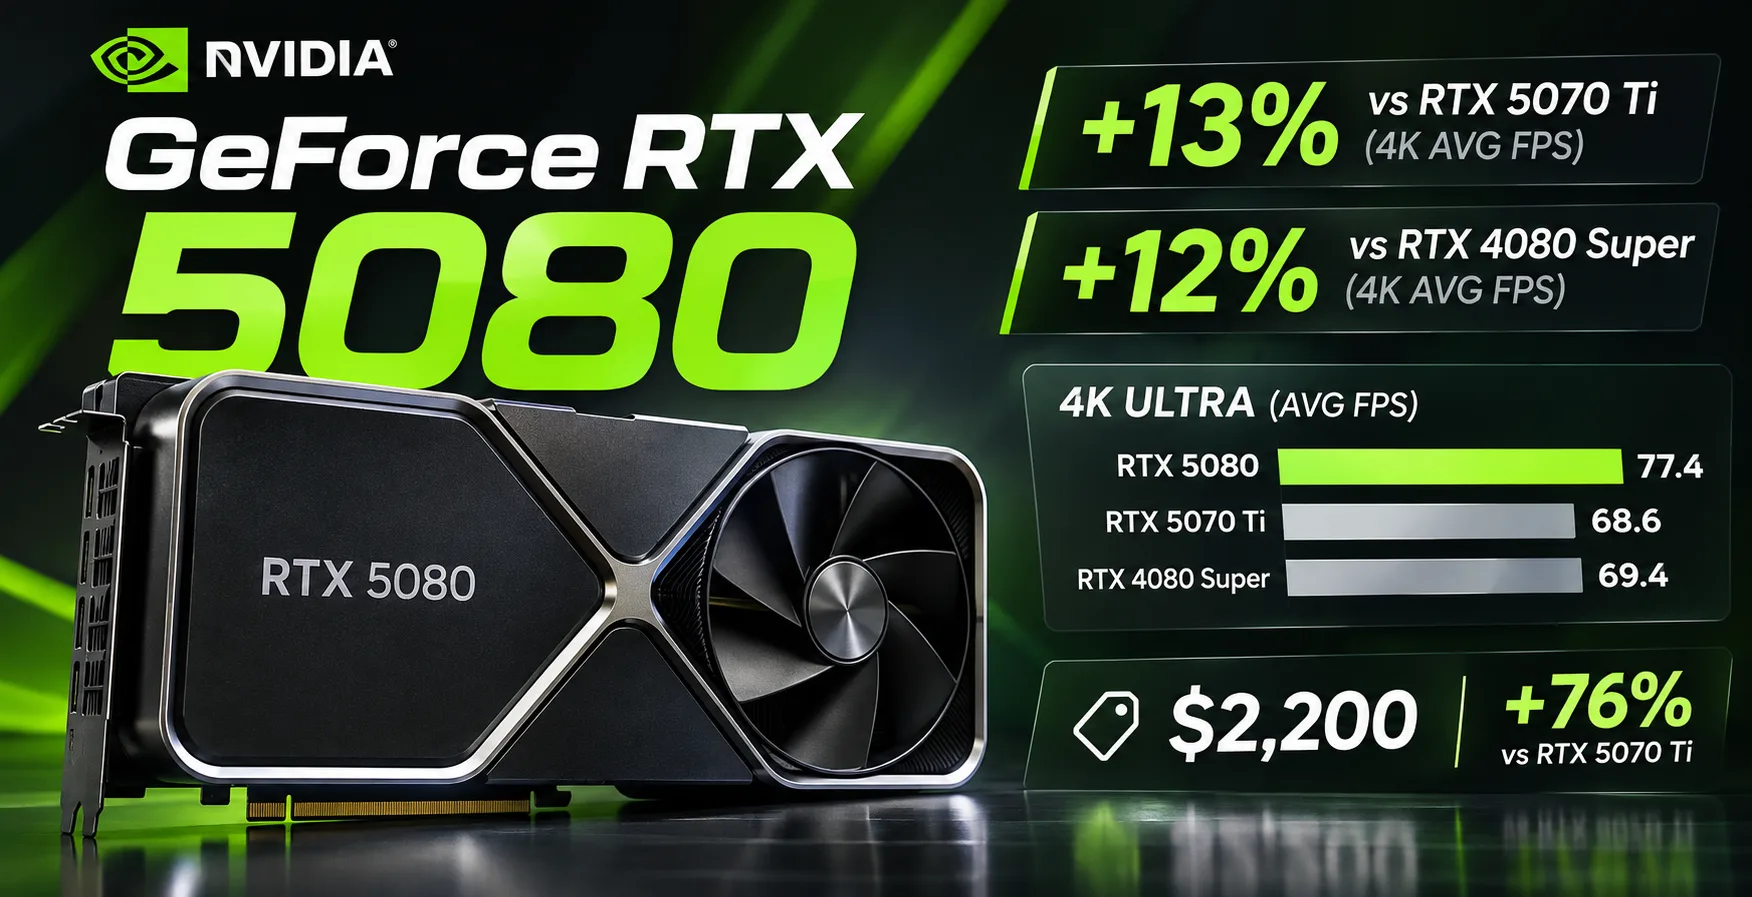
GeForce RTX 5080: 4K에서 RTX 5070 Ti보다 13% 빠르지만 가격은 76% 더 비싸다
GeForce RTX 5080은 2025년 1월 $999에 출시됐지만, 2026년 10월 미국에서 구매 가능한 제품의 최저 가격은 $2200까지 올랐다. 반면 $1250인 RTX 5070 Ti는 4K 평균 프레임 레이트에서 RTX 5080에 불과 13% 뒤처진다. 두 그래픽카드 모두 16GB 비디오 메모리를 탑재하고 DLSS Multi Frame Generation을 지원하지만, 가격 차이는 $950에 달한다.
RTX 4080 Super와 비교해도 개선 폭은 크지 않다. Tom's Hardware의 테스트 결과에 따르면 RTX 5080은 레이 트레이싱을 사용하지 않는 4K 환경에서 이전 세대 제품보다 약 12% 빠르다. RTX 5070 Ti 대비 가장 뚜렷한 우위는 무거운 레이 트레이싱을 사용하는 게임에서 나타나지만, 이 경우에도 성능 향상은 가격 차이에 미치지 못한다.
Blackwell과 GDDR7: 무엇이 달라졌나
RTX 5080은 CUDA 코어 10,752개를 탑재한 GB203 그래픽 프로세서를 기반으로 한다. RTX 4080 Super의 GDDR6X 대신 대역폭 960GB/s의 GDDR7 메모리를 사용한다. 메모리 대역폭은 30% 증가했지만, 메모리 용량은 그대로다.
| 사양 | RTX 5080 | RTX 4080 Super | RTX 5070 Ti |
|---|---|---|---|
| 아키텍처 | Blackwell | Ada Lovelace | Blackwell |
| CUDA 코어 | 10,752 | 10,240 | 8,960 |
| 메모리 | 16GB GDDR7 | 16GB GDDR6X | 16GB GDDR7 |
| 메모리 대역폭 | 960GB/s | 736GB/s | 896GB/s |
| 부스트 클럭 | 2617MHz | 2550MHz | 2452MHz |
| TGP | 360W | 320W | 300W |
RTX 5080은 4세대 RT 코어, 5세대 Tensor 코어, PCIe 5.0 및 DisplayPort 2.1b를 지원한다.
정격 TGP는 320W에서 360W로 증가했지만, 실제 소비 전력은 부하에 따라 달라진다. NVIDIA는 850W 출력의 파워 서플라이를 권장한다. 전원 연결에는 16핀 전원 케이블 또는 8핀 커넥터 3개용 기본 제공 어댑터를 사용한다.
3DMark Time Spy
| 그래픽카드 | Graphics Score |
|---|---|
| GeForce RTX 4090 | 36,676 |
| GeForce RTX 5080 | 31,987 |
| Radeon RX 9070 XT | 29,464 |
| GeForce RTX 4080 Super | 27,920 |
| GeForce RTX 5070 Ti | 27,727 |
ComputerBase 결과.
RTX 5080은 RTX 4080 Super와 RTX 5070 Ti를 약 15% 앞서지만, 이전 세대의 RTX 4090에는 뒤처진다.
게임 테스트: 업스케일링을 사용하지 않은 1440p 및 4K
2026년 6월 Tom's Hardware의 종합 결과를 통해 DLSS, FSR 및 프레임 생성을 사용하지 않은 그래픽카드 성능을 비교할 수 있다.
| 그래픽카드 | 1440p Ultra | 4K Ultra | 4K, RT |
|---|---|---|---|
| RTX 4090 | 143.4 | 89.1 | 52.2 |
| RTX 5080 | 128.3 | 77.4 | 42.1 |
| RTX 4080 Super | 118.6 | 69.4 | 38.5 |
| RTX 5070 Ti | 116.8 | 68.6 | 36.7 |
| Radeon RX 9070 XT | 116.5 | 65.8 | 30.1 |
평균 FPS. 래스터화와 레이 트레이싱은 별도의 게임 세트에서 측정했다.
1440p에서 RTX 5080은 RTX 5070 Ti보다 10% 빠르며, 4K에서는 그 차이가 13%로 커진다. RTX 4080 Super는 4K에서 신제품보다 약 12% 뒤처지고, RTX 4090은 선두를 유지한다.
레이 트레이싱을 사용하면 RTX 5080의 RTX 5070 Ti 대비 우위는 15%, Radeon RX 9070 XT 대비 우위는 40%에 달한다. 그러나 RT를 적용한 4K에서 평균 42FPS에 그친다는 것은 더 높은 프레임 레이트를 위해 업스케일링을 사용하거나 설정을 낮춰야 한다는 의미다.
Death Stranding 2: DLSS 및 FSR 비교
2026년 3월 ComputerBase 테스트에서는 매우 높음 그래픽 설정을 사용했으며, NVIDIA에는 DLSS 4 Quality, Radeon RX 9000에는 FSR 4.1 Quality를 적용했다. 프레임 생성은 비활성화했다.
| 그래픽카드 | 1440p | 4K | 4K, RT |
|---|---|---|---|
| RTX 4090 | 124.8 | 105.5 | 65.5 |
| RTX 5080 | 125.8 | 96.4 | 57.0 |
| RTX 4080 Super | 104.1 | 82.3 | 49.2 |
| RTX 5070 Ti | 110.4 | 84.6 | 49.2 |
| Radeon RX 9070 XT | 106.9 | 79.0 | 41.2 |
평균 FPS. RT 모드에서는 최대 레이 트레이싱을 사용했다. DLSS와 FSR의 화질은 서로 다를 수 있다.
RTX 5080은 4K에서 RTX 5070 Ti보다 14%, 레이 트레이싱에서는 16% 빠르다. RTX 4090은 4K에서 선두를 유지하지만, 1440p에서는 신제품보다 조금 뒤처진다.
가격: 추가 성능에 얼마를 지불해야 하나
TechSpot이 2026년 11월 2일 발표한 조사에 따르면, 10월 미국 매장에서 구매 가능한 그래픽카드의 최저 가격은 RTX 5080이 $2200, RTX 5070 Ti가 $1250, Radeon RX 9070 XT가 $870이었다.
| 그래픽카드 | 미국 가격 | 4K FPS | FPS당 가격 |
|---|---|---|---|
| RTX 5080 | $2200 | 77.4 | $28.42 |
| RTX 5070 Ti | $1250 | 68.6 | $18.22 |
| Radeon RX 9070 XT | $870 | 65.8 | $13.22 |
FPS당 가격은 레이 트레이싱을 사용하지 않은 4K Ultra 평균 결과를 기준으로 계산했다. 이 지표는 성능 대비 비용을 비교하기 위한 용도로만 사용한다.
FPS 하나당 비용으로 계산하면 RTX 5080은 RTX 5070 Ti보다 56% 비싸다. Radeon RX 9070 XT는 RTX 5080의 약 85% 수준의 성능을 제공하면서 가격은 2.5배 낮다.
RTX 5070 Ti 역시 권장 가격인 $749보다 크게 비싸졌지만, RTX 5080과 비교하면 여전히 더 합리적인 구매 선택이다.
DLSS 및 레이 트레이싱
RTX 5080은 게임 엔진이 계산한 프레임 사이에 추가 프레임을 생성하는 DLSS Multi Frame Generation을 지원한다. 이 기술은 화면의 움직임을 더 부드럽게 만들지만, 조작 반응성이 그에 비례해 향상되는 것은 아니다.
RTX 5070 Ti도 같은 기술을 지원한다. RTX 5080의 장점은 특히 path tracing을 사용하는 게임에서 더 높은 기본 프레임 레이트를 제공한다는 데 있다. 고주사율 4K 모니터 사용자에게는 이 차이가 중요할 수 있지만, 고사양 게임에서는 RTX 5080조차 업스케일링 없이 플레이하기 어려운 경우가 있다.
Blender, 영상 편집 및 신경망
RTX 5080은 CUDA, OptiX 및 AV1 하드웨어 인코딩을 지원한다. 9세대 NVENC 비디오 인코더 2개를 통해 10비트 HEVC 4:2:2를 포함한 호환 비디오 형식의 처리를 가속할 수 있다.
Puget Systems의 테스트에서 Blender Benchmark 결과는 다음과 같다.
| 그래픽카드 | Blender Benchmark |
|---|---|
| RTX 5090 | 15,872 |
| RTX 5080 | 9,035 |
| RTX 5070 Ti | 7,882 |
| Radeon RX 9070 XT | 3,722 |
RTX 5080은 RTX 5070 Ti보다 15% 빠르다. Radeon RX 9070 XT는 HIP를 통한 렌더링에서 크게 뒤처지므로, Blender를 정기적으로 사용하는 경우 NVIDIA 가속기를 선호하는 편이 낫다.
로컬 신경망 작업에서 RTX 5080은 16GB 비디오 메모리의 제약을 받는다. 예를 들어 320억 개의 파라미터를 가진 언어 모델은 4비트 양자화를 적용해도 시스템 데이터와 KV 캐시를 고려하면 일반적으로 이 용량에 전체가 들어가지 않는다. 정확한 요구 용량은 양자화 형식과 컨텍스트 크기에 따라 달라진다.
모델이 VRAM에 들어간다면 RTX 5080은 높은 연산 성능을 제공한다. 더 큰 모델을 사용할 때는 GPU의 높은 성능보다 추가 비디오 메모리 용량이 더 유용한 경우가 많다.
2026년에 GeForce RTX 5080을 구매할 가치가 있을까
가격이 $2200인 RTX 5080은 일반적인 게임 용도로 추천하기 어렵다. RTX 5070 Ti는 $950 저렴하고 동일한 16GB 메모리를 탑재했으며, 4K FPS에서 평균 13%만 뒤처진다. 높은 레이 트레이싱 성능이 필요하지 않다면 Radeon RX 9070 XT가 더욱 유리하다.
RTX 5080은 무거운 그래픽 효과를 적용한 4K 게임, Blender 및 16GB 비디오 메모리로 충분한 CUDA 작업에 적합하다. RTX 4080 Super 사용자는 업그레이드할 필요가 없다. 4K에서 약 12%에 불과한 성능 향상은 이처럼 비싼 교체를 정당화하기에 너무 작다.
GPU 비교
GeForce RTX 5080을 다른 GPUs와 비교
기초적인
메모리 사양
디스플레이 및 미디어
3x DisplayPort 2.1b
이론적 성능
여러 가지 잡다한
벤치마크
다른 GPU와 비교
관련 GPU 비교


소셜 미디어에서 공유하기
또는 링크로 소개하기
<a href="https://cputronic.com/ko/gpu/nvidia-geforce-rtx-5080" target="_blank">NVIDIA GeForce RTX 5080</a>