NVIDIA Tesla V100 PCIe 32 GB

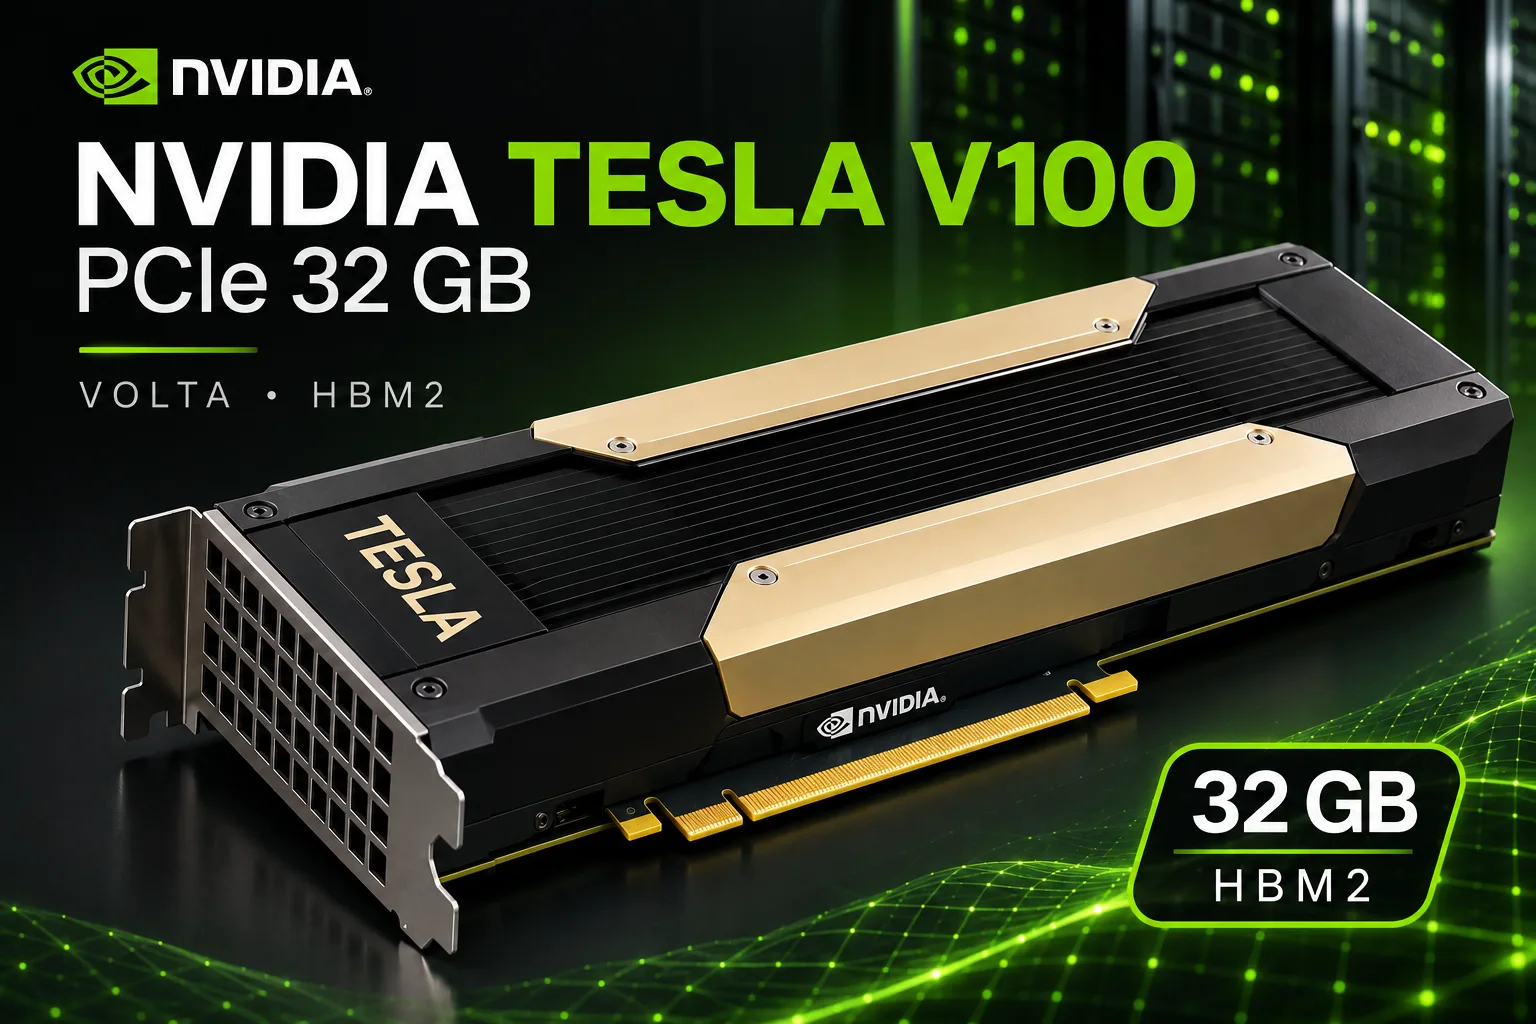
Tesla V100 PCIe 32 GB: memória para modelos de 27 bilhões de parâmetros, mas com ágio pelo conector PCIe
A Tesla V100 PCIe 32 GB é uma versão do acelerador para servidores V100 com o dobro de memória. A NVIDIA lançou a placa em março de 2018 por cerca de $11 500. Hoje, placas retiradas de serviço são vendidas no eBay por aproximadamente $700.
O chip, as frequências e a largura de banda de 900 GB/s são os mesmos da versão de 16 GB. Mas, em 2026, o que importa é justamente a capacidade. Os 32 GB comportam modelos densos de 27-32 bilhões de parâmetros em quantização de 4 bits com contexto longo, e a V100 alcança cerca de 30 tokens por segundo com eles.
Há duas desvantagens. A arquitetura Volta ficou sem novos drivers e sem CUDA 13. Além disso, a versão PCIe custa quase o triplo da versão de 16 GB e é consideravelmente mais cara que o módulo SXM2 de mesma capacidade.
Posição na linha
Todas as V100 são baseadas no chip GV100: processo de fabricação de 12 nm da TSMC, 5120 núcleos CUDA e 640 núcleos tensores de primeira geração, além de quatro stacks de HBM2 em um barramento de 4096 bits. As versões de 32 GB e os parentes mais próximos são:
| Modelo | Memória | Largura de banda | Boost | TDP | Características |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | mesma placa com metade da memória |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | dissipador passivo, sem NVLink e saídas de vídeo |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | conector de servidor SXM2, NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | atualização de 2019 |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | saídas de vídeo, driver profissional |
A especificação de desempenho da versão PCIe é de 14 TFLOPS em FP32, 7 TFLOPS em FP64 e 112 TFLOPS nos núcleos tensores. Os núcleos tensores trabalham apenas com FP16. A arquitetura Volta não tem núcleos RT, BF16 nem TF32.
Nos anúncios, a mesma placa de referência aparece com diferentes números de peça: PNY TCSV100M-32GB-PB, Dell 490-BENZ e 0HR5WD, HPE Q9U36A, Lenovo 4X67A12088 e Cisco UCSC-GPU-V100-32=.
Desempenho
Modelos de linguagem
A velocidade de geração de tokens é limitada pela largura de banda da memória. Por isso, em modelos menores, a V100 de 32 GB funciona tão rápido quanto a versão de 16 GB. Medições dos desenvolvedores do llama.cpp com uma mesma versão do código:
| Placa | Memória | gpt-oss 20B, prompt (pp2048), tok/s | gpt-oss 20B, geração (tg128), tok/s | Llama 8B Q4_0, geração, tok/s |
|---|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1362 | 65 | 52 |
| Instinct MI50/MI60 | 32 GB HBM2 | 1066 | 144 | - |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 2436 | 151 | 128 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5824 | 210 | 155 |
| GeForce RTX 4090 | 24 GB GDDR6X | 13 127 | 264 | 179 |
| GeForce RTX 5090 | 32 GB GDDR7 | 21 011 | 412 | 282 |
No gpt-oss 20B, a V100 gera tokens 28% mais lentamente que a RTX 3090 e fica no mesmo nível da placa da AMD. O teste não especifica se participou uma MI50 ou uma MI60. A V100 processa o prompt 2,3 vezes mais rápido que a AMD, mas 2,4 vezes mais lentamente que a 3090.
É por causa dos 32 GB que essa placa é escolhida para modelos densos de 27 bilhões de parâmetros. Abaixo estão relatos de proprietários: llama.cpp, uma solicitação, sem acelerações. As linhas com SXM2 também se aplicam à versão PCIe: a memória é igual nas duas, e a geração é limitada justamente por ela. As linhas com Qwen3.6 27B Q4_K_M são diretamente comparáveis.
| Configuração | Modelo e quantização | Geração, tok/s | Prompt, tok/s |
|---|---|---|---|
| V100 PCIe 32 GB | Qwen3.8 27B, UD-Q4_K_XL | 33,4 | 826 |
| V100 SXM2 32 GB | Qwen3.6 27B, Q4_K_M | 32,2 | - |
| V100 SXM2 32 GB | Qwen3.6 27B, Q8_0 | 22,8 | - |
| RTX 5090 | Qwen3.6 27B, Q4_K_M | 77 | - |
Uma velocidade de 32-33 tokens por segundo em um modelo 27B de 4 bits é suficiente para conversas e tarefas de agentes. A RTX 5090 é 2,4 vezes mais rápida, mas também custa quase 9 vezes mais.
Técnicas de software trazem ganhos maiores que a escolha entre PCIe e SXM2. Com MTP - previsão de vários tokens por etapa - o Qwen3.8 27B passa de 33 para 57 tokens por segundo. O ganho é maior em código e menor em prosa. Um fork do vLLM em uma única thread é 10% mais lento que o llama.cpp. Em compensação, com quatro solicitações simultâneas, ele produz 110 tokens por segundo no total, contra 75,7.
À medida que o contexto aumenta, a velocidade cai: de 33,4 tokens por segundo com o contexto vazio para 28 a 32 mil tokens e 15,8 a 131 mil. Também é preciso ficar de olho no resfriamento. A placa de um proprietário caiu para 15,7 tokens por segundo até que ele colocasse os ventiladores do servidor na velocidade máxima.
Em um dos testes, a V100 foi mais eficiente que a RTX 4070. No Qwen3.5 4B, ela alcançou 107 tokens por segundo a 154 W, enquanto a 4070 chegou a 91 tokens a 173 W - ou seja, 30% menos tokens por joule. A 4070 processa o prompt mais rapidamente: 5860 tokens por segundo, contra 4445.
Treinamento, cálculos e jogos
Os 32 GB permitem fazer fine-tuning de modelos maiores em FP16, mas, sem BF16 e FlashAttention 2, os pipelines modernos de treinamento precisam ser refeitos. Segundo medições da Lambda com versões SXM2, a A100 treina de 1,6 a 3,4 vezes mais rápido.
Em FP64, a V100 continua forte. Os 7 TFLOPS são aproximadamente cinco vezes mais que os da RTX 4090, e os 32 GB comportam malhas grandes para CFD e dinâmica molecular.
A placa não é adequada para jogos. Não há saídas de vídeo, DLSS nem ray tracing, e seu nível de desempenho fica um pouco abaixo da RTX 4060 Ti.
Suporte de software
A série de drivers R580 é a última com suporte à arquitetura Volta. A CUDA 13 não compila para essa arquitetura, portanto restam as versões CUDA 12.x. As compilações prontas do llama.cpp e do LM Studio estão gradualmente deixando de oferecer suporte à V100. Um proprietário relatou que a quantização do cache KV passou silenciosamente para o processador justamente por causa da ausência da Volta na CUDA 13.
A plataforma é mantida por entusiastas: forks do vLLM para sm_70, uma versão portada do ExLlamaV3 e compilações do llama.cpp com MTP. Isso é suficiente para experimentos domésticos. Em um sistema de trabalho, você ficará dependente de por quanto tempo os autores continuarão oferecendo suporte a essas soluções.
Preços e onde comprar
As V100 novas deixaram de ser fabricadas há muito tempo; hoje, a placa só é vendida usada.
| Oferta | Configuração | Preço |
|---|---|---|
| eBay dos EUA, menor preço (outubro de 2026) | V100 PCIe 32 GB | ~$685-695 |
| eBay dos EUA, média dos anúncios ativos | V100 PCIe 32 GB | ~$920 |
| Amazon / Newegg (outubro de 2026) | V100 PCIe 32 GB | $799 / $839 |
| Vendedores estrangeiros individuais | V100 PCIe 32 GB | $400-500 |
| Módulo SXM2 + adaptador | V100 SXM2 32 GB | ~$250-600 |
| IT Creations | V100S PCIe 32 GB | $8937 |
| TechMikeNY, Dell PowerEdge R740 | servidor com uma V100 PCIe 32 GB | $12 156 |
O menor preço no eBay quase não mudou desde o início do ano: cerca de $707 em fevereiro e aproximadamente $685 agora. A placa só aparece abaixo de $500 com alguns vendedores estrangeiros. Normalmente, esses anúncios não oferecem garantia, assim como os mais baratos do eBay. É preciso acrescentar à conta um ventilador com carenagem: sem o fluxo de ar de um servidor, o dissipador passivo superaquece.
Revendedores e montadores de servidores cobram uma ordem de grandeza a mais. Em uma configuração de servidor, você paga principalmente pelos processadores, pela memória e pelos discos.
Concorrentes e alternativas
Tesla V100 SXM2 32 GB com adaptador. O mesmo chip e a mesma capacidade, com frequência 10% maior; junto com o adaptador, custa $250-600. As desvantagens são a montagem por conta própria, o ventilador padrão barulhento e o consumo de 300 W sob carga. Para um PC doméstico, é o caminho mais barato para obter 32 GB de HBM2.
Duas V100 PCIe de 16 GB. Cerca de $470 pelos mesmos 32 GB. O llama.cpp dividirá o modelo entre as camadas, e a geração permanecerá no nível de uma única placa. Serão necessários dois slots x16 e uma fonte de alimentação com folga para 500 W.
GeForce RTX 3090. É 20-40% mais rápida na geração, processa o prompt 2,4 vezes mais rapidamente e oferece BF16, FlashAttention e drivers com suporte. Um modelo 27B em 4 bits cabe nos 24 GB, mas com menos folga para o contexto; um modelo 32B em Q5-Q6 já não cabe. Custa cerca de $1386, o dobro da V100.
GeForce RTX 5090. Tem os mesmos 32 GB e velocidade muito maior. Devido à escassez de memória, custa a partir de $6000, contra o preço recomendado de $1999. Isso equivale a cerca de $190 por gigabyte, contra $22 na V100.
AMD Instinct MI50 32 GB. A geração fica no nível da V100, mas o processamento do prompt é mais de duas vezes mais lento. Custa $120-210 com fornecedores do Alibaba e $500-650 no eBay. As soluções que funcionam de forma estável nela são principalmente o llama.cpp e o PyTorch básico.
Conclusão
Pelos padrões atuais, a V100 PCIe 32 GB é um acelerador lento, mas com memória grande e rápida. Ela é suficiente para manter um modelo de 27-32 bilhões de parâmetros com contexto longo e trabalhar com ele em um ritmo confortável. As limitações começam com prompts longos, treinamento e software. A placa não é adequada para sistemas de produção.
Um preço razoável para a versão PCIe seria de até $450-500. Pelo preço atual de $700, ela perde para um módulo SXM2 de 32 GB com adaptador. O ágio da versão PCIe só se justifica se a placa for instalada em um servidor de rack como o Dell R740 ou o HPE DL380: não é possível instalar um adaptador nesses equipamentos, e o fluxo de ar padrão resolve a questão do resfriamento.
Se 24 GB forem suficientes e você precisar de velocidade com suporte de software adequado, é melhor pagar a mais pela RTX 3090. Se a prioridade for obter o máximo de memória pelo menor preço, a V100 SXM2 32 GB ou a MI50 são opções mais vantajosas.
Comparação de GPU
Comparar Tesla V100 PCIe 32 GB com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Comparações de GPU relacionadas


Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/pt/gpu/nvidia-tesla-v100-pcie-32-gb" target="_blank">NVIDIA Tesla V100 PCIe 32 GB</a>