NVIDIA Tesla V100 PCIe 32 GB

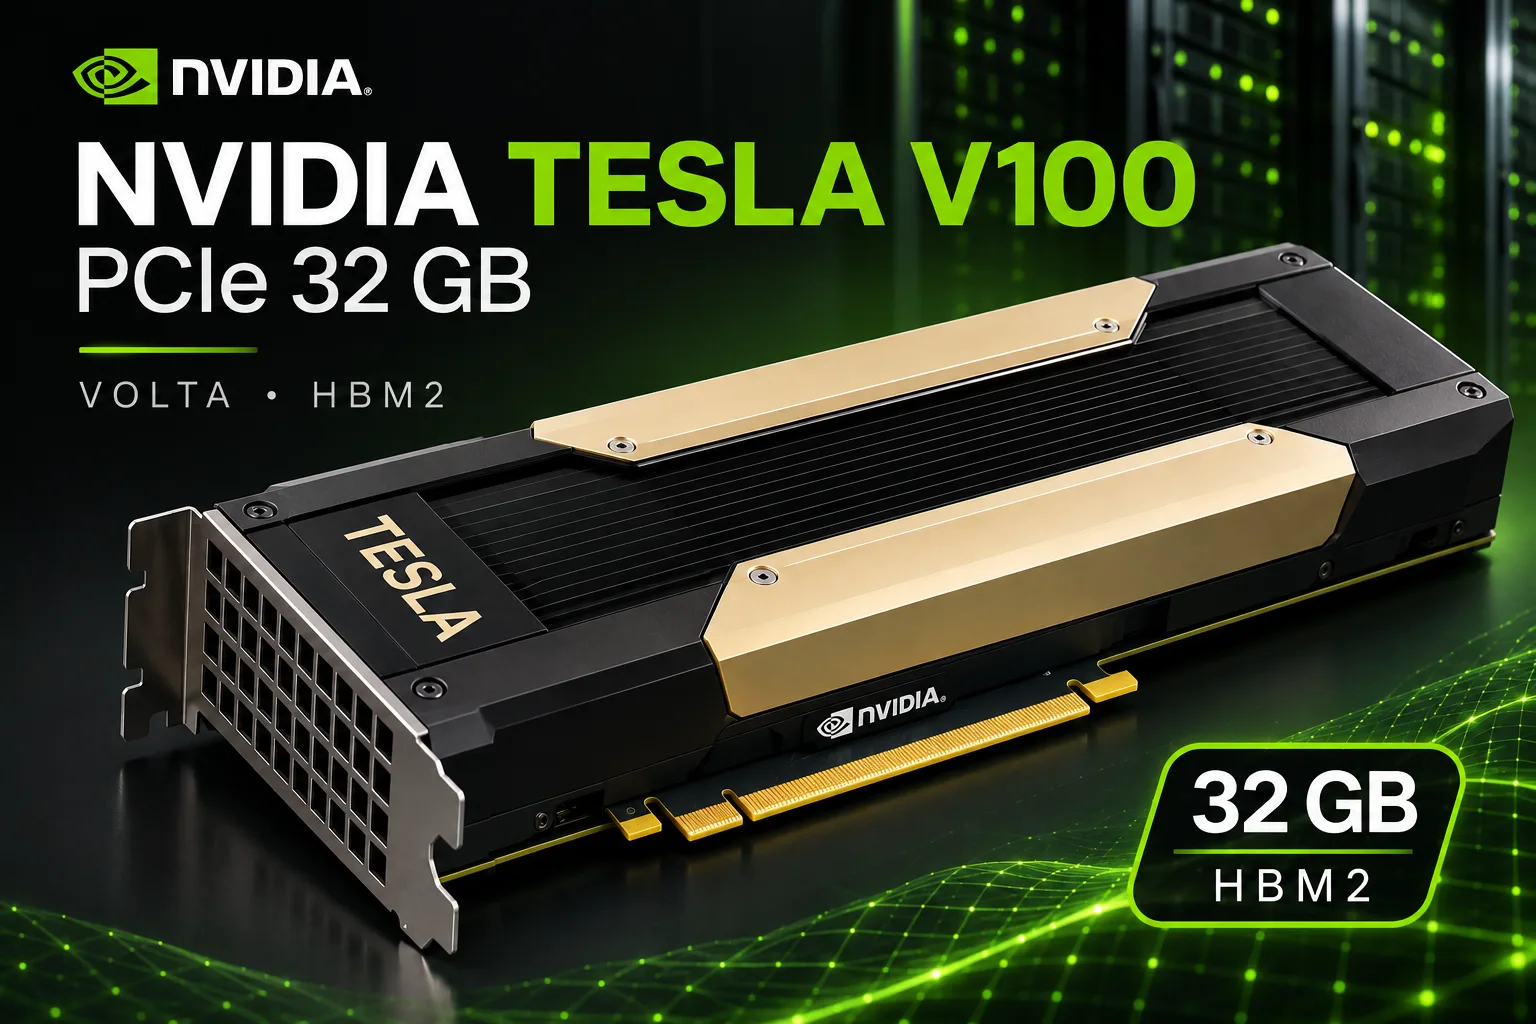
Tesla V100 PCIe 32 GB:270億パラメータモデル向けのメモリ、ただしPCIeコネクター分の割増料金
Tesla V100 PCIe 32 GBは、メモリ容量を2倍にしたサーバー向けアクセラレーターV100のバージョンだ。NVIDIAは2018年3月に、約$11,500で発売した。現在、払い下げ品はeBayでおよそ$700で販売されている。
ダイ、クロック、900 GB/sの帯域幅は16 GB版と同じだ。しかし2026年には、容量そのものが重要になる。32 GBあれば、4ビット量子化した270〜320億パラメータのdenseモデルを、長いコンテキスト付きで収められる。V100はこれらのモデルで約30トークン/秒を出す。
欠点は2つある。Voltaには新しいドライバーがなく、CUDA 13にも対応しない。またPCIe版は16 GB版のほぼ3倍、同容量のSXM2モジュールよりも明らかに高価だ。
製品ラインアップでの位置付け
V100はすべてGV100ダイを採用している。TSMCの12 nmプロセス、CUDAコア5120基、第1世代テンソルコア640基、4096ビットバス接続のHBM2を4スタック搭載する。32 GB版とその近縁モデルは以下のとおりだ。
| モデル | メモリ | 帯域幅 | Boost | TDP | 特長 |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | メモリ容量が半分の同一カード |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | パッシブヒートシンク、NVLinkと映像出力なし |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | サーバー用SXM2コネクター、NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | 2019年の改良版 |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | 映像出力、プロフェッショナルドライバー |
PCIe版の公称性能は、FP32で14 TFLOPS、FP64で7 TFLOPS、テンソルコアで112 TFLOPSだ。テンソルコアはFP16でのみ動作する。VoltaにはRTコア、BF16、TF32がない。
同じリファレンス基板が、出品によって異なるパーツ番号で登場する。PNY TCSV100M-32GB-PB、Dell 490-BENZおよび0HR5WD、HPE Q9U36A、Lenovo 4X67A12088、Cisco UCSC-GPU-V100-32=などだ。
性能
言語モデル
トークン生成速度はメモリ帯域幅に律速される。そのため、小規模なモデルでは32 GB版V100も16 GB版と同じように動作する。以下は、同じコードバージョンを使ったllama.cpp開発者による測定結果だ。
| カード | メモリ | gpt-oss 20B、プロンプト(pp2048)、トークン/秒 | gpt-oss 20B、生成(tg128)、トークン/秒 | Llama 8B Q4_0、生成、トークン/秒 |
|---|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1362 | 65 | 52 |
| Instinct MI50/MI60 | 32 GB HBM2 | 1066 | 144 | - |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 2436 | 151 | 128 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5824 | 210 | 155 |
| GeForce RTX 4090 | 24 GB GDDR6X | 13 127 | 264 | 179 |
| GeForce RTX 5090 | 32 GB GDDR7 | 21 011 | 412 | 282 |
gpt-oss 20Bでは、V100の生成速度はRTX 3090より28%遅く、AMDのカードと同等だ。ただし、このテストでMI50とMI60のどちらが使われたかは明記されていない。V100のプロンプト処理はAMDより2.3倍速い一方、3090より2.4倍遅い。
このカードが選ばれる理由は、270億パラメータのdenseモデルを収められる32 GBにある。以下は所有者によるレポートで、llama.cppを使い、1リクエスト、追加の高速化なしで測定している。SXM2の行はPCIe版にも当てはまる。メモリ容量が同じで、生成はまさにメモリに律速されるためだ。直接比較できるのは、Qwen3.6 27B Q4_K_Mの行である。
| 構成 | モデルと量子化 | 生成、トークン/秒 | プロンプト、トークン/秒 |
|---|---|---|---|
| V100 PCIe 32 GB | Qwen3.8 27B、UD-Q4_K_XL | 33.4 | 826 |
| V100 SXM2 32 GB | Qwen3.6 27B、Q4_K_M | 32.2 | - |
| V100 SXM2 32 GB | Qwen3.6 27B、Q8_0 | 22.8 | - |
| RTX 5090 | Qwen3.6 27B、Q4_K_M | 77 | - |
4ビットの27Bモデルで32〜33トークン/秒出れば、チャットやエージェントタスクには十分だ。RTX 5090は2.4倍高速だが、価格もほぼ9倍になる。
ソフトウェア上の工夫は、PCIe版とSXM2版の選択以上に大きな効果をもたらす。MTP(1ステップで複数トークンを予測)を使うと、Qwen3.8 27Bは33トークン/秒から57トークン/秒に高速化する。伸びが最も大きいのはコードで、文章では小さい。vLLMのフォークは、1スレッドではllama.cppより10%遅い。しかし4つの同時リクエストでは、合計110トークン/秒を出し、75.7トークン/秒にとどまるllama.cppを上回る。
コンテキストが長くなるほど速度は低下する。空のコンテキストでは33.4トークン/秒だが、32,000トークンでは28、131,000トークンでは15.8まで落ちる。冷却にも注意が必要だ。ある所有者のカードは、サーバーのファンを最大まで回すまで、15.7トークン/秒まで速度が低下していた。
あるテストでは、V100がRTX 4070より電力効率で優れていた。Qwen3.5 4BでV100は154 W時に107トークン/秒、4070は173 W時に91トークン/秒だった。つまり、1ジュールあたりのトークン数は30%少ない。プロンプト処理は4070のほうが速く、5860トークン/秒に対してV100は4445トークン/秒だった。
学習、計算、ゲーム
32 GBあれば、より大きなモデルをFP16で追加学習できる。しかしBF16とFlashAttention 2がないため、現代的な学習パイプラインは作り直さなければならない。SXM2版を使ったLambdaの測定では、A100のほうが1.6〜3.4倍高速だった。
FP64では、V100は今でも強い。7 TFLOPSはRTX 4090の約5倍であり、32 GBにはCFDや分子動力学向けの大規模な計算格子を収められる。
ゲーム用途には向かない。映像出力、DLSS、レイトレーシングがなく、性能もRTX 4060 Tiを少し下回る。
ソフトウェアサポート
ドライバーブランチR580が、Voltaをサポートする最後のブランチだ。CUDA 13はこのアーキテクチャ向けにはコンパイルできないため、使えるのはCUDA 12.xまでとなる。llama.cppやLM Studioの既成ビルドも、V100のサポートを徐々に失っている。ある所有者の環境では、CUDA 13にVoltaが含まれていないことが原因で、KVキャッシュの量子化が何の警告もなくCPU処理に移行した。
このプラットフォームを支えているのは、愛好家たちだ。sm_70対応のvLLMフォーク、ExLlamaV3の移植版、MTP対応のllama.cppビルドなどがある。自宅での実験にはこれで十分だ。しかし実運用システムでは、開発者があとどれだけサポートを続けるかに依存することになる。
価格と入手先
新品のV100はとっくに生産終了しており、現在は中古品しか販売されていない。
| 販売例 | 構成 | 価格 |
|---|---|---|
| 米国eBay、最安値(2026年10月) | V100 PCIe 32 GB | ~$685-695 |
| 米国eBay、出品中の商品での平均価格 | V100 PCIe 32 GB | ~$920 |
| Amazon / Newegg(2026年10月) | V100 PCIe 32 GB | $799 / $839 |
| 一部の海外販売業者 | V100 PCIe 32 GB | $400-500 |
| SXM2モジュール+アダプター | V100 SXM2 32 GB | ~$250-600 |
| IT Creations | V100S PCIe 32 GB | $8937 |
| TechMikeNY、Dell PowerEdge R740 | V100 PCIe 32 GBを1枚搭載したサーバー | $12 156 |
eBayの最安値は年初からほとんど動いていない。2月は約$707、現在は約$685だ。$500未満のカードは、一部の海外販売業者でしか見つからない。このような出品には、eBayの最安出品と同様、通常は保証がない。サーバー用の送風がなければパッシブヒートシンクが過熱するため、シュラウド付きファンの費用も加える必要がある。
リセラーやサーバー組み立て業者の価格は一桁多い。サーバー構成では、主にCPU、メモリ、ストレージに対して料金を支払うことになる。
競合製品と代替案
Tesla V100 SXM2 32 GB+アダプター。 同じダイ、同じ容量で、クロックは10%高い。アダプター込みで$250-600だ。欠点は、自分で組み立てる必要があること、標準ファンがうるさいこと、負荷時に300 Wを消費すること。自作PCで32 GBのHBM2を手に入れる最も安い方法だ。
V100 PCIe 16 GBを2枚。 同じ32 GBを約$470で実現できる。llama.cppはモデルをレイヤー単位で分割するため、生成速度は1枚の場合と同程度にとどまる。x16スロットが2つ必要で、電源も500 W分の余裕が必要になる。
GeForce RTX 3090。 生成速度は20〜40%速く、プロンプト処理は2.4倍速い。さらにBF16、FlashAttention、サポートのあるドライバーを利用できる。4ビットの27Bモデルは24 GBに収まるが、コンテキスト用の余裕は少なくなる。32BのQ5〜Q6はもう収まらない。価格は約$1386で、V100の2倍だ。
GeForce RTX 5090。 同じ32 GBを搭載し、速度ははるかに高い。メモリ不足のため、推奨価格が$1999であるにもかかわらず、価格は$6000からとなっている。1 GBあたり約$190で、V100の$22に対して大幅に高い。
AMD Instinct MI50 32 GB。 生成速度はV100と同等で、プロンプト処理は2倍以上遅い。Alibabaの業者では$120-210、eBayでは$500-650で購入できる。安定して動作するのは、主にllama.cppと基本的なPyTorchだ。
まとめ
現在の基準では、V100 PCIe 32 GBは、大容量で高速なメモリを備えた低速な計算デバイスだ。270〜320億パラメータのモデルを長いコンテキスト付きで載せ、快適な速度で動かすには十分である。制約が出てくるのは、長いプロンプト、学習、ソフトウェアだ。実運用システムには向いていない。
PCIe版の妥当な価格は$450-500までだ。現在の$700では、アダプター付きの32 GB SXM2モジュールに負ける。PCIe版への割増料金が正当化されるのは、Dell R740やHPE DL380のようなラックサーバーに搭載する場合だけだ。そこにはアダプターを取り付けられず、標準の送風によって冷却の問題も解決できる。
24 GBで足りて、通常のソフトウェアサポートと速度が必要なら、RTX 3090に追加料金を払うほうがよい。最小限の出費で最大容量のメモリが必要なら、V100 SXM2 32 GBかMI50のほうが得だ。
GPUの比較
Tesla V100 PCIe 32 GBを他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較
関連する GPU の比較


ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/ja/gpu/nvidia-tesla-v100-pcie-32-gb" target="_blank">NVIDIA Tesla V100 PCIe 32 GB</a>