NVIDIA CMP 50HX

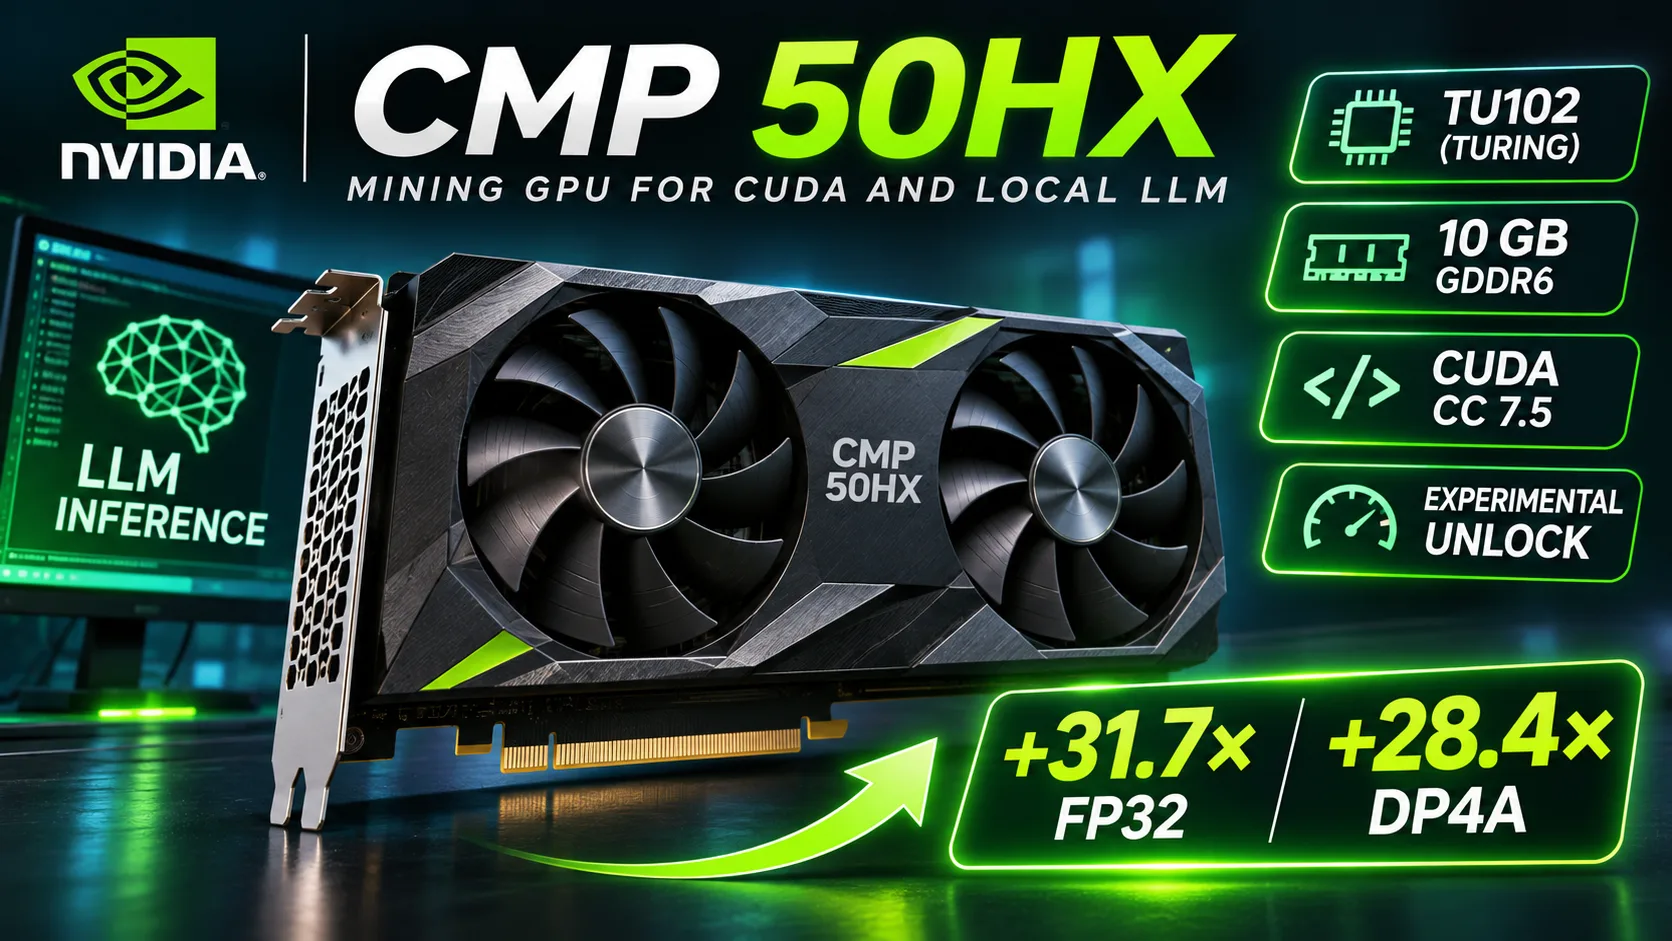
NVIDIA CMP 50HX:CUDAとローカルLLM向け10 GBメモリ
NVIDIA CMP 50HXは、2021年に発売されたマイニング向けの専用ビデオカードです。GeForce RTX 2080 TiのGPUと同系統の、TuringアーキテクチャによるTU102 GPUを採用しています。3584基のCUDAコアと10 GBのGDDR6メモリを搭載していますが、映像出力を備えず、演算性能にも制限があります。
EthereumがProof of Stakeへ移行した後、CMP 50HXはCUDAやローカルニューラルネットワークの実験に使われるようになりました。一部のLLMでは約30トークン/秒を実現しますが、速度は計算の種類やソフトウェア構成によって異なります。2026年には、制限の一部を解除する実験的な方法も登場しました。
アーキテクチャと仕様
CMP 50HXは、56基のストリーミングマルチプロセッサを備えた12 nmのTU102 GPUをベースにしています。RTX 2080 Tiと比べると、アクティブな演算ユニットが少なく、メモリバスも狭くなっています。
| 仕様 | CMP 50HX | RTX 2080 Ti |
|---|---|---|
| CUDAコア | 3584 | 4352 |
| ストリーミングマルチプロセッサ | 56 | 68 |
| GDDR6メモリ | 10 GB | 11 GB |
| メモリバス | 320-bit | 352-bit |
| メモリ帯域幅 | 560 GB/s | 616 GB/s |
| Boostクロック | 1545 MHz | 1545 MHz |
| PCIe | 1.0 x4 | 3.0 x16 |
| 消費電力 | 225 W | 250 W |
| 映像出力 | なし | あり |
MSI CMP 50HX MINERおよび標準的なRTX 2080 Tiの仕様。
CMP 50HXは1350~1545 MHzで動作します。14 Gb/sのGDDR6メモリにより、メモリ帯域幅は560 GB/sです。Boostクロック時の理論上のFP32性能は約11.07 TFLOPSです。
ただし、標準構成では利用可能な演算性能が大幅に低下します。
CMP 50HXの特徴:
- CUDA Compute Capability 7.5をサポート。
- 計算およびモデルの保存に使える10 GB GDDR6。
- HDMIおよびDisplayPortを搭載しない。
- PCIe 1.0 x4に制限されたインターフェース。
- 8ピンの補助電源コネクターを2基搭載。
- 利用可能な機能がドライバに依存。
MSI版の消費電力は225 Wですが、NVIDIAのリファレンス仕様では250 Wとされています。長時間動作させるには、ケース内部に十分なエアフローが必要です。
FP32、FP16、INT8の性能
CMP 50HXの最大の特徴は、一部の演算にソフトウェア上の制限があることです。標準構成では、特にFP32とDP4Aの速度が大きく低下します。一方、FP16は大幅に高速に動作します。
2026年9月、実験的なアンロックを開発した開発者が、通常のドライバを使用したカードと、同じドライバに変更を加えた場合の性能を比較しました。
| 演算 | アンロック前 | アンロック後 | 向上率 |
|---|---|---|---|
| FP32、TFLOPS | 0.427 | 13.512 | 31.7× |
| FP16 half2、TFLOPS | 26.923 | 26.698 | ≈1× |
| DP4A / INT8、TIOPS | 1.689 | 47.984 | 28.4× |
同一のソフトウェア基盤で行った、1枚のカードによる比較実験の結果。アンロック後の測定値は工場出荷時の仕様ではありません。
FP32の性能は約32倍、DP4Aは28倍以上向上しました。一方、通常のFP16演算の速度はほとんど変化していません。
このことから、制限はGPU全体ではなく、特定の演算ブロックや命令に及んでいることが分かります。
アンロック後のFP32は13.51 TFLOPSに達し、工場出荷時のBoostクロックにおける理論値11.07 TFLOPSを上回りました。これは、実験中の動作周波数がより高かったことが原因です。周波数を考慮せずにこれらの結果を比較するのは適切ではありません。
別のテストでは、アンロック後のFP16 Tensor WMMAが106.8 TFLOPSに達しました。この結果はテンソル演算に関するものであり、表に示した通常のFP16の値と直接比較することはできません。
2026年に行われた実験的なアンロック
開発者は、UEFIの改変とソフトウェア構成の変更によって、CMP 50HXの演算性能を復元することに成功しました。
検証されたバージョンでは、NVIDIAドライバ610.43.03を使用します。アンロックにはUEFIの読み込みと、Above 4G Decodingの有効化が必要です。UEFIアプリケーションに適切な署名を施してキーを登録すれば、Secure Bootを維持できます。
追加の改変により、PCIe Gen2や実験的なReBARサポートも利用できます。ただし、これらの機能にはドライバへの個別の変更が必要になる場合があります。
結果は、特定のテスト構成で確認されたものです。他のマザーボードやシステムとの互換性については、個別に検証する必要があります。
ローカルLLMでの性能
10 GBのビデオメモリにより、CMP 50HXには7~9 billionパラメーターの量子化言語モデルの多くを配置できます。
改変したドライバを使用してOllamaでテストしたところ、次の生成速度が得られました。
| モデル | CMP 50HX、トークン/秒 |
|---|---|
| Qwen3 8B Q4_K_M | 約28 |
| Llama 3.1 8B Instruct Q6_K | 32 |
| Dolphin3 8B | 28 |
| Gemma 2 9B | 33 |
| Gemma 3 4B Q8_0 | 57 |
2026年の演算機能の実験的アンロック以前における生成速度。
これらの数値は、FP32性能が極めて低い状態でもCMP 50HXが推論に利用可能だった理由を示しています。
ただし、DP4Aの制限も重要です。量子化モデルの処理では、CUDAがDP4Aを含む整数演算を使用することがあります。これらの演算速度が低下すると、トークン生成だけでなく、入力コンテキストの処理も制限される可能性があります。
特に、演算負荷が高くなる長いプロンプトの処理(prefill)は、この影響を受けやすい可能性があります。ただし、アンロック前後のprefillを比較した確定的な測定結果は、現時点では定量的な結論を出すには不十分です。
CMP 50HXのメモリ帯域幅は560 GB/sで、RTX 3060 12 GBの360 GB/sを上回ります。しかし、メモリ帯域幅が高いだけで生成速度が向上するとは限りません。演算制限、CUDAコアの特性、量子化の方式も結果に影響します。
DP4AのアンロックはLLMの高速化につながる前提条件となりますが、合成テストでの28倍という向上率を、そのままトークン生成速度に当てはめることはできません。
適切な量子化と小さなコンテキストであれば、12~14 billionパラメーターの一部のモデルも10 GBのVRAMに収まる可能性があります。これは、重みのサイズ、KVキャッシュ、アプリケーションのオーバーヘッドによって変わります。一部のレイヤーをCPUにオフロードすると、速度は大幅に低下します。
PCIeの制限
MSI CMP 50HXには、各方向で約1 GB/sの理論帯域幅を持つPCIe 1.0 x4インターフェースが搭載されているとされています。
マイニングではCPUとのデータ交換が比較的少ないため、これは重大な問題ではありませんでした。しかし、LLMの読み込みや大容量データの転送では、低速なPCIeによって待ち時間が増加します。
実験的な改変により、インターフェースをPCIe Gen2 x4モードに切り替えることができます。その理論帯域幅は各方向で約2 GB/sです。テストシステムでは、改変後の実測転送速度は約1.7 GB/sに達しました。
モデルが完全にVRAMへ収まる場合、トークン生成速度はPCIeの影響を比較的受けにくい可能性があります。RAMとGPUの間でレイヤーを移動させる場合は、インターフェースの影響が大幅に大きくなります。
マイニング性能
CMP 50HXは当初、EthashアルゴリズムによるEthereumのマイニングを目的としていました。NVIDIAは、CMPシリーズについて次の数値を公表していました。
| ビデオカード | Ethash | 消費電力 |
|---|---|---|
| CMP 30HX | 26 MH/s | 125 W |
| CMP 40HX | 36 MH/s | 185 W |
| CMP 50HX | 45 MH/s | 250 W |
| CMP 90HX | 86 MH/s | 320 W |
2021年時点のNVIDIAリファレンスソリューションについて公表された仕様。
CMP 50HXのハッシュレートはCMP 40HXより25%高いものでした。しかし、2022年9月にEthereumがProof of Stakeへ移行した後、ビデオカードによるETHのマイニングは終了しました。
CMP 50HXを他のアルゴリズムで使用することは可能ですが、採算性はネットワークの難易度と電気料金によって決まります。
CMP 50HXはゲームに使えるのか
RTX 2080 Tiと同系統のGPUを採用しているとはいえ、CMP 50HXはゲーム向けではありません。
映像出力を備えておらず、標準構成ではグラフィックス機能も制限されています。改変したドライバによって一部のアプリケーションを起動できる場合はありますが、ゲームとの互換性が保証されるわけではありません。
演算機能をアンロックした後も、グラフィックスパイプラインの制限は残ります。そのため、RTX 2080 Tiの性能をそのままCMP 50HXに当てはめることはできません。
2026年にNVIDIA CMP 50HXを購入すべきか
CMP 50HXは、CUDA、ローカルLLM、GPUの改変を実験する用途で興味深い製品です。主な利点は、10 GBのGDDR6、広いメモリバス、そして演算性能を復元できる可能性です。
しかし、一般的なワークシステムでは、非標準のドライバ、低速なPCIe、映像出力の欠如という制限が残ります。
ローカルニューラルネットワーク向けには、GeForce RTX 3060 12 GBのほうが汎用的な代替製品です。より多くのビデオメモリ、完全なCUDAサポート、標準的なPCIeインターフェースを備えています。
CMP 50HXは、RTX 3060より大幅に安く、ソフトウェアを自分で設定する準備がある場合に検討する意味があります。改変なしで安定して動作させたいなら、通常のGeForceのほうが適しています。
**結論:**NVIDIA CMP 50HXは、10 GBのGDDR6を搭載するTU102ベースの専用アクセラレーターです。2026年の実験的なアンロックでは、FP32が31.7倍、DP4Aが28.4倍に向上しましたが、実際のLLMへの影響については、別途測定が必要です。このカードは演算実験には興味深い存在ですが、GeForceの完全な代替製品ではありません。
GPUの比較
CMP 50HXを他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較


ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/ja/gpu/nvidia-cmp-50hx" target="_blank">NVIDIA CMP 50HX</a>