NVIDIA Tesla V100 PCIe 32 GB

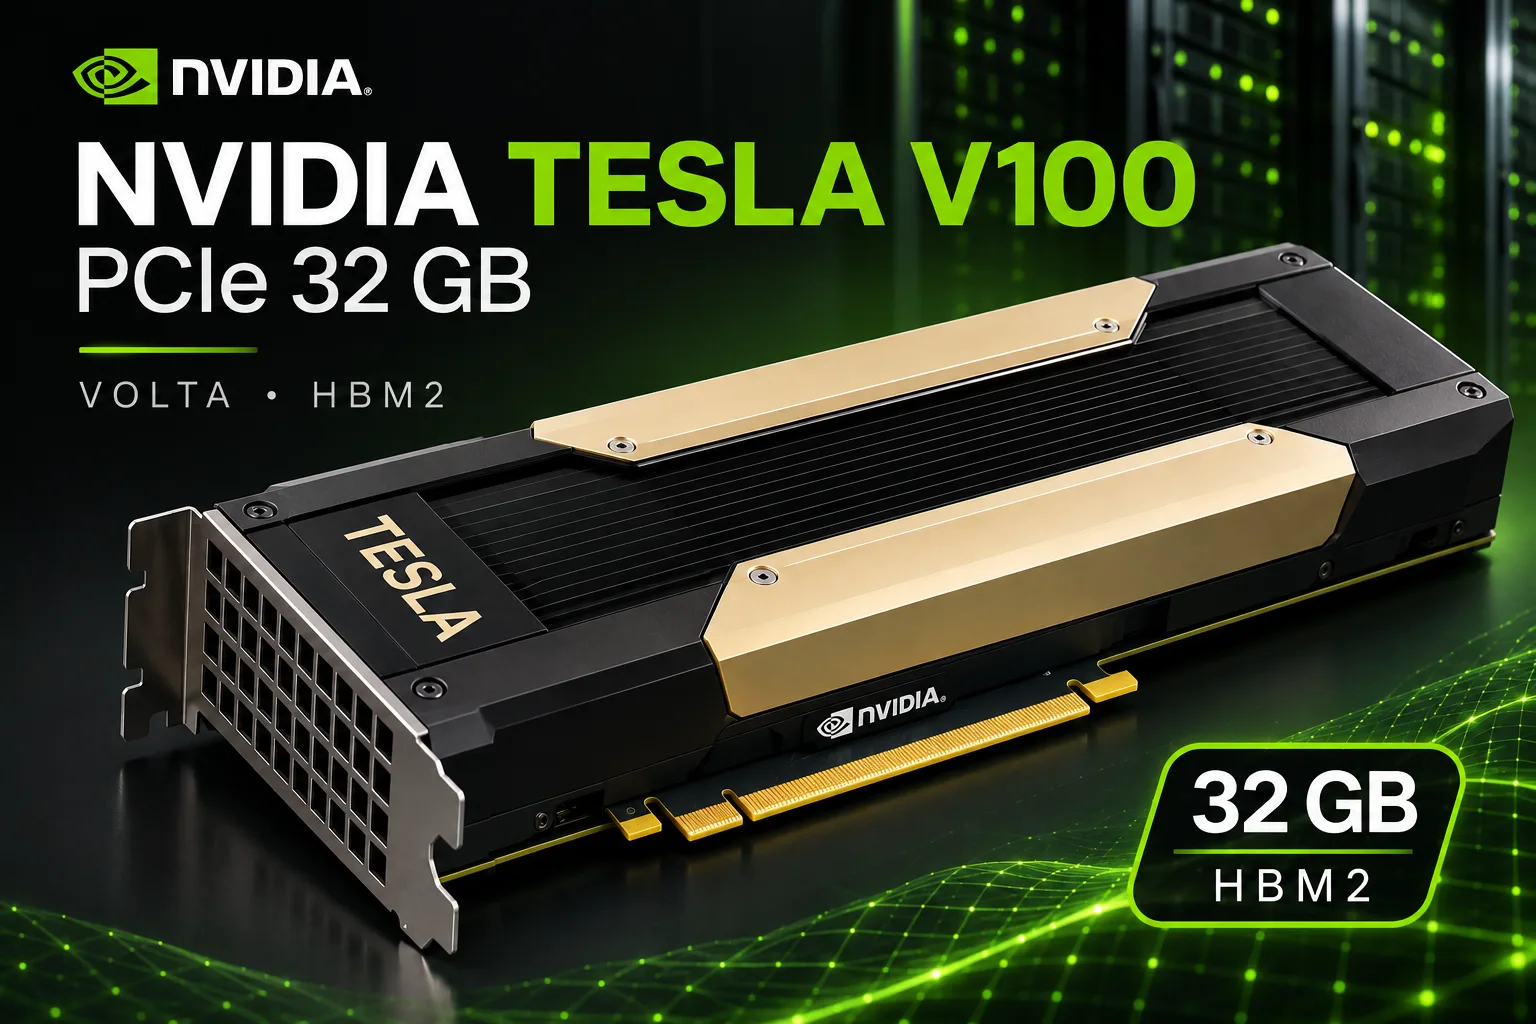
Tesla V100 PCIe 32 GB: memoria para modelos de 27.000 millones de parámetros, pero con sobreprecio por el conector PCIe
Tesla V100 PCIe 32 GB es una versión del acelerador para servidores V100 con el doble de memoria. NVIDIA la lanzó en marzo de 2018 por unos $11 500. Actualmente, las tarjetas retiradas se venden en eBay por unos $700.
Tiene el mismo chip, las mismas frecuencias y el mismo ancho de banda de 900 GB/s que la versión de 16 GB. Pero en 2026 lo que importa es precisamente la capacidad. En 32 GB caben modelos densos de 27-32.000 millones de parámetros con cuantización de 4 bits y contexto largo, y la V100 genera con ellos unos 30 tokens por segundo.
Tiene dos inconvenientes. Volta se ha quedado sin controladores nuevos y sin CUDA 13. Además, la versión PCIe cuesta casi el triple que la de 16 GB y bastante más que el módulo SXM2 de la misma capacidad.
Posición en la gama
Todas las V100 están construidas alrededor del chip GV100: proceso de fabricación TSMC de 12 nm, 5120 núcleos CUDA y 640 núcleos tensoriales de primera generación, además de cuatro pilas de HBM2 conectadas mediante un bus de 4096 bits. Las versiones de 32 GB y sus parientes más cercanas son:
| Modelo | Memoria | Ancho de banda | Boost | TDP | Características |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | la misma tarjeta con la mitad de memoria |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | disipador pasivo, sin NVLink ni salidas de vídeo |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | conector de servidor SXM2, NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | actualización de 2019 |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | salidas de vídeo, controlador profesional |
El rendimiento nominal de la versión PCIe es de 14 TFLOPS en FP32, 7 TFLOPS en FP64 y 112 TFLOPS en los núcleos tensoriales. Estos núcleos solo funcionan con FP16. Volta no tiene núcleos RT, BF16 ni TF32.
En los anuncios, la misma placa de referencia aparece con distintos números de pieza: PNY TCSV100M-32GB-PB, Dell 490-BENZ y 0HR5WD, HPE Q9U36A, Lenovo 4X67A12088 y Cisco UCSC-GPU-V100-32=.
Rendimiento
Modelos de lenguaje
La velocidad de generación de tokens está limitada por el ancho de banda de la memoria. Por eso, con modelos pequeños, la V100 de 32 GB funciona igual que la de 16 GB. Estas son mediciones de los desarrolladores de llama.cpp con una misma versión del código:
| Tarjeta | Memoria | gpt-oss 20B, prompt (pp2048), tokens/s | gpt-oss 20B, generación (tg128), tokens/s | Llama 8B Q4_0, generación, tokens/s |
|---|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1362 | 65 | 52 |
| Instinct MI50/MI60 | 32 GB HBM2 | 1066 | 144 | - |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 2436 | 151 | 128 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5824 | 210 | 155 |
| GeForce RTX 4090 | 24 GB GDDR6X | 13 127 | 264 | 179 |
| GeForce RTX 5090 | 32 GB GDDR7 | 21 011 | 412 | 282 |
Con gpt-oss 20B, la V100 genera un 28 % más despacio que la RTX 3090 y queda al nivel de la tarjeta de AMD. La prueba no aclara si participó una MI50 o una MI60. La V100 procesa el prompt 2,3 veces más rápido que la tarjeta de AMD, pero 2,4 veces más despacio que la 3090.
Esta tarjeta se compra por sus 32 GB para ejecutar modelos densos de 27.000 millones de parámetros. A continuación se muestran informes de propietarios: llama.cpp, una solicitud y sin aceleraciones. Las mediciones con SXM2 también sirven para la versión PCIe: ambas tienen la misma memoria y la generación está limitada precisamente por ella. Las filas directamente comparables son las de Qwen3.6 27B Q4_K_M.
| Configuración | Modelo y cuantización | Generación, tokens/s | Prompt, tokens/s |
|---|---|---|---|
| V100 PCIe 32 GB | Qwen3.8 27B, UD-Q4_K_XL | 33,4 | 826 |
| V100 SXM2 32 GB | Qwen3.6 27B, Q4_K_M | 32,2 | - |
| V100 SXM2 32 GB | Qwen3.6 27B, Q8_0 | 22,8 | - |
| RTX 5090 | Qwen3.6 27B, Q4_K_M | 77 | - |
Una velocidad de 32-33 tokens por segundo en 27B con 4 bits es suficiente para chats y tareas de agentes. La RTX 5090 es 2,4 veces más rápida, pero también cuesta casi 9 veces más.
Las técnicas de software aportan más que elegir entre PCIe y SXM2. Con MTP -predicción de varios tokens por paso-, Qwen3.8 27B pasa de 33 a 57 tokens por segundo. El aumento es mayor con código y menor con prosa. El fork de vLLM es un 10 % más lento que llama.cpp con un único flujo. En cambio, con cuatro solicitudes simultáneas alcanza 110 tokens por segundo en total, frente a 75,7.
A medida que aumenta el contexto, la velocidad cae: de 33,4 tokens por segundo con el contexto vacío a 28 con 32.000 tokens y 15,8 con 131.000. También conviene vigilar la refrigeración. La tarjeta de un propietario bajaba hasta 15,7 tokens por segundo hasta que puso los ventiladores del servidor al máximo.
En una de las pruebas, la V100 resultó más eficiente que la RTX 4070. Con Qwen3.5 4B alcanzó 107 tokens por segundo a 154 W, mientras que la 4070 produjo 91 tokens a 173 W; es decir, un 30 % menos de tokens por julio. La 4070 procesa el prompt más rápido: 5860 tokens por segundo frente a 4445.
Entrenamiento, cálculos y juegos
Los 32 GB permiten ajustar finamente modelos más grandes en FP16, pero, sin BF16 ni FlashAttention 2, hay que rehacer las cadenas modernas de entrenamiento. Según las mediciones de Lambda en versiones SXM2, la A100 entrena entre 1,6 y 3,4 veces más rápido.
En FP64, la V100 sigue siendo potente. Sus 7 TFLOPS son aproximadamente cinco veces más que los de la RTX 4090, y en 32 GB caben mallas grandes para CFD y dinámica molecular.
La tarjeta no sirve para jugar. No tiene salidas de vídeo, DLSS ni trazado de rayos, y su nivel de rendimiento está ligeramente por debajo de la RTX 4060 Ti.
Compatibilidad de software
La rama de controladores R580 es la última compatible con Volta. CUDA 13 no compila para esta arquitectura, así que solo queda CUDA 12.x. Las compilaciones preparadas de llama.cpp y LM Studio van perdiendo progresivamente la compatibilidad con V100. A un propietario, la cuantización de la caché KV pasó silenciosamente al procesador precisamente por la ausencia de Volta en CUDA 13.
La plataforma se mantiene gracias a los entusiastas: forks de vLLM para sm_70, el port de ExLlamaV3 y compilaciones de llama.cpp con MTP. Para experimentar en casa es suficiente. En un sistema de producción dependerá de cuánto tiempo más decidan mantenerlas sus autores.
Precios y dónde comprarla
Las V100 nuevas dejaron de fabricarse hace tiempo; actualmente solo se vende de segunda mano.
| Oferta | Configuración | Precio |
|---|---|---|
| eBay Estados Unidos, precio mínimo (octubre de 2026) | V100 PCIe 32 GB | ~$685-695 |
| eBay Estados Unidos, promedio de los anuncios activos | V100 PCIe 32 GB | ~$920 |
| Amazon / Newegg (octubre de 2026) | V100 PCIe 32 GB | $799 / $839 |
| Algunos vendedores extranjeros | V100 PCIe 32 GB | $400-500 |
| Módulo SXM2 + adaptador | V100 SXM2 32 GB | ~$250-600 |
| IT Creations | V100S PCIe 32 GB | $8937 |
| TechMikeNY, Dell PowerEdge R740 | servidor con una V100 PCIe 32 GB | $12 156 |
El precio mínimo en eBay apenas ha variado desde comienzos de año: unos $707 en febrero y unos $685 ahora. La tarjeta solo aparece por debajo de $500 entre algunos vendedores extranjeros. Estos lotes, al igual que los más baratos de eBay, normalmente no incluyen garantía. Al precio hay que añadir un ventilador con carcasa: sin el flujo de aire de un servidor, el disipador pasivo se sobrecalienta.
Los revendedores y ensambladores de servidores piden un orden de magnitud más. En una configuración de servidor se paga principalmente por los procesadores, la memoria y los discos.
Competidores y alternativas
Tesla V100 SXM2 32 GB con adaptador. El mismo chip y la misma capacidad, con una frecuencia un 10 % mayor; con el adaptador, cuesta $250-600. Sus inconvenientes son el montaje por cuenta propia, el ruidoso ventilador de serie y los 300 W bajo carga. Para un PC doméstico, es la forma más barata de conseguir 32 GB de HBM2.
Dos V100 PCIe de 16 GB. Cuestan unos $470 por los mismos 32 GB. llama.cpp dividirá el modelo por capas y la generación se mantendrá al nivel de una sola tarjeta. Harán falta dos ranuras x16 y una fuente de alimentación con margen para 500 W.
GeForce RTX 3090. Es entre un 20 y un 40 % más rápida en generación y procesa el prompt 2,4 veces más rápido; además, ofrece BF16, FlashAttention y controladores con soporte. Un modelo 27B en 4 bits cabe en sus 24 GB, aunque queda menos margen para el contexto; un modelo 32B en Q5-Q6 ya no cabe. Cuesta unos $1386, el doble que la V100.
GeForce RTX 5090. Tiene los mismos 32 GB y una velocidad mucho mayor. Debido a la escasez de memoria, cuesta desde $6000, frente a los $1999 recomendados. Eso equivale a unos $190 por gigabyte, frente a $22 en la V100.
AMD Instinct MI50 32 GB. Su generación está al nivel de la V100, pero procesa el prompt más de dos veces más despacio. Cuesta $120-210 entre los proveedores de Alibaba y $500-650 en eBay. Las opciones que funcionan de forma estable son principalmente llama.cpp y PyTorch básico.
Conclusión
Según los estándares actuales, la V100 PCIe 32 GB es un acelerador lento con una memoria grande y rápida. Es suficiente para cargar un modelo de 27-32.000 millones de parámetros con contexto largo y trabajar con él a un ritmo cómodo. Las limitaciones aparecen con los prompts largos, el entrenamiento y el software. La tarjeta no es adecuada para sistemas de producción.
Un precio razonable para la versión PCIe sería de hasta $450-500. Por los $700 actuales, pierde frente al módulo SXM2 de 32 GB con adaptador. El sobreprecio de la versión PCIe solo está justificado si la tarjeta se instala en un servidor en rack como un Dell R740 o un HPE DL380: allí no se puede instalar el adaptador y el flujo de aire de serie resuelve el problema de la refrigeración.
Si 24 GB son suficientes y se necesita velocidad con un soporte de software normal, es mejor pagar un poco más por una RTX 3090. Si se busca la máxima memoria por el mínimo dinero, resulta más conveniente una V100 SXM2 32 GB o una MI50.
Comparación de GPU
Comparar Tesla V100 PCIe 32 GB con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Comparaciones de GPU relacionadas


Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/es/gpu/nvidia-tesla-v100-pcie-32-gb" target="_blank">NVIDIA Tesla V100 PCIe 32 GB</a>