NVIDIA Tesla P40
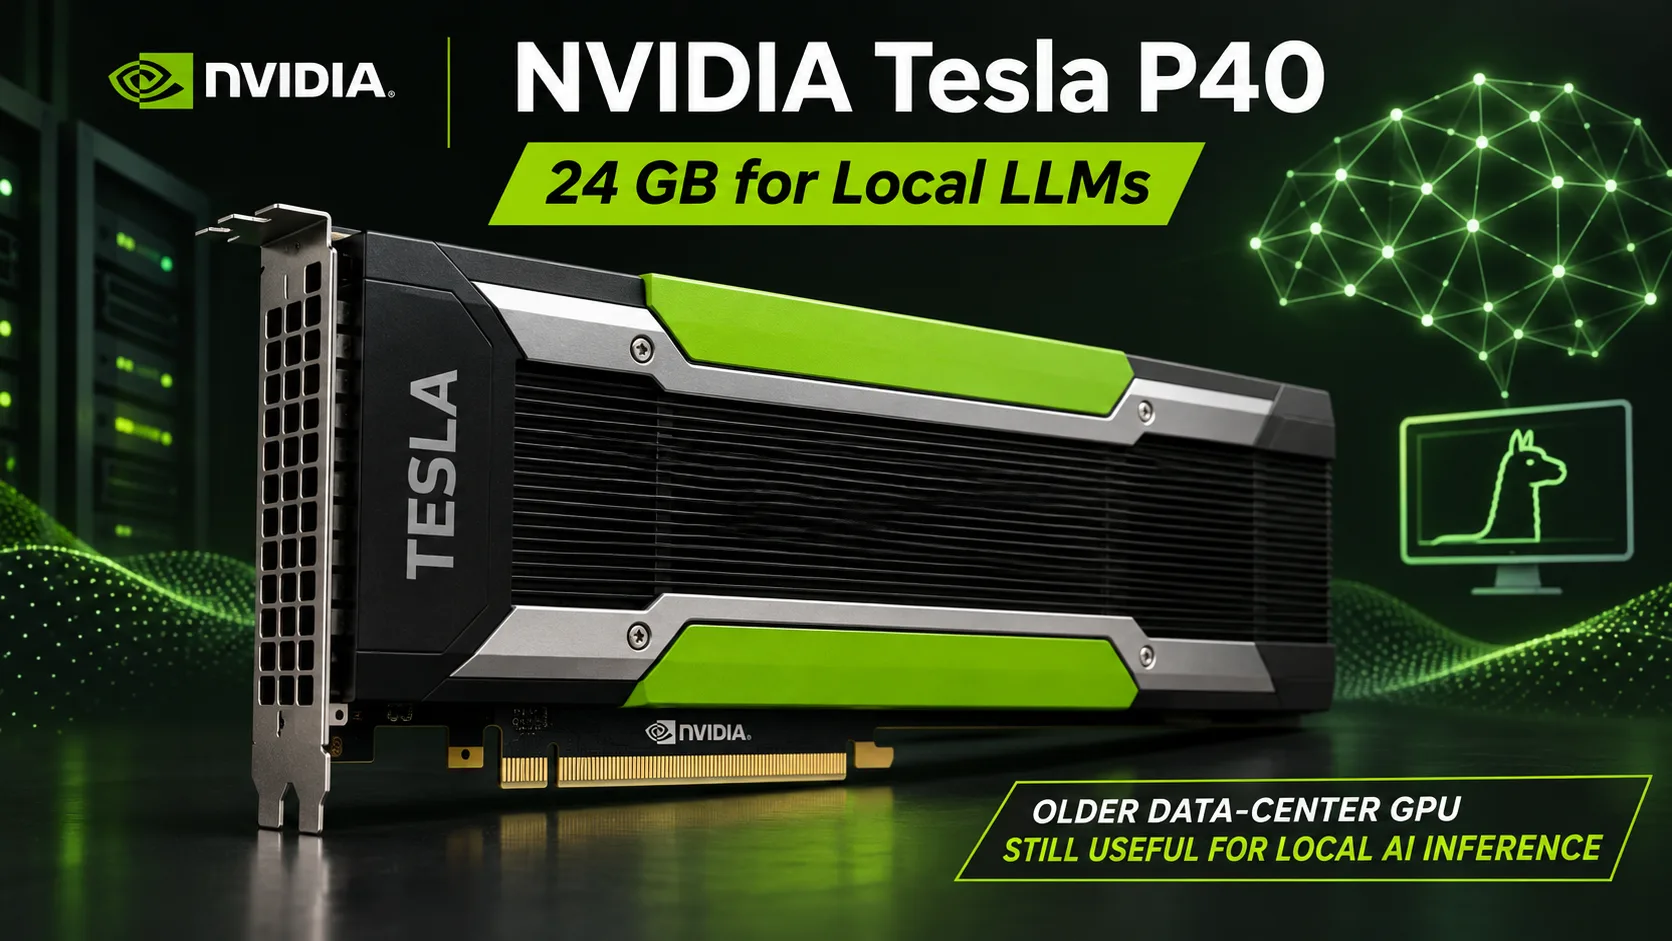
NVIDIA Tesla P40: 2016년 그래픽 카드에서 LLM을 실행하는 이유
NVIDIA Tesla P40은 2016년 신경망용 서버 가속기로 출시됐다. 10년이 지난 2026년, 이 제품이 주목받는 이유는 24 GB의 비디오 메모리다. 대부분의 저가형 게이밍 GPU에는 들어가지 않는 300억~320억 개 파라미터 규모의 일부 언어 모델을 실행하기에 충분한 용량이다.
그러나 Pascal 아키텍처는 성능을 크게 제한한다. Tesla P40에는 Tensor Core가 없고 FP16 연산이 느리며, 패시브 냉각 방식이어서 일반 컴퓨터에 설치하려면 추가 개조가 필요하다. 2026년에 Tesla P40의 24 GB 메모리는 얼마나 유용할까?
Pascal 아키텍처에서의 24 GB 메모리
Tesla P40은 GeForce GTX 1080 Ti와 같은 계열인 GP102 칩을 기반으로 한다. CUDA 코어는 3840개이며 GPU 클럭은 1303~1531 MHz다. 384-bit 메모리 버스와 346 GB/s의 대역폭을 사용하는 GDDR5 메모리를 탑재했다.
GP100 칩과 HBM2 메모리를 사용하는 Tesla P100과 달리, P40은 주로 신경망 추론을 겨냥했다. FP16 성능은 약 0.19 TFLOPS로, FP32의 약 64분의 1에 불과하다.
| 그래픽 카드 | 메모리 | 메모리 대역폭 | FP16 | Tensor Core |
|---|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB GDDR5 | 346 GB/s | ~0.19 TFLOPS | 없음 |
| NVIDIA Tesla P100 PCIe | 16 GB HBM2 | 732 GB/s | 18.7 TFLOPS | 없음 |
| NVIDIA Tesla V100 PCIe | 32 GB HBM2 | 900 GB/s | ~28 TFLOPS | 640개 |
NVIDIA는 P40이 FP32에서 최대 12 TFLOPS, INT8에서 47 TOPS를 제공한다고 발표했다. 하지만 이 수치를 최신 LLM의 속도로 직접 환산할 수는 없다. 결과는 모델의 형식, 사용되는 연산, 소프트웨어 최적화에 따라 달라진다.
llama.cpp 테스트에서의 성능
Tesla P40에서는 텍스트 생성 테스트가 성능을 가장 잘 보여준다. 아래는 Q4_0으로 양자화한 Llama 2 7B 모델을 사용한 llama.cpp 결과다.
| 그래픽 카드 | 메모리 | 프롬프트 처리, tok/s | 생성, tok/s |
|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB | 1007 | 54.7 |
| NVIDIA Tesla P100 | 16 GB | 761 | 58.4 |
| NVIDIA Tesla V100 | 32 GB | 3043 | 129.1 |
| NVIDIA GeForce RTX 3060 | 12 GB | 2138 | 75.6 |
| NVIDIA GeForce RTX 3090 | 24 GB | 5175 | 158.2 |
llama-bench 테스트: 입력 토큰 512개 처리(pp512) 및 토큰 128개 생성(tg128), Flash Attention을 사용하지 않은 CUDA 환경. 결과는 서로 다른 시스템과 llama.cpp 버전에서 얻었으므로 비교는 참고용이다.
텍스트 생성에서 Tesla P40은 메모리 대역폭이 훨씬 낮음에도 P100에 거의 뒤처지지 않는다. RTX 3060은 약 38% 빠르고, RTX 3090은 거의 3배 빠르다.
입력 프롬프트를 처리할 때는 차이가 더 커진다. RTX 3090은 P40을 5배 이상 앞선다. 답변을 생성하기 전에 수천 개의 입력 토큰을 처리해야 하는 긴 문서 작업에서 특히 두드러지는 차이다.
그러나 Llama 2 7B는 8 GB 비디오 메모리에도 들어간다. 따라서 이 테스트는 GPU 속도는 보여주지만, 더 큰 모델을 실행할 수 있다는 P40의 가장 큰 장점은 보여주지 못한다.
24 GB에 들어가는 LLM
좋은 예로 Qwen2.5-32B-Instruct를 들 수 있다. Q4_K_M으로 양자화한 GGUF 형식에서 모델 가중치는 약 19.9 GB를 차지한다. Tesla P40에는 KV 캐시와 연산 버퍼를 위한 공간이 남지만, 사용할 수 있는 컨텍스트 길이는 실행 설정에 따라 달라진다.
RTX 3060 12 GB에는 이 모델 전체가 들어가지 않는다. 더 강한 양자화를 사용하거나 연산의 일부를 시스템 메모리로 옮겨야 한다.
Tesla P40에서 실행할 수 있는 모델은 모델 크기와 형식에 따라 달라진다.
- 7B~8B: Q4, Q8 및 비교적 긴 컨텍스트를 사용하기에 충분한 메모리.
- 14B: 많은 모델이 Q8_0에서도 들어가며, 관리용 데이터에 사용할 메모리도 남는다.
- 30B~32B: KV 캐시와 기타 버퍼의 크기가 적절하다면 Q4로 실행 가능.
수용 가능한 모델 크기와 성능을 혼동해서는 안 된다. 320억 개 파라미터 모델은 Llama 2 7B보다 훨씬 많은 연산을 필요로 한다. 위의 결과만으로는 별도 테스트 없이 해당 모델의 속도를 평가할 수 없다.
양자화된 GGUF 모델을 로컬에서 실행하려면 호환되는 CUDA 백엔드를 지원하는 llama.cpp를 사용할 수 있다. 대용량 문서를 자주 처리하거나 여러 사용자가 동시에 작업할 때는 P40의 제약이 더욱 두드러진다.
일반 컴퓨터에 설치하기
Tesla P40은 강제 공기 냉각을 사용하는 서버를 대상으로 설계됐다. 자체 팬이 없으며 최대 소비 전력은 250 W에 이른다.
설치할 때는 다음 사항을 고려해야 한다.
- 냉각. 방열판을 통과하는 방향성 있는 공기 흐름이 필요하다. 일반적으로 별도의 팬과 덕트를 사용해야 한다.
- 전원. 서버용 CPU/EPS 8핀 커넥터를 사용한다. 일반 PCIe 8핀 케이블을 대신 직접 연결해서는 안 된다.
- 영상 출력. HDMI와 DisplayPort가 없다. 모니터는 다른 그래픽 어댑터에 연결해야 한다.
- 크기. 기판 길이는 약 267 mm이며 두 슬롯을 차지한다.
소프트웨어 지원과 관련된 추가 제약도 있다. Tesla P40의 Compute Capability는 6.1이다. NVIDIA는 CUDA Toolkit 13.0에서 Pascal용 애플리케이션 컴파일 지원을 중단했다.
이 아키텍처용 프로그램을 빌드하려면 CUDA Toolkit 12.9 또는 그보다 이전의 호환 버전이 필요하다. Pascal을 지원하는 NVIDIA 드라이버의 마지막 브랜치는 R580이며, 유지보수는 2028년 6월까지 예정돼 있다.
이는 해당 날짜 이후 P40이 작동을 멈춘다는 의미는 아니다. 다만 최신 연산 라이브러리는 더 현대적인 GPU를 요구할 수 있으므로 프로그램 호환성은 별도로 확인해야 한다.
2026년에 Tesla P40을 사용해야 할까
Tesla P40은 24 GB 메모리 덕분에 실용적인 가치를 유지하고 있다. RTX 3060 12 GB나 Tesla P100 16 GB에 들어가지 않는 양자화 LLM을 실행할 수 있다. 반면 대용량 비디오 메모리가 필요하지 않은 작업에서는 두 카드가 더 빠를 수 있다.
같은 24 GB를 탑재한 RTX 3090은 텍스트 생성과 프롬프트 처리 속도에서 P40을 크게 앞선다. Tesla V100도 훨씬 빠르지만, 16 GB 버전은 대형 모델 선택을 제한한다. 32 GB 버전은 이 문제를 해결한다.
P40을 선택할 때는 카드 자체의 가격만 고려해서는 안 된다. 추가 냉각 장치, 적합한 전원 공급, 최대 250 W의 소비 전력, 호환 가능한 소프트웨어 스택을 사용해야 한다는 점이 운영 비용을 높인다.
로컬 LLM에 꼭 24 GB의 메모리가 필요하고 높은 속도가 필수는 아니며, 완성된 시스템의 가격이 대안보다 확실히 낮다면 Tesla P40을 고려할 만하다. 장기간 사용할 새 워크스테이션을 구축한다면 더 최신 GPU가 바람직하다.
GPU 비교
Tesla P40을 다른 GPUs와 비교
기초적인
메모리 사양
디스플레이 및 미디어
이론적 성능
여러 가지 잡다한
벤치마크
다른 GPU와 비교
관련 GPU 비교


소셜 미디어에서 공유하기
또는 링크로 소개하기
<a href="https://cputronic.com/ko/gpu/nvidia-tesla-p40" target="_blank">NVIDIA Tesla P40</a>