NVIDIA Tesla V100 PCIe 16 GB

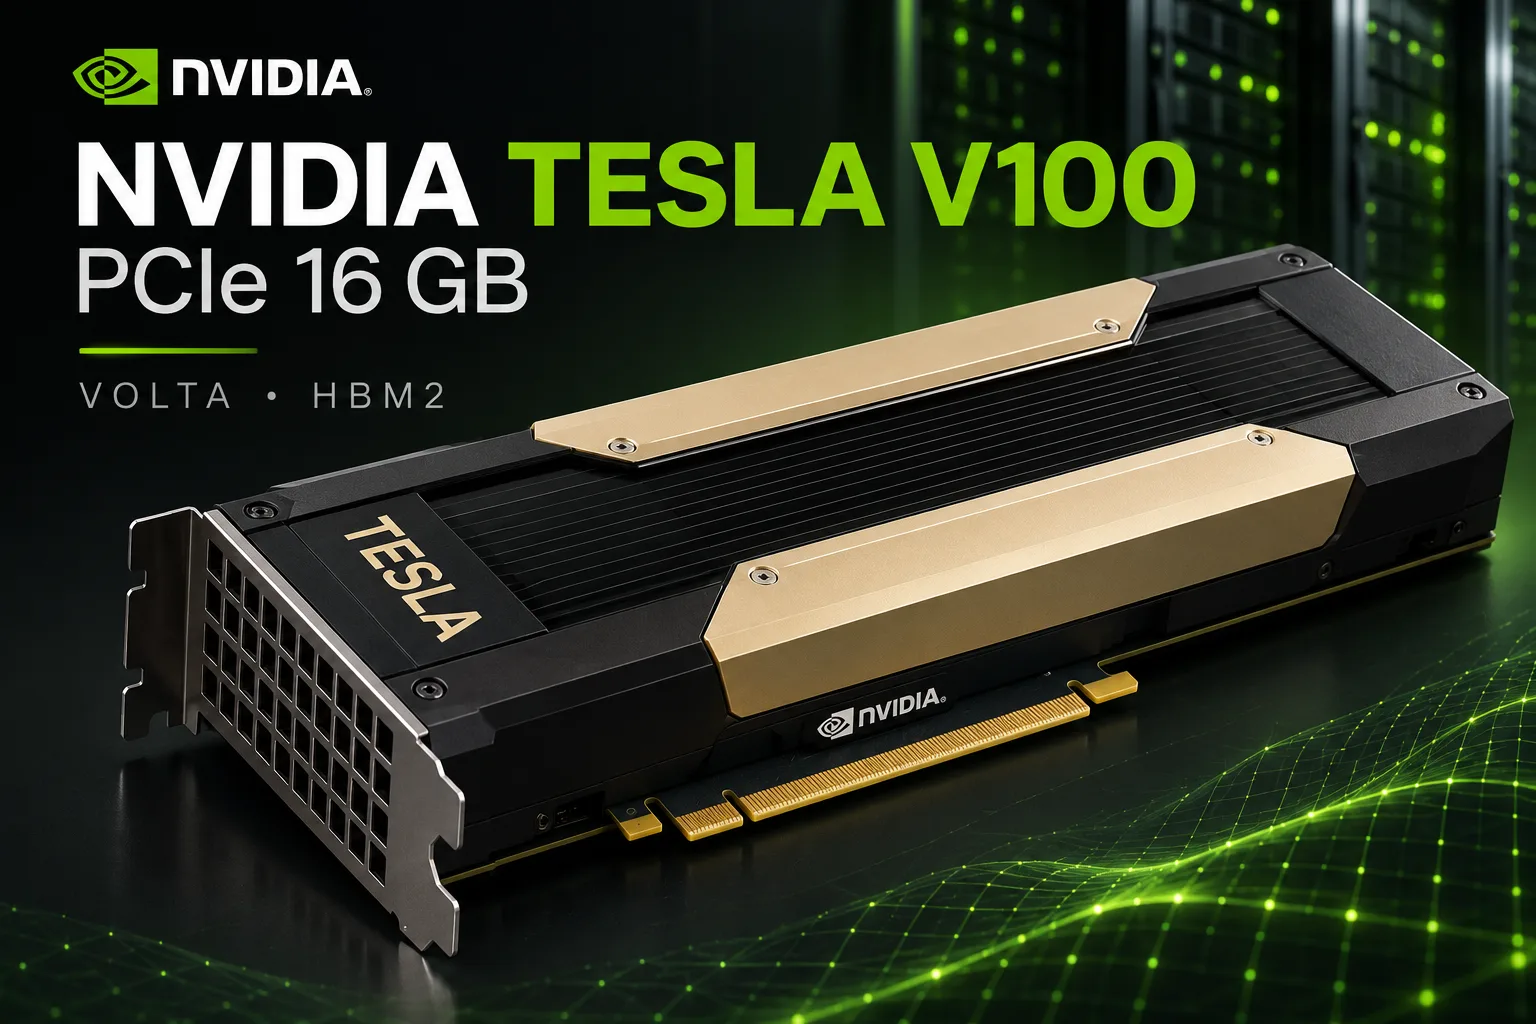
Tesla V100 PCIe 16 Go : 900 Go/s de HBM2 pour quelques centaines de dollars, mais avec une prise en charge CUDA limitée
La Tesla V100 PCIe 16 Go est un accélérateur serveur de 2017 qui reste intéressant pour les réseaux de neurones locaux et les calculs scientifiques. Son principal atout est sa mémoire HBM2, avec une bande passante de 900 Go/s, presque équivalente à celle de la GeForce RTX 3090. Sur le marché de l’occasion, la carte coûte quelques centaines de dollars, même si les offres les moins chères concernent souvent des modules SXM2 plutôt que de véritables cartes PCIe.
Ce prix modéré implique quelques concessions. La V100 ne dispose ni de sorties vidéo ni de cœurs de ray tracing matériels, ses 16 Go de mémoire sont insuffisants pour les grands modèles de langage et la prise en charge des nouvelles versions de CUDA a pris fin. NVIDIA a maintenu Volta sur la branche de pilotes R580, dont le support se poursuivra jusqu’à la mi-2028. Pour exécuter les LLM modernes, il faut de plus en plus sélectionner soi-même des versions compatibles des logiciels.
Positionnement dans la gamme
La Tesla V100 repose sur une puce GV100 de 815 mm², fabriquée par TSMC selon un procédé en 12 nm FFN. Sur les 84 multiprocesseurs de flux, 80 sont actifs, soit 5120 cœurs CUDA et 640 cœurs Tensor de première génération. Quatre piles de HBM2 sont connectées via un bus de 4096 bits.
À partir du GV100, NVIDIA a lancé plusieurs accélérateurs avec des capacités mémoire, des fréquences et des interfaces différentes.
| Modèle | Mémoire | Bande passante | Boost | TDP | Particularités |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 Go | 16 Go de HBM2 | 900 Go/s | 1380 MHz | 250 W | PCIe 3.0 x16, sans NVLink |
| Tesla V100 PCIe 32 Go | 32 Go de HBM2 | 900 Go/s | 1380 MHz | 250 W | Capacité mémoire doublée |
| Tesla V100 SXM2 16/32 Go | 16/32 Go de HBM2 | 900 Go/s | 1530 MHz | 300 W | SXM2, prise en charge de NVLink |
| Tesla V100S PCIe 32 Go | 32 Go de HBM2 | 1134 Go/s | 1601 MHz | 250 W | HBM2 plus rapide |
| Titan V | 12 Go de HBM2 | 653 Go/s | 1455 MHz | 250 W | Sorties vidéo, bus de 3072 bits |
| Quadro GV100 | 32 Go de HBM2 | 870 Go/s | 1627 MHz | 250 W | Graphismes professionnels |
La version PCIe de 16 Go atteint 14 TFLOPS en FP32, 7 TFLOPS en FP64 et 112 TFLOPS dans les calculs tensoriels FP16. Ces chiffres sont légèrement inférieurs à ceux de la version SXM2, dont la fréquence et la limite de puissance sont plus élevées.
Volta est la première architecture NVIDIA à avoir reçu des cœurs Tensor. Ceux-ci ne prennent toutefois en charge que le FP16 et ne fonctionnent pas avec le BF16, le TF32 ni le FP8. L’absence de ces formats limite l’efficacité des bibliothèques et des modèles modernes. Le GV100 ne dispose pas non plus de cœurs RT matériels.
Performances
Modèles de langage locaux
Lors de la génération de tokens, les performances sont souvent limitées par la vitesse de lecture des poids depuis la mémoire vidéo. C’est pourquoi la V100, avec ses 900 Go/s, reste compétitive face à des GPU beaucoup plus récents.
Pour comparaison, on peut utiliser le tableau de résultats publié par les développeurs de llama.cpp pour Llama 2 7B en quantification Q4_0. Il mesure la vitesse de traitement d’un prompt de 512 tokens et la génération de 128 tokens sans FlashAttention.
| Carte graphique | Mémoire | Traitement du prompt, tokens/s | Génération, tokens/s |
|---|---|---|---|
| Tesla P40 | 24 Go de GDDR5 | 1007 | 55 |
| Tesla V100 PCIe 32 Go | 32 Go de HBM2 | 3043 | 129 |
| GeForce RTX 3090 | 24 Go de GDDR6X | 5175 | 158 |
| GeForce RTX 4090 | 24 Go de GDDR6X | 11 993 | 186 |
| GeForce RTX 5090 | 32 Go de GDDR7 | 14 073 | 290 |
Les résultats proviennent de tests réalisés par différents utilisateurs. Le modèle et les principaux paramètres sont identiques, mais les versions de llama.cpp, les pilotes et les configurations système peuvent varier.
Le tableau utilise une V100 PCIe 32 Go. La version de 16 Go possède les mêmes fréquences et la même bande passante HBM2, tandis que le modèle lui-même occupe moins de 4 Go. On peut donc s’attendre à des performances proches, même si aucune mesure directe de la carte de 16 Go n’est disponible ici.
En génération, la V100 est environ 18 % plus lente que la RTX 3090, et l’écart atteint 41 % lors du traitement du prompt. Pour une courte conversation, la différence n’est pas toujours significative, mais elle devient plus visible avec les gros documents et les longs historiques de discussion.
La RTX 4090 traite le prompt presque quatre fois plus rapidement que la V100, alors que son avantage en génération n’est que de 44 %. Cela montre que la seule bande passante mémoire ne détermine pas les performances dans toutes les tâches.
La principale limite de la V100 PCIe 16 Go est sa capacité mémoire. La carte convient aux modèles de 7 à 14 milliards de paramètres en quantification 4 bits. Les modèles de 27 à 32 milliards de paramètres nécessitent généralement de décharger une partie des données dans la mémoire vive ou d’utiliser une compression plus importante. Dans les deux cas, il faut accepter des compromis sur la vitesse, la qualité ou la longueur du contexte.
Entraînement et calculs scientifiques
La V100 a été conçue avant tout pour l’entraînement des réseaux de neurones et le calcul haute performance. Ses cœurs Tensor FP16 restent utiles, mais les accélérateurs plus récents bénéficient de formats de calcul plus efficaces, de caches plus grands et de bibliothèques optimisées.
Les limites sont particulièrement visibles lors de l’entraînement de modèles utilisant le BF16. La V100 ne prend pas en charge ce format matériellement, si bien qu’il n’est pas possible de transposer toutes les configurations modernes de PyTorch et d’autres frameworks vers Volta sans modifications.
En revanche, la carte conserve un avantage important sur les GeForce destinées au jeu dans les calculs en double précision. Ses performances atteignent 7 TFLOPS en FP64, soit environ 5,4 fois plus que celles de la RTX 4090.
Pour la dynamique moléculaire, la modélisation numérique et d’autres tâches de calcul haute performance, la V100 reste intéressante si les logiciels utilisés prennent en charge Volta. Toutefois, un débit FP64 élevé sur le papier ne garantit pas à lui seul le même avantage dans un programme donné.
Peut-on jouer sur une Tesla V100 ?
La V100 PCIe ne possède pas de sorties vidéo. Pour afficher une image, il faut une autre carte graphique ou le circuit graphique intégré au processeur. Sous Windows, il faut également trouver un pilote compatible et configurer le lancement des jeux sur l’accélérateur de calcul.
Des passionnés ont testé les capacités de jeu de la V100 SXM2 16 Go au moyen d’un adaptateur PCIe. Dans un système équipé d’un Ryzen 7 5700GE, la carte a obtenu les résultats suivants avec des réglages élevés, sans mise à l’échelle ni génération d’images.
| Jeu | 2560×1080, FPS moyen | 3440×1440, FPS moyen |
|---|---|---|
| Cyberpunk 2077 | ~78 | ~56 |
| Hogwarts Legacy | ~55-60 | ~40 |
| Atomic Heart | ~115 | ~75-80 |
| Red Dead Redemption 2 | ~80 | ~65 |
Dans Cyberpunk 2077, la consommation de l’accélérateur atteignait environ 181 W. Ces résultats montrent que Volta est encore capable de faire fonctionner des jeux modernes, même si l’absence de DLSS et de ray tracing matériel limite fortement ses possibilités.
Il est important de noter qu’il s’agit de tests réalisés avec une SXM2, et non avec une version PCIe. La fréquence Boost de la SXM2 atteint 1530 MHz, contre 1380 MHz pour la PCIe, et sa limite de puissance est supérieure de 50 W. La version PCIe peut donc être plus lente. Il est impossible de déterminer l’écart de FPS sans mesures distinctes.
Acheter une V100 spécialement pour jouer n’est pas rentable. Une GeForce classique est plus simple à installer, prend en charge les technologies graphiques modernes et ne nécessite pas de carte supplémentaire pour afficher une image.
Installation dans un ordinateur classique
Contrairement à la SXM2, la Tesla V100 PCIe se connecte directement à un slot PCIe x16 standard. Son installation dans un PC domestique nécessite toutefois une préparation.
Alimentation. La V100 PCIe de référence dispose d’un connecteur CPU EPS12V à 8 broches. Il diffère du connecteur PCIe classique à 8 broches. NVIDIA autorise l’utilisation d’un câble EPS12V adapté ou d’un adaptateur spécial équipé de connecteurs PCIe.
Avant la première mise sous tension, il faut vérifier le brochage et la charge admissible des câbles. Il ne faut pas brancher un câble inadapté au seul motif que son connecteur lui ressemble.
Refroidissement. La carte est équipée d’un radiateur passif conçu pour fonctionner avec un flux d’air important à l’intérieur d’un serveur. Dans un boîtier classique, un ventilateur séparé assurant un flux d’air dirigé sera nécessaire.
Sans refroidissement suffisant, l’accélérateur peut réduire ses fréquences ou surchauffer. Il faut vérifier non seulement la température du GPU, mais aussi la stabilité du fonctionnement sous une charge prolongée.
Consommation. La limite nominale est de 250 W. Il est possible de réduire la puissance autorisée via nvidia-smi, par exemple à 180 W. Cela diminuera la température et les besoins en refroidissement, mais l’impact sur les performances dépendra de la tâche.
Prise en charge logicielle : la principale limite
NVIDIA a confirmé que R580 serait la dernière branche de pilotes à prendre en charge Maxwell, Pascal et Volta. Pour les accélérateurs serveur, il s’agit d’une branche bénéficiant d’un support à long terme, dont la maintenance prendra fin en juin 2028.
CUDA 13 ne permet plus de compiler des applications pour l’architecture Volta avec les capacités de calcul sm_70. La dernière branche compatible de CUDA Toolkit est la 12.x, y compris la version 12.9.
La V100 n’a toutefois pas cessé de fonctionner avec la sortie de CUDA 13. Les programmes compilés avec la prise en charge de Volta sur des versions antérieures de CUDA continuent de se lancer avec des pilotes compatibles.
Le problème concerne les nouvelles versions des programmes et des bibliothèques :
- llama.cpp. Le code source permet de compiler des versions compatibles avec sm_70, mais les nouvelles optimisations peuvent ne pas prendre en charge Volta.
- PyTorch. Pour la V100, il faut choisir des builds prenant en charge CUDA 12.x et les architectures de calcul correspondantes.
- LM Studio et Ollama. La compatibilité dépend de la version de l’application et du CUDA runtime fourni. Certaines fonctions peuvent nécessiter des builds plus anciens.
- FlashAttention 2. L’implémentation CUDA standard est conçue pour des architectures plus récentes ; sur la V100, il faut donc utiliser d’autres mécanismes de traitement de l’attention.
Pour des expérimentations à domicile, cela reste acceptable : il est possible de conserver un environnement compatible et de le mettre à jour au cas par cas. Pour un serveur de production, les restrictions sont plus sérieuses, car les nouvelles versions des frameworks cessent progressivement de prendre en charge Volta.
Prix sur le marché de l’occasion
Le prix de la V100 varie fortement selon sa version. Les modules SXM2 bon marché apparaissent souvent dans les résultats de recherche généraux pour la Tesla V100, alors qu’il est impossible de les installer dans un PC sans adaptateur.
D’après le récapitulatif des offres eBay au 28 octobre 2026, la situation est la suivante :
| Carte graphique | Fourchette basse des offres | Médiane des annonces |
|---|---|---|
| Tesla V100 PCIe 16 Go, version passive | $329 | $422 |
| Tesla V100 SXM2 16 Go | $191 | $300 |
| Tesla V100 SXM2 32 Go | $842 | $990 |
| Tesla V100 PCIe 32 Go, version passive | $860 | $960 |
| GeForce RTX 3090 24 Go | $1651 | $1970 |
Ces prix concernent des annonces actives, et non des ventes conclues. Certaines Tesla V100 PCIe 16 Go ont été vendues environ $240-275, mais ces offres ne peuvent pas être considérées comme systématiquement disponibles.
Pour une version PCIe de 16 Go, il est raisonnable de prévoir $300-350 pour une carte fonctionnelle dont le bon fonctionnement peut être vérifié. À environ $400, l’achat devient moins intéressant, surtout si un système de refroidissement et un câble d’alimentation sont également nécessaires.
Le prix d’une configuration domestique complète peut être nettement supérieur à celui de l’accélérateur lui-même. Il faut donc comparer la V100 aux solutions alternatives en tenant compte de tous les composants.
Concurrentes et alternatives
Tesla V100 SXM2 16 Go. Le module lui-même est moins cher que la version PCIe, mais il nécessite un adaptateur, une alimentation et un refroidissement séparé. Le coût total peut être comparable à celui d’une carte PCIe complète. Pour un seul GPU, l’avantage de la SXM2 ne justifie généralement pas la complexité du montage. La situation est différente pour les cartes à plusieurs modules avec NVLink.
Tesla V100 PCIe 32 Go. Elle utilise la même architecture de calcul et offre la même bande passante mémoire, mais avec deux fois plus de HBM2. Elle convient nettement mieux aux modèles de langage de 27 à 32 milliards de paramètres. Toutefois, à $800-1000, l’avantage économique d’une architecture ancienne est déjà moins évident.
GeForce RTX 3090 24 Go. Elle est plus rapide pour le traitement des prompts, prend en charge le BF16, les optimisations CUDA modernes et le ray tracing matériel. Ses 24 Go lui permettent de travailler avec des modèles plus volumineux que la V100 16 Go. On trouve sur le marché de l’occasion des annonces à partir d’environ $1200, même si la majorité des offres sont plus chères. Il s’agit d’une carte plus polyvalente, mais le surcoût est important.
GeForce RTX 5060 Ti 16 Go. Elle offre une architecture plus récente, la prise en charge des bibliothèques actuelles, des sorties vidéo, le DLSS 4 et une garantie constructeur. Sa bande passante mémoire est inférieure - 448 Go/s contre 900 Go/s pour la V100. Il est toutefois impossible de déduire directement la vitesse des LLM de cette différence : les cœurs de calcul modernes et les optimisations logicielles peuvent compenser une bande passante inférieure. Pour les jeux et l’usage quotidien, la RTX 5060 Ti est préférable.
AMD Instinct MI50 32 Go. Il s’agit d’une alternative offrant deux fois plus de HBM2, une bande passante d’environ 1 To/s et de hautes performances en FP64. Le prix de certaines annonces commence à environ $650. Sa principale limite est la prise en charge vieillissante de ROCm et la difficulté à utiliser les logiciels de calcul modernes. Pour les programmes conçus pour CUDA, la V100 est généralement plus simple.
Tesla P40 24 Go. Cette carte plus ancienne utilise de la GDDR5 et dispose de 24 Go de mémoire. Dans le test de llama.cpp, elle génère environ 55 tokens/s, contre 129 pour la V100. Ses 8 Go supplémentaires lui permettent toutefois d’exécuter des modèles qui ne tiennent pas dans les 16 Go de la V100. La P40 reste donc une alternative lorsque la capacité mémoire compte davantage que la vitesse.
Faut-il acheter une Tesla V100 PCIe 16 Go ?
La Tesla V100 PCIe 16 Go reste intéressante pour les réseaux de neurones locaux, les calculs scientifiques et les expérimentations avec CUDA. Pour quelques centaines de dollars, l’acheteur obtient une bande passante mémoire de 900 Go/s, 640 cœurs Tensor et 7 TFLOPS en FP64.
Cependant, ses 16 Go limitent le choix des modèles de langage, tandis que la prise en charge logicielle de Volta diminue progressivement. La carte nécessite un refroidissement dirigé, une alimentation adaptée et une sélection attentive des versions de pilotes et de bibliothèques.
À un prix inférieur ou égal à $300-350, la V100 PCIe 16 Go peut être considérée comme un bon achat pour une station de calcul domestique. Si la carte coûte $400 ou plus, il faut la comparer à la SXM2 16 Go, à la P40 24 Go et à des accélérateurs plus modernes, en tenant compte des frais d’installation.
Pour les modèles allant jusqu’à 14 milliards de paramètres, les capacités de la V100 sont généralement suffisantes. Si l’objectif est d’exécuter localement des modèles de 27 à 32 milliards de paramètres sans déchargement dans la mémoire vive, mieux vaut s’intéresser directement à une carte équipée de 24 à 32 Go de mémoire.
La V100 doit être achetée pour des tâches de calcul précises, et non comme carte graphique polyvalente. Ses performances restent suffisantes pour de nombreuses expérimentations, mais il ne faut plus compter sur une prise en charge complète des nouveaux logiciels au cours des prochaines années.
Comparaison de GPU
Comparer Tesla V100 PCIe 16 GB avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Comparaisons de GPU associées


Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/fr/gpu/nvidia-tesla-v100-pcie-16-gb" target="_blank">NVIDIA Tesla V100 PCIe 16 GB</a>