NVIDIA CMP 50HX

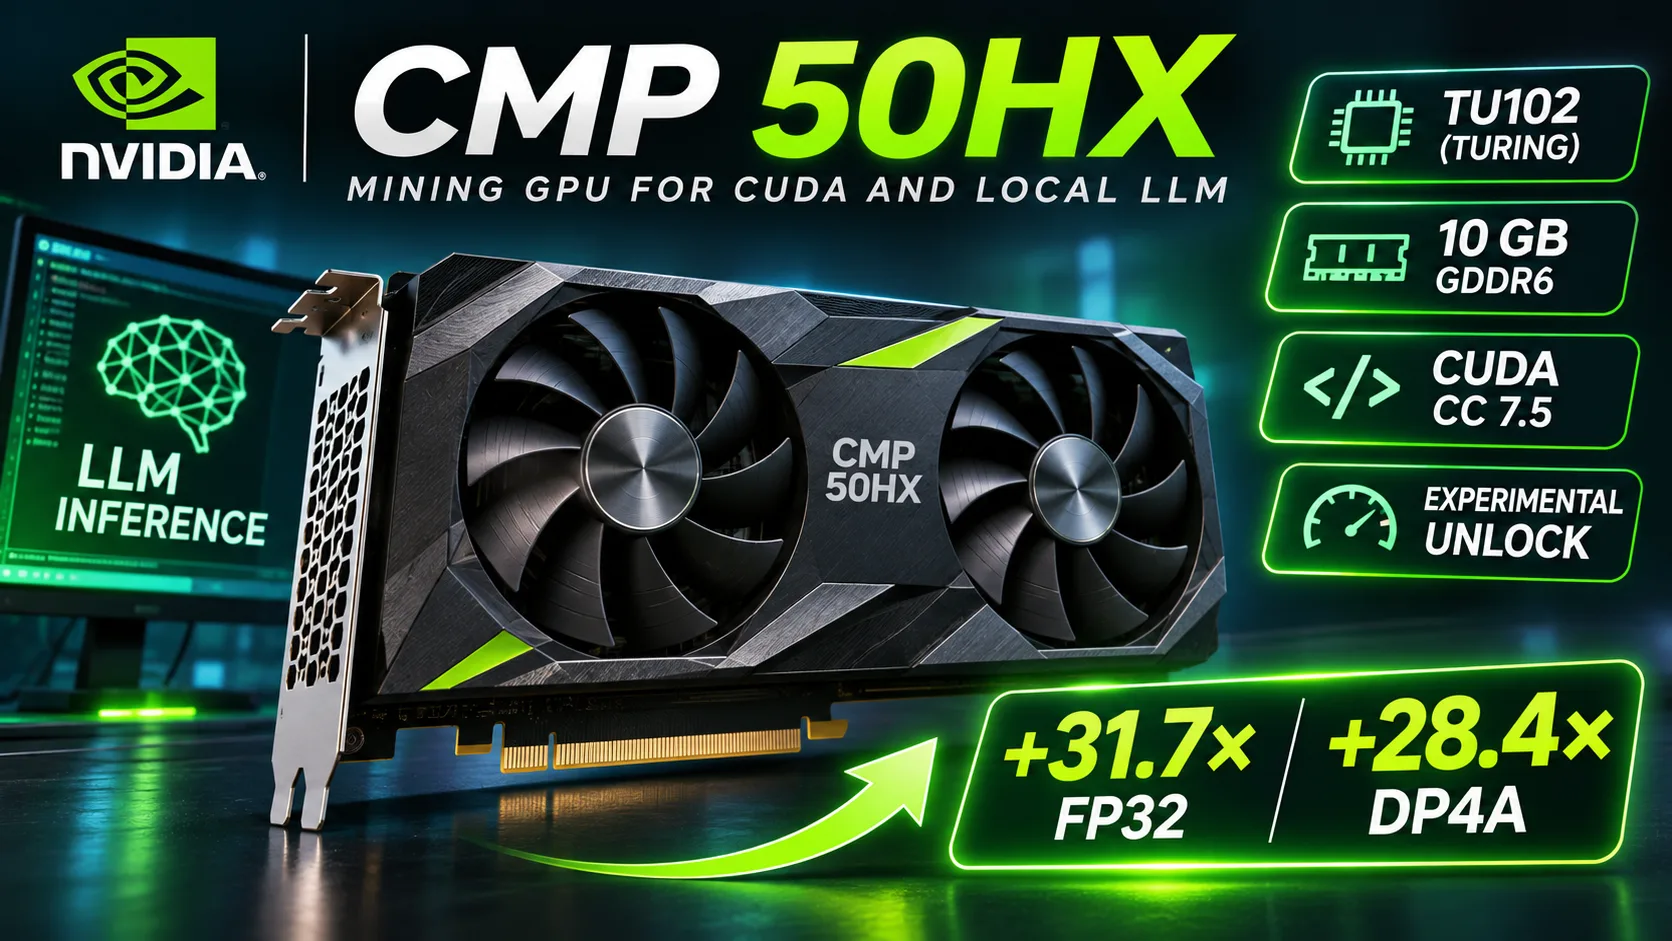
NVIDIA CMP 50HX: CUDA와 로컬 LLM을 위한 10 GB 메모리
NVIDIA CMP 50HX는 2021년에 출시된 채굴용 특수 그래픽카드다. Turing 아키텍처의 TU102 GPU를 사용하며, GeForce RTX 2080 Ti에 탑재된 GPU와 같은 계열이다. 3584개의 CUDA 코어와 10 GB GDDR6 메모리를 탑재했지만, 디스플레이 출력이 없고 연산 성능에 제한이 있다.
Ethereum이 Proof of Stake로 전환된 이후 CMP 50HX는 CUDA와 로컬 신경망을 실험하는 용도로 사용되기 시작했다. 일부 LLM에서는 약 30 tokens/s를 제공하지만, 속도는 연산 유형과 소프트웨어 구성에 따라 달라진다. 2026년에는 일부 제한을 해제하는 실험적인 방법이 등장했다.
아키텍처 및 사양
CMP 50HX는 56개의 스트리밍 멀티프로세서를 갖춘 12 nm TU102 GPU를 기반으로 한다. RTX 2080 Ti와 비교하면 활성화된 연산 블록이 적고 메모리 버스도 더 좁다.
| 사양 | CMP 50HX | RTX 2080 Ti |
|---|---|---|
| CUDA 코어 | 3584 | 4352 |
| 스트리밍 멀티프로세서 | 56 | 68 |
| GDDR6 메모리 | 10 GB | 11 GB |
| 메모리 버스 | 320-bit | 352-bit |
| 메모리 대역폭 | 560 GB/s | 616 GB/s |
| Boost 클록 | 1545 MHz | 1545 MHz |
| PCIe | 1.0 x4 | 3.0 x16 |
| 소비전력 | 225 W | 250 W |
| 디스플레이 출력 | 없음 | 있음 |
MSI CMP 50HX MINER 및 표준 RTX 2080 Ti의 사양.
CMP 50HX는 1350~1545 MHz의 클록으로 작동한다. 14 Gb/s 속도의 GDDR6 메모리는 560 GB/s의 대역폭을 제공한다. Boost 클록에서의 이론적 FP32 성능은 약 11.07 TFLOPS다.
그러나 기본 구성에서는 사용 가능한 연산 성능이 상당히 낮다.
CMP 50HX의 특징:
- CUDA Compute Capability 7.5 지원
- 연산 및 모델 저장을 위한 10 GB GDDR6
- HDMI 및 DisplayPort 부재
- 제한적인 PCIe 1.0 x4 인터페이스
- 8-pin 보조 전원 커넥터 2개
- 드라이버에 따라 달라지는 기능 지원
MSI 버전의 소비전력은 225 W인 반면, NVIDIA의 레퍼런스 사양은 250 W를 규정한다. 장시간 사용하려면 케이스 내부에 충분한 공기 흐름이 필요하다.
FP32, FP16 및 INT8 성능
CMP 50HX의 가장 큰 특징은 일부 연산에 적용된 소프트웨어 제한이다. 기본 구성에서는 특히 FP32와 DP4A 속도가 크게 낮아지는 반면, FP16은 훨씬 빠르게 작동한다.
2026년 9월, 실험적인 잠금 해제 방법을 개발한 개발자들은 일반 드라이버를 사용한 카드와 동일한 드라이버에 수정 사항을 적용한 카드의 성능을 비교했다.
| 연산 | 잠금 해제 전 | 잠금 해제 후 | 향상 폭 |
|---|---|---|---|
| FP32, TFLOPS | 0.427 | 13.512 | 31.7× |
| FP16 half2, TFLOPS | 26.923 | 26.698 | ≈1× |
| DP4A / INT8, TIOPS | 1.689 | 47.984 | 28.4× |
동일한 소프트웨어 기반에서 수행한 단일 비교 실험 결과. 잠금 해제 후 측정값은 공장 출하 사양이 아니다.
FP32 성능은 거의 32배, DP4A 성능은 28배 이상 향상됐다. 반면 일반 FP16 연산 속도는 사실상 변하지 않았다.
이는 제한이 GPU 전체가 아니라 특정 연산 블록과 명령어에 적용된다는 것을 보여준다.
잠금 해제 후 FP32 성능은 13.51 TFLOPS에 도달해, 공장 출하 Boost 클록에서의 이론적 성능인 11.07 TFLOPS를 넘어섰다. 그 이유는 실험 중 더 높은 작동 클록을 사용했기 때문이다. 클록을 고려하지 않고 이 결과를 비교하는 것은 올바르지 않다.
별도의 테스트에서는 잠금 해제 후 FP16 Tensor WMMA 성능이 106.8 TFLOPS에 도달했다. 이 결과는 텐서 연산에 해당하므로 표의 일반 FP16 결과와 직접 비교할 수 없다.
2026년의 실험적인 잠금 해제
개발자들은 UEFI 수정과 소프트웨어 구성 변경을 통해 CMP 50HX의 연산 성능을 복구하는 데 성공했다.
검증된 버전에서는 NVIDIA 610.43.03 드라이버를 사용한다. 잠금 해제에는 UEFI 로드와 Above 4G Decoding 활성화가 필요하다. UEFI 애플리케이션에 올바르게 서명하고 키를 등록하면 Secure Boot를 유지할 수 있다.
추가 수정 사항을 적용하면 PCIe Gen2와 실험적인 ReBAR 지원도 활성화할 수 있다. 다만 이러한 기능을 사용하려면 드라이버를 별도로 수정해야 할 수 있다.
결과는 특정 테스트 구성에서 확인됐다. 다른 메인보드와 시스템에서의 호환성은 별도로 확인해야 한다.
로컬 LLM 성능
10 GB의 비디오 메모리 덕분에 CMP 50HX에는 70억~90억 개의 파라미터를 갖춘 다양한 양자화 언어 모델을 배치할 수 있다.
수정된 드라이버를 사용해 Ollama에서 테스트했을 때 다음과 같은 생성 속도가 측정됐다.
| 모델 | CMP 50HX, tokens/s |
|---|---|
| Qwen3 8B Q4_K_M | 약 28 |
| Llama 3.1 8B Instruct Q6_K | 32 |
| Dolphin3 8B | 28 |
| Gemma 2 9B | 33 |
| Gemma 3 4B Q8_0 | 57 |
2026년 연산 잠금 해제 전의 생성 속도.
이 수치는 FP32 성능이 극도로 낮은 상황에서도 CMP 50HX가 추론에 사용할 수 있었던 이유를 보여준다.
그러나 DP4A 제한 역시 중요하다. 양자화 모델을 처리할 때 CUDA는 DP4A를 포함한 정수 연산을 사용할 수 있다. 이러한 연산의 속도가 낮아지면 토큰 생성과 입력 컨텍스트 처리 모두에 제한이 생길 수 있다.
특히 연산 부하가 더 높은 긴 프롬프트 처리(prefill)가 큰 영향을 받을 수 있다. 하지만 현재로서는 잠금 해제 전후의 prefill을 비교한 검증된 측정 결과가 충분하지 않아 정량적인 결론을 내리기 어렵다.
CMP 50HX의 메모리 대역폭은 560 GB/s로, RTX 3060 12 GB의 360 GB/s보다 높다. 그러나 높은 메모리 대역폭만으로 더 빠른 생성이 보장되지는 않는다. 연산 제한, CUDA 코어의 특성, 양자화 방식도 결과에 영향을 준다.
DP4A 잠금 해제는 LLM 가속의 가능성을 높이지만, 합성 테스트에서의 28배 향상을 토큰 생성 속도에 그대로 적용할 수는 없다.
적절한 양자화와 짧은 컨텍스트를 사용하면 120억~140억 개의 파라미터를 갖춘 일부 모델도 10 GB VRAM에 넣을 수 있다. 이는 가중치 크기, KV 캐시, 애플리케이션 오버헤드에 따라 달라진다. 일부 레이어를 CPU로 오프로드하면 속도가 크게 떨어진다.
PCIe 제한
MSI CMP 50HX에는 각 방향에서 이론적으로 약 1 GB/s의 대역폭을 제공하는 PCIe 1.0 x4 인터페이스가 탑재된 것으로 명시되어 있다.
채굴에서는 CPU와의 데이터 교환량이 상대적으로 적기 때문에 이것이 큰 문제가 되지 않았다. 그러나 LLM을 로드하거나 대규모 데이터 배열을 전송할 때는 느린 PCIe로 인해 대기 시간이 늘어난다.
실험적인 수정 방법을 사용하면 인터페이스를 PCIe Gen2 x4 모드로 전환할 수 있다. 이 모드의 이론적 대역폭은 각 방향에서 약 2 GB/s다. 수정 후 테스트 시스템에서 측정된 전송 속도는 약 1.7 GB/s에 달했다.
모델이 VRAM에 완전히 들어간다면 토큰 생성 속도는 PCIe의 영향을 비교적 적게 받을 수 있다. RAM과 GPU 사이에서 레이어를 이동해야 하는 경우에는 인터페이스의 영향이 훨씬 커진다.
채굴 성능
CMP 50HX는 처음부터 Ethash 알고리즘을 사용하는 Ethereum 채굴용으로 설계됐다. NVIDIA는 CMP 제품군에 대해 다음과 같은 수치를 제시했다.
| 그래픽카드 | Ethash | 소비전력 |
|---|---|---|
| CMP 30HX | 26 MH/s | 125 W |
| CMP 40HX | 36 MH/s | 185 W |
| CMP 50HX | 45 MH/s | 250 W |
| CMP 90HX | 86 MH/s | 320 W |
2021년 조건에서 NVIDIA가 레퍼런스 제품에 대해 제시한 사양.
CMP 50HX는 CMP 40HX보다 해시레이트가 25% 높았다. 그러나 2022년 9월 Ethereum이 Proof of Stake로 전환하면서 그래픽카드를 사용한 ETH 채굴은 중단됐다.
다른 알고리즘에 CMP 50HX를 사용하는 것은 가능하지만, 경제성은 네트워크 난이도와 전기 요금에 따라 달라진다.
CMP 50HX를 게임에 사용할 수 있을까
RTX 2080 Ti와 같은 계열임에도 CMP 50HX는 게임용으로 설계되지 않았다.
그래픽카드에 디스플레이 출력이 없고, 기본 구성에서는 그래픽 기능이 제한된다. 수정된 드라이버로 일부 애플리케이션을 실행할 수는 있지만, 게임과의 호환성이 보장되지는 않는다.
연산 기능의 잠금을 해제한 뒤에도 그래픽 파이프라인의 제한은 남는다. 따라서 RTX 2080 Ti의 성능을 CMP 50HX에 그대로 적용할 수는 없다.
2026년에 NVIDIA CMP 50HX를 구매할 가치가 있을까
CMP 50HX는 CUDA, 로컬 LLM 및 GPU 수정 실험을 위한 제품으로 관심을 끈다. 주요 장점은 10 GB GDDR6, 넓은 메모리 버스, 그리고 연산 성능을 복구할 수 있는 가능성이다.
그러나 일반적인 작업 시스템으로 사용하기에는 비표준 드라이버, 느린 PCIe, 디스플레이 출력 부재라는 제한이 남는다.
로컬 신경망용으로는 GeForce RTX 3060 12 GB가 더 범용적인 대안이다. 더 많은 비디오 메모리와 완전한 CUDA 지원, 표준 PCIe 인터페이스를 제공한다.
CMP 50HX는 RTX 3060보다 상당히 저렴하고 소프트웨어를 직접 설정할 의향이 있을 때 고려할 만하다. 수정 없이 안정적으로 사용하려면 일반 GeForce가 더 적합하다.
결론: NVIDIA CMP 50HX는 10 GB GDDR6을 탑재한 TU102 기반의 특수 가속기다. 2026년에 진행된 실험적인 잠금 해제에서는 FP32가 31.7배, DP4A가 28.4배 향상됐지만, 실제 LLM 성능에 미치는 영향은 별도의 측정이 더 필요하다. 이 카드는 연산 실험용으로는 흥미롭지만, 완전한 GeForce 대체품은 아니다.
GPU 비교
CMP 50HX을 다른 GPUs와 비교
기초적인
메모리 사양
디스플레이 및 미디어
이론적 성능
여러 가지 잡다한
벤치마크
다른 GPU와 비교


소셜 미디어에서 공유하기
또는 링크로 소개하기
<a href="https://cputronic.com/ko/gpu/nvidia-cmp-50hx" target="_blank">NVIDIA CMP 50HX</a>