NVIDIA Tesla V100 PCIe 16 GB
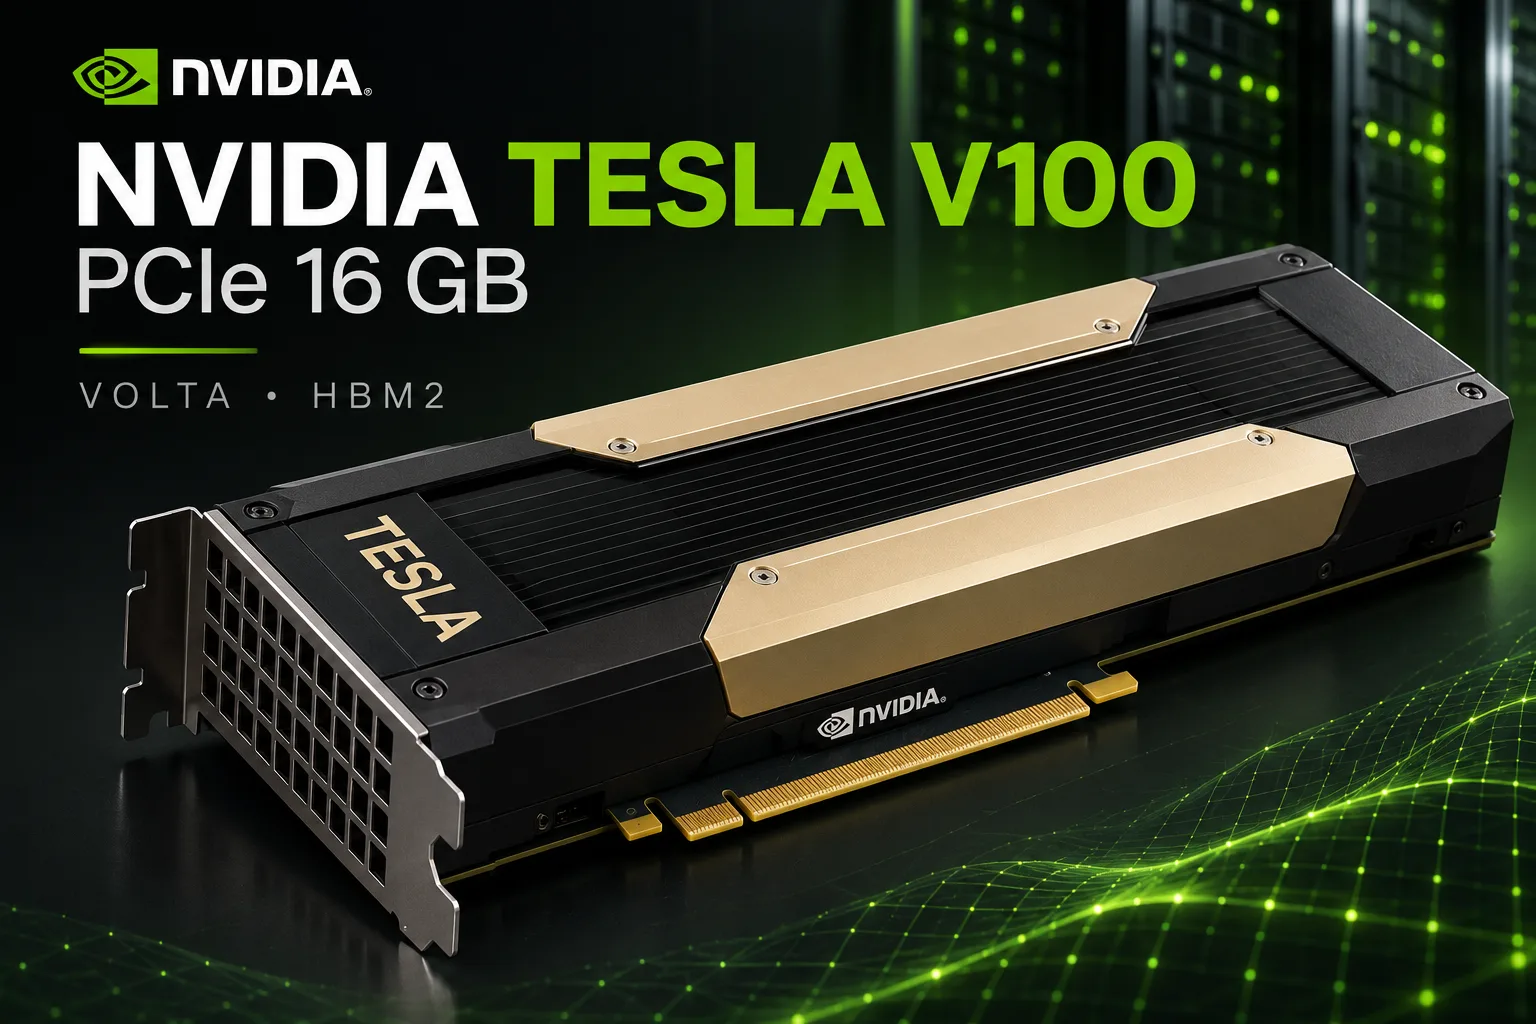
Tesla V100 PCIe 16 GB: 900 GB/s de HBM2 por poco dinero, pero con soporte CUDA limitado
La Tesla V100 PCIe 16 GB es un acelerador para servidores de 2017 que todavía resulta interesante para ejecutar redes neuronales localmente y realizar cálculos científicos. Su principal ventaja es la memoria HBM2, con un ancho de banda de 900 GB/s, casi como el de la GeForce RTX 3090. En el mercado de segunda mano, la tarjeta cuesta unos cientos de dólares, aunque las ofertas más baratas suelen corresponder a módulos SXM2 y no a tarjetas PCIe completas.
El precio reducido obliga a aceptar algunas limitaciones. La V100 no tiene salidas de vídeo ni trazado de rayos por hardware, sus 16 GB de memoria no bastan para los modelos de lenguaje grandes y el soporte para las versiones nuevas de CUDA ha terminado. NVIDIA ha dejado Volta en la rama de controladores R580, cuyo mantenimiento continuará hasta mediados de 2028. Para ejecutar LLM modernos, cada vez es más necesario seleccionar manualmente versiones compatibles del software.
Posición en la gama
La Tesla V100 está construida sobre el chip GV100, con una superficie de 815 mm² y fabricado mediante el proceso de 12 nm TSMC FFN. De los 84 multiprocesadores de streaming, 80 están activos, lo que proporciona 5120 núcleos CUDA y 640 núcleos tensoriales de primera generación. Cuatro pilas de HBM2 están conectadas mediante un bus de 4096 bits.
A partir del GV100, NVIDIA lanzó varios aceleradores con distintas capacidades de memoria, frecuencias e interfaces.
| Modelo | Memoria | Ancho de banda | Boost | TDP | Características |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16, sin NVLink |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | El doble de memoria |
| Tesla V100 SXM2 16/32 GB | 16/32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, compatible con NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | HBM2 más rápida |
| Titan V | 12 GB HBM2 | 653 GB/s | 1455 MHz | 250 W | Salidas de vídeo, bus de 3072 bits |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | Gráficos profesionales |
La versión PCIe de 16 GB alcanza hasta 14 TFLOPS en FP32, 7 TFLOPS en FP64 y 112 TFLOPS en cálculos tensoriales FP16. Es ligeramente inferior a la SXM2, que tiene una frecuencia más alta y un límite de potencia superior.
Volta fue la primera arquitectura de NVIDIA en incorporar núcleos tensoriales. Sin embargo, estos solo son compatibles con FP16 y no funcionan con BF16, TF32 ni FP8. La ausencia de estos formatos limita la eficiencia de las bibliotecas y los modelos modernos. El GV100 tampoco tiene núcleos RT por hardware.
Rendimiento
Modelos de lenguaje locales
Durante la generación de tokens, el rendimiento suele estar limitado por la velocidad de lectura de los pesos desde la memoria de vídeo. Por eso, la V100, con sus 900 GB/s, sigue siendo competitiva incluso frente a GPU considerablemente más nuevas.
Como referencia se puede utilizar la tabla de resultados de Llama 2 7B con cuantización Q4_0 publicada por los desarrolladores de llama.cpp. En ella se mide la velocidad de procesamiento de un prompt de 512 tokens y la generación de 128 tokens sin FlashAttention.
| Tarjeta gráfica | Memoria | Procesamiento del prompt, tok/s | Generación, tok/s |
|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1007 | 55 |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 3043 | 129 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5175 | 158 |
| GeForce RTX 4090 | 24 GB GDDR6X | 11 993 | 186 |
| GeForce RTX 5090 | 32 GB GDDR7 | 14 073 | 290 |
Los resultados proceden de pruebas realizadas por distintos usuarios. El modelo y los parámetros principales son los mismos, pero pueden variar las versiones de llama.cpp, los controladores y las configuraciones de los sistemas.
En la tabla se probó una V100 PCIe de 32 GB. La versión de 16 GB tiene las mismas frecuencias y el mismo ancho de banda de HBM2, mientras que el modelo ocupa menos de 4 GB. Por ello, se espera un rendimiento similar, aunque aquí no hay una medición directa de la tarjeta de 16 GB.
En generación, la V100 queda aproximadamente un 18 % por detrás de la RTX 3090, mientras que en el procesamiento del prompt la diferencia es del 41 %. En un diálogo corto, la diferencia no siempre resulta importante, pero se hace más evidente al procesar documentos grandes y un historial de conversación extenso.
La RTX 4090 procesa el prompt casi cuatro veces más rápido que la V100, aunque su ventaja en generación es de solo un 44 %. Esto demuestra por qué el ancho de banda de memoria por sí solo no determina el rendimiento en todas las tareas.
La principal limitación de la V100 PCIe 16 GB es la capacidad de memoria. La tarjeta es adecuada para modelos de entre 7.000 y 14.000 millones de parámetros con cuantización de 4 bits. Los modelos de entre 27.000 y 32.000 millones de parámetros normalmente requieren descargar parte del modelo en la memoria RAM o aplicar una compresión más agresiva. En ambos casos hay que aceptar compromisos en velocidad, calidad o longitud del contexto.
Entrenamiento y cálculos científicos
La V100 se diseñó principalmente para entrenar redes neuronales y realizar cálculos de alto rendimiento. Sus núcleos tensoriales FP16 siguen siendo útiles, pero los aceleradores nuevos incorporan formatos de cálculo más eficientes, cachés más grandes y bibliotecas optimizadas.
Las limitaciones son especialmente visibles al entrenar modelos que utilizan BF16. La V100 no ofrece soporte por hardware para este formato, por lo que no todas las configuraciones modernas de PyTorch y otros frameworks pueden trasladarse a Volta sin modificaciones.
En cambio, en cálculos de doble precisión la tarjeta conserva una ventaja considerable frente a las GeForce orientadas a juegos. Su rendimiento alcanza 7 TFLOPS en FP64, aproximadamente 5,4 veces más que el de la RTX 4090.
Para dinámica molecular, modelado numérico y otras tareas de HPC, la V100 sigue siendo interesante si el software utilizado es compatible con Volta. Sin embargo, la elevada velocidad nominal en FP64 no garantiza por sí sola la misma ventaja en un programa concreto.
¿Se puede jugar con una Tesla V100?
La V100 PCIe no tiene salidas de vídeo. Para mostrar la imagen se necesita otra tarjeta gráfica o los gráficos integrados del procesador. En Windows también es necesario elegir un controlador compatible y configurar los juegos para que se ejecuten en el acelerador de cálculo.
Los entusiastas probaron las capacidades para juegos de una V100 SXM2 de 16 GB mediante un adaptador PCIe. En un sistema con un Ryzen 7 5700GE, la tarjeta obtuvo los siguientes resultados con ajustes altos, sin reescalado ni generación de fotogramas.
| Juego | 2560×1080, FPS medios | 3440×1440, FPS medios |
|---|---|---|
| Cyberpunk 2077 | ~78 | ~56 |
| Hogwarts Legacy | ~55-60 | ~40 |
| Atomic Heart | ~115 | ~75-80 |
| Red Dead Redemption 2 | ~80 | ~65 |
En Cyberpunk 2077, el consumo del acelerador era de aproximadamente 181 W. Los resultados demuestran que Volta todavía puede ejecutar juegos modernos, aunque la ausencia de DLSS y de trazado de rayos por hardware limita considerablemente sus posibilidades.
Es importante señalar que estas son pruebas de una SXM2, no de una PCIe. La SXM2 alcanza una frecuencia Boost de 1530 MHz frente a los 1380 MHz de la PCIe, y su límite de potencia es 50 W superior. Por tanto, la versión PCIe puede ser más lenta. Sin mediciones independientes no es posible determinar la diferencia en FPS.
No resulta rentable comprar una V100 específicamente para jugar. Una GeForce convencional es más fácil de instalar, es compatible con las tecnologías gráficas modernas y no necesita otra tarjeta gráfica para mostrar la imagen.
Instalación en un ordenador convencional
A diferencia de la SXM2, la Tesla V100 PCIe se conecta directamente a una ranura PCIe x16 estándar. Sin embargo, instalarla en un PC doméstico requiere cierta preparación.
Alimentación. La V100 PCIe de referencia incorpora un conector de alimentación CPU EPS12V de 8 pines. Es diferente del conector PCIe convencional de 8 pines. NVIDIA permite conectar un cable EPS12V adecuado o utilizar un adaptador especial con conectores PCIe.
Antes del primer encendido, es necesario comprobar la asignación de pines y la carga admisible de los cables. No se debe conectar un cable inadecuado solo porque el conector parezca similar.
Refrigeración. La tarjeta está equipada con un disipador pasivo diseñado para recibir un flujo de aire intenso dentro de un servidor. En una caja convencional será necesario instalar un ventilador independiente con flujo de aire dirigido.
Sin una refrigeración suficiente, el acelerador puede reducir sus frecuencias o sobrecalentarse. No solo hay que comprobar la temperatura del núcleo, sino también la estabilidad durante una carga prolongada.
Consumo. El límite nominal es de 250 W. Mediante nvidia-smi se puede reducir la potencia permitida, por ejemplo, hasta 180 W. Esto disminuirá la temperatura y las exigencias de refrigeración, pero el efecto sobre el rendimiento dependerá de la tarea.
Soporte de software: la principal limitación
NVIDIA ha confirmado que R580 será la última rama de controladores compatible con Maxwell, Pascal y Volta. Para los aceleradores de servidor, pertenece a la línea de soporte a largo plazo, cuyo mantenimiento terminará en junio de 2028.
CUDA 13 ya no permite compilar aplicaciones para la arquitectura Volta con la capacidad de cómputo sm_70. La última rama compatible de CUDA Toolkit es la 12.x, incluida la versión 12.9.
No obstante, la V100 no dejó de funcionar tras la llegada de CUDA 13. Los programas compilados con soporte para Volta en versiones anteriores de CUDA siguen ejecutándose con controladores compatibles.
El problema está en las nuevas versiones de los programas y las bibliotecas:
- llama.cpp. El código fuente permite compilar versiones compatibles con sm_70, pero las nuevas optimizaciones pueden no ser compatibles con Volta.
- PyTorch. Para la V100 es necesario elegir compilaciones compatibles con CUDA 12.x y con las arquitecturas de cómputo correspondientes.
- LM Studio y Ollama. La compatibilidad depende de la versión de la aplicación y del CUDA Runtime incluido. Algunas funciones pueden requerir compilaciones más antiguas.
- FlashAttention 2. La implementación CUDA convencional está diseñada para arquitecturas más nuevas, por lo que en la V100 es necesario utilizar mecanismos alternativos para procesar la atención.
Para experimentos domésticos, esto resulta aceptable: es posible conservar un entorno compatible y actualizarlo de forma selectiva. Para un servidor de producción, las limitaciones son más importantes, ya que las nuevas versiones de los frameworks van dejando de admitir Volta progresivamente.
Precios en el mercado de segunda mano
El precio de la V100 varía considerablemente según la versión. Los módulos SXM2 baratos suelen aparecer entre los resultados generales de búsqueda de Tesla V100, aunque no se pueden instalar en un PC sin un adaptador.
Según el resumen de las ofertas de eBay del 28 de octubre de 2026, la situación es la siguiente:
| Tarjeta gráfica | Rango inferior de ofertas | Mediana de los anuncios |
|---|---|---|
| Tesla V100 PCIe 16 GB, versión pasiva | $329 | $422 |
| Tesla V100 SXM2 16 GB | $191 | $300 |
| Tesla V100 SXM2 32 GB | $842 | $990 |
| Tesla V100 PCIe 32 GB, versión pasiva | $860 | $960 |
| GeForce RTX 3090 24 GB | $1651 | $1970 |
Los precios corresponden a anuncios activos, no a transacciones finalizadas. Algunas unidades Tesla V100 PCIe 16 GB se vendieron por aproximadamente $240-275, pero esas ofertas no pueden considerarse disponibles de forma garantizada.
Para una versión PCIe de 16 GB, es razonable considerar un precio de $300-350 por una tarjeta funcional que se pueda probar. A unos $400, la compra resulta menos atractiva, especialmente si además se necesitan refrigeración y un cable de alimentación.
El coste de un equipo doméstico completo puede ser considerablemente superior al precio del propio acelerador. Por ello, las comparaciones con otras opciones deben hacerse solo después de tener en cuenta todos los componentes.
Competidores y alternativas
Tesla V100 SXM2 16 GB. El módulo es más barato que la versión PCIe, pero requiere un adaptador, alimentación y un sistema de refrigeración independiente. El coste total puede acabar siendo similar al de una tarjeta PCIe completa. Para una sola GPU, la ventaja de la SXM2 normalmente no compensa la complejidad del montaje. La situación es diferente en el caso de placas con varios módulos y NVLink.
Tesla V100 PCIe 32 GB. Ofrece la misma arquitectura de cómputo y el mismo ancho de banda de memoria, pero duplica la capacidad de HBM2. Es mucho más adecuada para modelos de lenguaje de entre 27.000 y 32.000 millones de parámetros. Sin embargo, con un precio de $800-1000, la ventaja económica de una arquitectura antigua ya no resulta tan evidente.
GeForce RTX 3090 24 GB. Es más rápida al procesar prompts, es compatible con BF16 y con las optimizaciones CUDA modernas, y cuenta con trazado de rayos por hardware. Sus 24 GB permiten trabajar con modelos más grandes que los que caben en una V100 de 16 GB. En el mercado de segunda mano aparecen anuncios desde aproximadamente $1200, aunque la mayoría de las ofertas son más caras. Es una tarjeta más versátil, pero el sobreprecio es considerable.
GeForce RTX 5060 Ti 16 GB. Ofrece una arquitectura nueva, compatibilidad con las bibliotecas actuales, salidas de vídeo, DLSS 4 y garantía del fabricante. Su ancho de banda de memoria es menor: 448 GB/s frente a los 900 GB/s de la V100. Sin embargo, no se puede predecir directamente la velocidad de los LLM a partir de esa diferencia: los núcleos de cómputo modernos y las optimizaciones de software pueden compensar el menor ancho de banda. Para jugar y trabajar a diario, la RTX 5060 Ti es preferible.
AMD Instinct MI50 32 GB. Es una alternativa con el doble de capacidad de HBM2, un ancho de banda de aproximadamente 1 TB/s y un alto rendimiento en FP64. Los precios de algunos anuncios comienzan en torno a $650. Su principal limitación es el soporte de ROCm, cada vez más obsoleto, y las dificultades con el software de cálculo moderno. Para programas diseñados para CUDA, la V100 suele ser más sencilla.
Tesla P40 24 GB. Es una tarjeta más antigua, con GDDR5 y 24 GB de memoria. En la prueba de llama.cpp genera unos 55 tok/s, frente a los 129 de la V100. Sin embargo, sus 8 GB adicionales permiten ejecutar modelos que no caben en los 16 GB de la V100. Por ello, la P40 sigue siendo una alternativa cuando la capacidad de memoria es más importante que la velocidad.
¿Vale la pena comprar una Tesla V100 PCIe 16 GB?
La Tesla V100 PCIe 16 GB sigue siendo atractiva para redes neuronales locales, cálculos científicos y experimentos con CUDA. Por unos cientos de dólares, el comprador obtiene 900 GB/s de ancho de banda de memoria, 640 núcleos tensoriales y 7 TFLOPS en FP64.
Sin embargo, 16 GB limitan la elección de modelos de lenguaje y el soporte de software para Volta se reduce progresivamente. La tarjeta requiere refrigeración dirigida, una alimentación adecuada y seleccionar cuidadosamente las versiones de los controladores y las bibliotecas.
A un precio de hasta $300-350, la V100 PCIe 16 GB puede considerarse una buena compra para un equipo de cálculo doméstico. Si la tarjeta cuesta $400 o más, conviene compararla con una SXM2 de 16 GB, una P40 de 24 GB y aceleradores más modernos, teniendo en cuenta los costes de instalación.
Para modelos de hasta 14.000 millones de parámetros, las capacidades de la V100 suelen ser suficientes. Si el objetivo es ejecutar localmente modelos de entre 27.000 y 32.000 millones de parámetros sin descargarlos en la memoria RAM, es mejor considerar desde el principio una tarjeta gráfica con 24-32 GB de memoria.
La V100 merece la pena por tareas de cálculo concretas, no como tarjeta gráfica universal. Su rendimiento todavía basta para muchos experimentos, pero ya no se puede contar con un soporte completo para el software nuevo durante los próximos años.
Comparación de GPU
Comparar Tesla V100 PCIe 16 GB con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Comparaciones de GPU relacionadas


Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/es/gpu/nvidia-tesla-v100-pcie-16-gb" target="_blank">NVIDIA Tesla V100 PCIe 16 GB</a>