NVIDIA Tesla P100 PCIe 12 GB

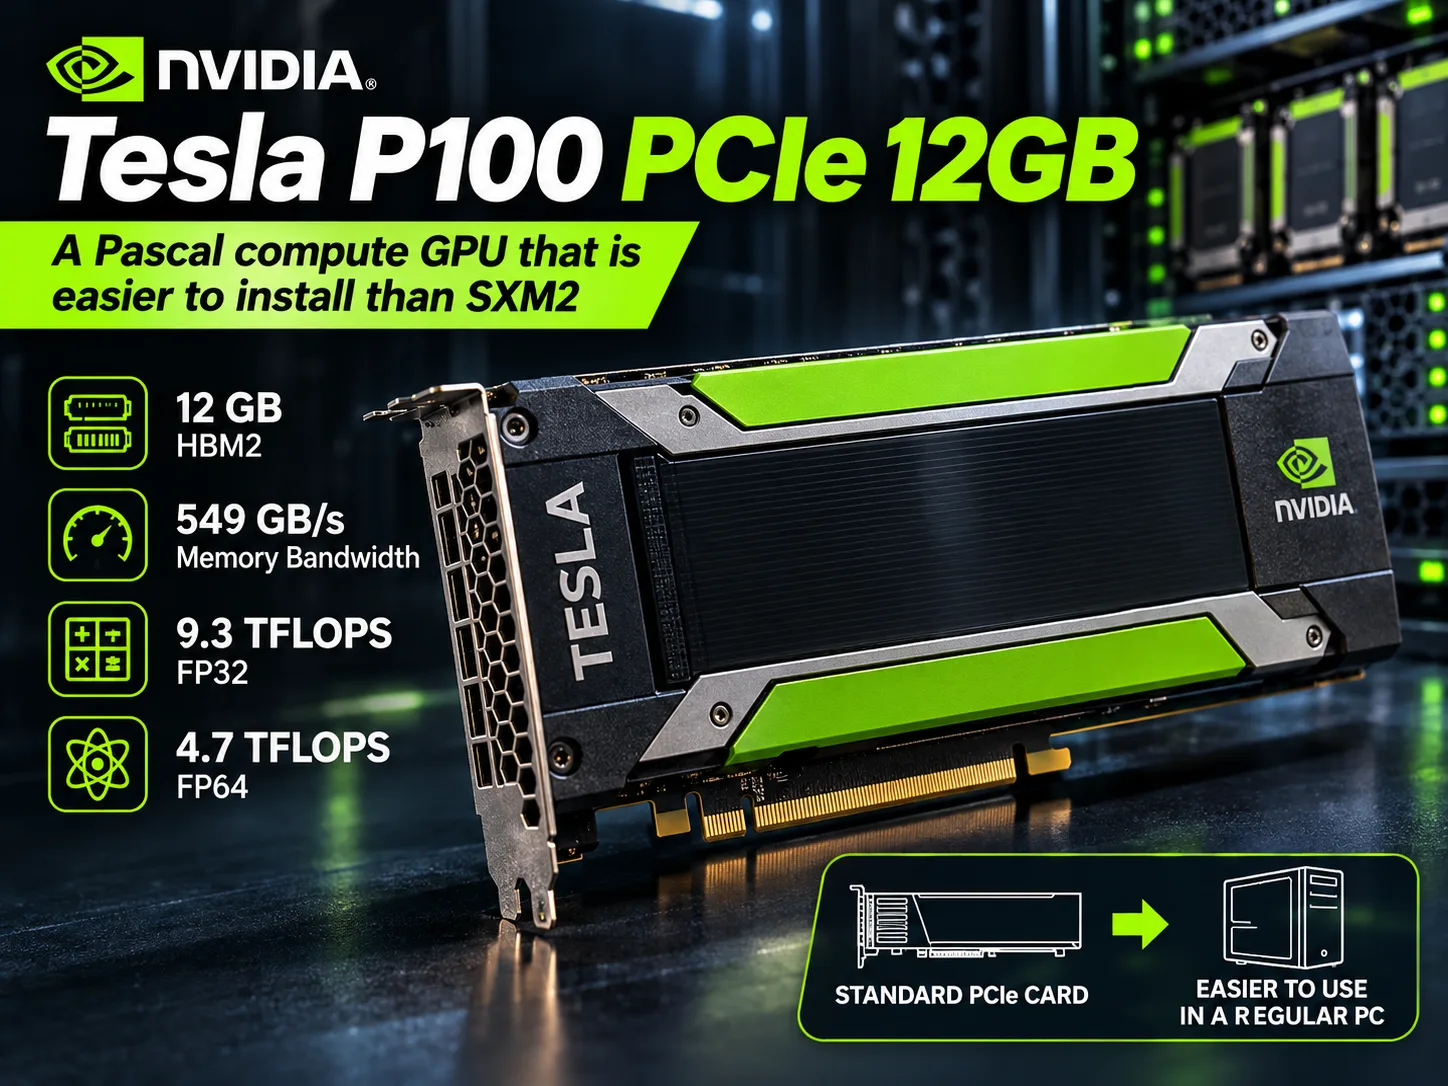
Tesla P100 PCIe 12 GB: una calculadora FP64 por $80 con fecha de retirada
Tesla P100 fue el primer acelerador de NVIDIA basado en la arquitectura Pascal y, en 2016-2017, una de las principales tarjetas para supercomputación y entrenamiento de redes neuronales. En aquel entonces, la versión de 12 GB para PCIe costaba alrededor de $4600. Ahora estas tarjetas salen de servidores retirados y se venden en eBay por $70-140, menos que una tarjeta gráfica gaming económica.
Se compran por la doble precisión y la memoria HBM2. En FP64, la tarjeta alcanza 4,7 TFLOPS, más que la RTX 4090. La versión pequeña sale peor parada en memoria: uno de los cuatro stacks HBM2 está desactivado, por lo que la capacidad y el ancho de banda son un 25 % menores que en la P100 de 16 GB. Todo el soporte de software para Pascal termina junto con la rama de controladores R580, a mediados de 2028.
Posición en la gama y arquitectura
Todas las Tesla P100 están construidas sobre GP100, un chip de 16 nm con una superficie de 610 mm² que se monta en un sustrato CoWoS junto con cuatro stacks de HBM2. De los 3840 núcleos CUDA del chip completo, la P100 tiene 3584 activos. La versión PCIe funciona a 1190-1329 MHz con un TDP de 250 W.
La versión de 12 GB utiliza la misma placa, pero con un stack de memoria desactivado. El núcleo y las frecuencias no han cambiado, por lo que su potencia de cálculo es la misma que la del modelo superior.
| Modelo | Memoria | Bus | Ancho de banda | FP64 | FP16 | TDP |
|---|---|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 GB HBM2 | 3072 bits | 549 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 4096 bits | 732 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 SXM2 | 16 GB HBM2 | 4096 bits | 732 GB/s | 5,3 TFLOPS | 21,2 TFLOPS | 300 W |
| Tesla P40 | 24 GB GDDR5 | 384 bits | 347 GB/s | 1/32 de FP32 | 1/64 de FP32 | 250 W |
El chip GP100 no llegó a GeForce. Su pariente más cercano para estaciones de trabajo es la Quadro GP100, con salidas de vídeo. GTX 1080 Ti y Tesla P40 están fabricadas con otro chip, GP102. GP100 calcula FP64 a la mitad de la velocidad de FP32 y FP16 al doble, mientras que en GP102 ambos modos están prácticamente anulados. A cambio, GP100 (compute capability 6.0) no tiene instrucciones DP4A para el producto escalar entero, presentes en GP102. Para las redes neuronales cuantizadas, esto resultó ser más importante de lo que parecía en 2016.
La P100 no tiene núcleos tensoriales. Aparecieron en 2017 con la Tesla V100, basada en la arquitectura Volta.
Rendimiento
La tarjeta no sirve para jugar. No tiene salidas de vídeo, y los entusiastas que sacaban la imagen a través de una segunda tarjeta se quejan de los controladores para centros de datos y no recomiendan la P100 para juegos. Donde todavía funciona es en modelos lingüísticos locales y cálculos de doble precisión.
Tabla comparativa de la comunidad de llama.cpp para CUDA (Llama 2 7B, Q4_0, sin Flash Attention):
| Acelerador | Memoria | Procesamiento del prompt, tok/s | Generación, tok/s |
|---|---|---|---|
| RTX 3090 | 24 GB GDDR6X | 5174 | 158 |
| Tesla V100 | 32 GB HBM2 | 3043 | 129 |
| RTX 2080 Ti | 11 GB GDDR6 | 2890 | 107 |
| GTX 1080 Ti | 11 GB GDDR5X | 1084 | 62 |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 761 | 58,4 |
| Tesla P40 | 24 GB GDDR5 | 1007 | 54,7 |
| Tesla T4 | 16 GB GDDR6 | 1219 | 46,4 |
La P100 genera texto al nivel de una GTX 1080 Ti y una P40. Procesa el prompt 3,8 veces más despacio que una RTX 2080 Ti y también más despacio que la propia P40. Con consultas cortas en un chat es tolerable, pero con documentos largos el modelo tarda bastante en «leer» el texto antes de responder.
Una prueba de ComputingForGeeks con una versión reciente de llama.cpp, realizada en octubre de 2026, mostró lo mismo. Con Qwen3 8B en Q4_K_M, la P100 de 16 GB alcanzó 38,4 tok/s frente a los 47 de la P40, aunque la memoria de la P100 es el doble de rápida. La causa es la ausencia de DP4A: con compute capability 6.0, los kernels cuantizados de llama.cpp siguen una ruta lenta.
Por eso, el bus recortado de la versión de 12 GB apenas supone un problema en los modelos lingüísticos. En la prueba con Llama 2 7B, la P100 de 16 GB mueve alrededor de 220 GB/s, menos de un tercio de su ancho de banda máximo; es decir, está limitada por el cálculo. No hay mediciones independientes de la versión pequeña en llama.cpp, pero con modelos pequeños su velocidad de generación debería ser cercana a la de la versión de 16 GB. El problema de los 12 GB es la capacidad: gpt-oss-20b y los modelos densos de más de 14B no caben en ella.
Con FP64 ocurre lo contrario. La RTX 4090 alcanza alrededor de 1,3 TFLOPS en doble precisión, y la RTX 3090 ofrece diez veces menos que la P100. Las únicas tarjetas cercanas en FP64 son modelos de servidor de la siguiente generación: la V100 PCIe, con 7 TFLOPS, y la AMD Instinct MI50, con 6,6 TFLOPS. En cálculos limitados por la memoria FP64, como los métodos de malla y la hidrodinámica, la versión de 12 GB perderá frente al modelo superior hasta un 25 %.
Resultados en sistemas concretos
Casi no hay pruebas publicadas específicamente de la versión de 12 GB, por lo que la tabla también incluye resultados del modelo de 16 GB con el mismo chip.
| Sistema | Configuración | Versión de P100 | Prueba | Resultado |
|---|---|---|---|---|
| Uniwide RB228H | 2× Xeon E5-2699 v4 | PCIe 12 GB | SPEC ACCEL OpenCL, base | 5,15 |
| Servidor de hosting de Database Mart | 2× Xeon E5-2660 v2, 128 GB DDR3 | PCIe 16 GB | Ollama, Llama 2 7B | 49,7 tok/s |
| Nodo alquilado de vast.ai | n/d | PCIe 16 GB | llama.cpp, Qwen3 8B Q4_K_M | 38,4 tok/s |
La diferencia entre 49,7 y 38,4 tok/s se debe al modelo y a la cuantización, no al servidor. Si el modelo cabe por completo en la memoria de vídeo, el procesador apenas influye en la velocidad de generación, y ni siquiera una plataforma con un Xeon E5 v2 de 2013 ralentiza la tarjeta.
En reposo, la P100 consume 28 W y la P40, 11 W. Bajo carga de un LLM, el consumo máximo de la P100 llega a 211 W.
Dónde se encuentra, precios y disponibilidad
Ya no se venden dispositivos nuevos con una P100. En su momento, la tarjeta se ofrecía como opción en los servidores Dell PowerEdge R730, R740, C4130 y C4140, Cisco UCS C240 M5 y C220 M5SX, y HPE ProLiant. De ahí llega al mercado de segunda mano, normalmente sin cables.
| Variante | Estado | Precio |
|---|---|---|
| Tesla P100 PCIe 12 GB | usada, lotes grandes | $70-100 |
| Tesla P100 PCIe 12 GB | usada, con comprobación y devolución | $110-165 |
| Tesla P100 PCIe 16 GB | usada, lotes procedentes de China | $118-130 |
| Tesla P100 PCIe 16 GB | reacondicionada, Amazon | alrededor de $155 |
Para instalar la tarjeta en un PC convencional habrá que comprar algunos elementos adicionales:
| Qué se necesita | Para qué | Precio |
|---|---|---|
| Carcasa y ventilador tipo turbina | la refrigeración es pasiva | desde $20 más el ventilador |
| Adaptador a 8 pines EPS | conector de procesador, no PCIe | alrededor de $13 |
| Gráficos integrados o una segunda tarjeta | no hay salidas de vídeo | - |
La opción Above 4G Decoding debe estar activada en la BIOS. No es posible instalar una P100 en el mismo sistema que una tarjeta Blackwell: necesitan módulos del kernel de NVIDIA diferentes. Al final, una P100 de 12 GB lista para funcionar cuesta $110-150.
Competidores y alternativas
Tesla P100 PCIe 16 GB (alrededor de $130-155). Lleva el mismo chip, tiene 4 GB más de memoria y un ancho de banda un tercio mayor. Pagar $40-60 adicionales permite utilizar gpt-oss-20b, modelos 14B con un contexto normal y alcanzar la velocidad completa en las tareas limitadas por la memoria. La versión pequeña solo sigue siendo más rentable para cálculos FP64 en los que la capacidad no es importante: calcula a la misma velocidad y cuesta menos.
Tesla P40 24 GB (alrededor de $300-350). Tiene el doble de memoria e incluye DP4A; los modelos 32B en Q4 caben enteros y generan alrededor de 12 tok/s. En la práctica no tiene FP16 ni FP64, por lo que no sirve para cálculos. Para modelos de más de 14B es más útil que cualquier P100.
Tesla V100 PCIe 16 GB (alrededor de $365). Tiene núcleos tensoriales, procesa el prompt entre 3 y 4 veces más rápido y alcanza 7 TFLOPS en FP64. Su soporte terminará igual que el de Pascal. Por el triple de dinero se obtiene una tarjeta claramente más rápida, pero con el mismo plazo de vida.
GeForce RTX 3060 12 GB (alrededor de $300-320 usada). Tiene la misma cantidad de memoria, pero son compatibles con ella CUDA, vLLM y las futuras versiones de PyTorch. También cuenta con salidas de vídeo y refrigeración convencional, y consume 170 W. Los núcleos tensoriales aceleran notablemente el procesamiento del prompt. La doble precisión es simbólica. Si se necesita una tarjeta gráfica convencional con software que siga teniendo soporte durante varios años, la RTX 3060 es más rentable, aunque cuesta el triple.
Conclusión
En modelos lingüísticos, la P100 de 12 GB genera texto como una GTX 1080 Ti, pero procesa el prompt entre 3 y 4 veces más despacio que una RTX 2080 Ti. Es suficiente para modelos 7-14B con cuantización de 4 bits y para experimentar con Ollama y llama.cpp en un servidor antiguo. Los modelos de más de 14B no caben en ella y los prompts largos se procesan despacio. vLLM no es compatible, PyTorch ha anunciado que dejará de ofrecer compilaciones preparadas para Pascal y los controladores dejarán de publicarse en 2028. A eso se suman los 250 W y una turbina ruidosa.
No merece la pena pagar más de $80 por esta tarjeta. Si se necesitan modelos de más de 14B, hay que optar por una P40; si se necesita software que funcione después de 2028, por una RTX 3060 de 12 GB.
Para cálculos de doble precisión, por $70-80 la P100 de 12 GB casi no tiene competencia. Para redes neuronales, es mejor pagar $50 más y elegir la versión de 16 GB.
Comparación de GPU
Comparar Tesla P100 PCIe 12 GB con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/es/gpu/nvidia-tesla-p100-pcie-12-gb" target="_blank">NVIDIA Tesla P100 PCIe 12 GB</a>