NVIDIA Tesla P40
NVIDIA Tesla P40: Warum ein LLM auf einer Grafikkarte von 2016 ausführen?
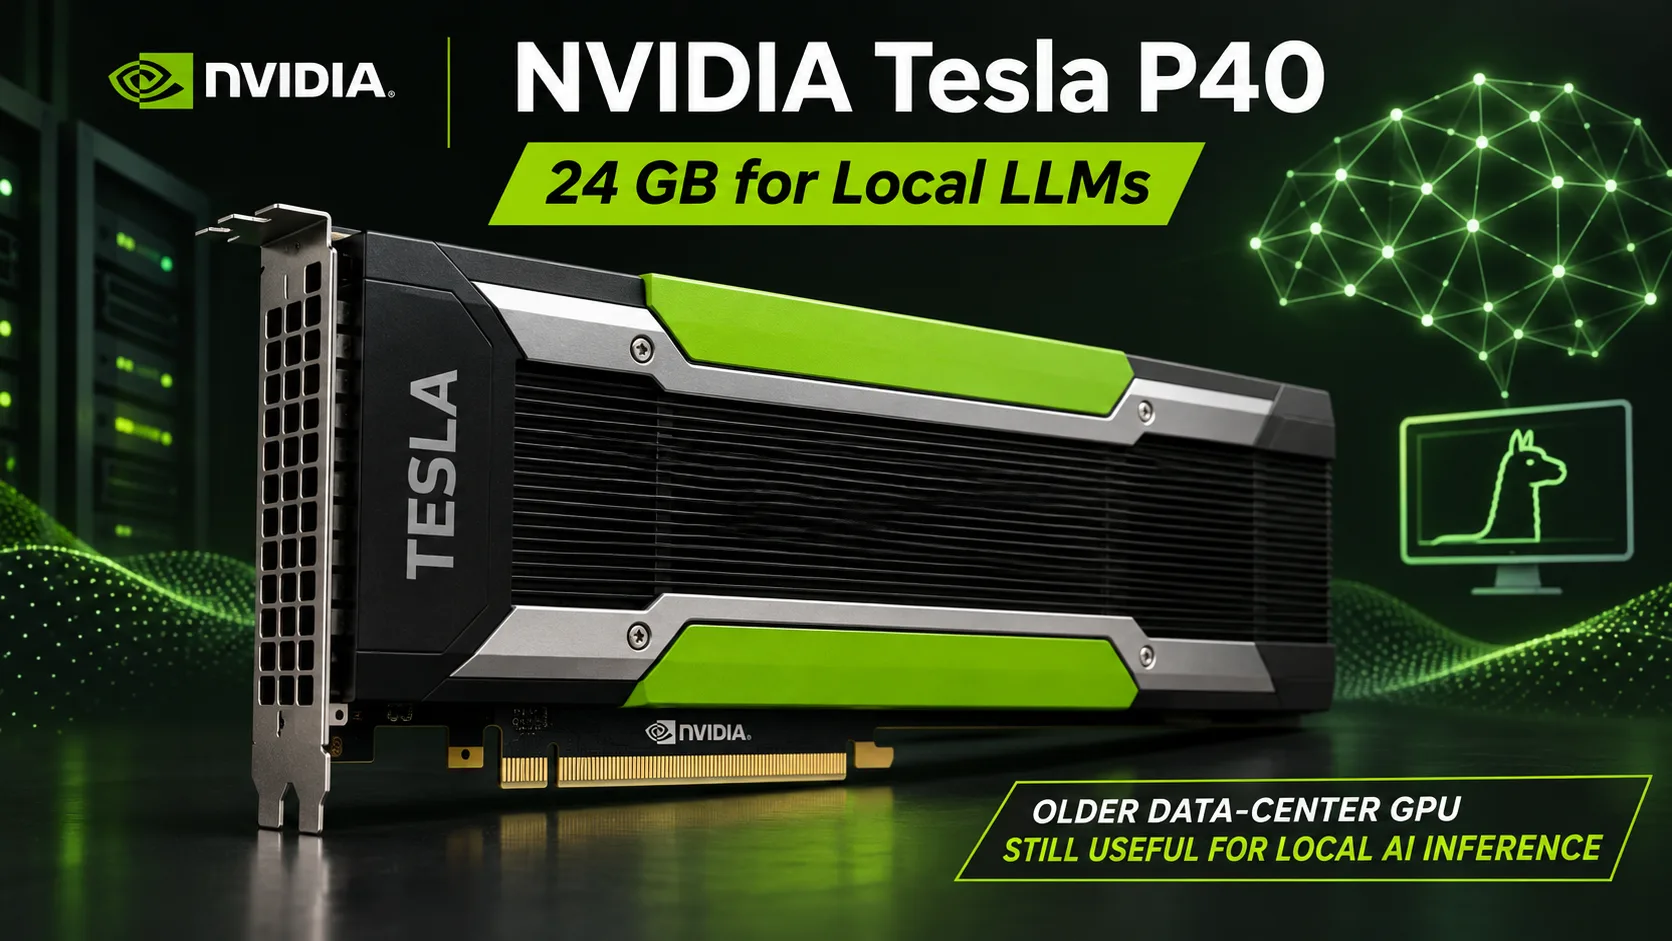
Die NVIDIA Tesla P40 erschien 2016 als Serverbeschleuniger für neuronale Netze. Zehn Jahre später zieht sie dank ihrer 24 GB Videospeicher Aufmerksamkeit auf sich. Das reicht aus, um einige Sprachmodelle mit 30-32 Milliarden Parametern auszuführen, die nicht in den Videospeicher der meisten günstigen Gaming-GPUs passen.
Die Pascal-Architektur begrenzt die Leistung allerdings deutlich. Die Tesla P40 verfügt über keine Tensor Cores, FP16-Berechnungen sind langsam, und die passive Kühlung muss für den Einbau in einen gewöhnlichen Computer angepasst werden. Wie nützlich sind ihre 24 GB im Jahr 2026?
24 GB Speicher auf Pascal-Architektur
Die Tesla P40 basiert auf dem Chip GP102, der mit der GeForce GTX 1080 Ti verwandt ist. Sie verfügt über 3840 CUDA-Kerne, die GPU taktet mit 1303-1531 MHz. Die Karte ist mit GDDR5-Speicher an einem 384-Bit-Speicherinterface und einer Speicherbandbreite von 346 GB/s ausgestattet.
Im Gegensatz zur Tesla P100, die den Chip GP100 und HBM2-Speicher verwendet, war die P40 vor allem auf die Inferenz neuronaler Netze ausgelegt. Ihre FP16-Leistung beträgt etwa 0,19 TFLOPS - ungefähr 64-mal weniger als bei FP32.
| Grafikkarte | Speicher | Speicherbandbreite | FP16 | Tensor Cores |
|---|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB GDDR5 | 346 GB/s | ~0,19 TFLOPS | Nein |
| NVIDIA Tesla P100 PCIe | 16 GB HBM2 | 732 GB/s | 18,7 TFLOPS | Nein |
| NVIDIA Tesla V100 PCIe | 32 GB HBM2 | 900 GB/s | ~28 TFLOPS | 640 |
NVIDIA gab für die P40 bis zu 12 TFLOPS bei FP32 und 47 TOPS bei INT8 an. Diese Werte lassen sich jedoch nicht direkt in die Geschwindigkeit moderner LLMs übertragen. Das Ergebnis hängt vom Modellformat, den verwendeten Rechenoperationen und der Optimierung der Software ab.
Leistung in Tests mit llama.cpp
Für die Tesla P40 sind Tests zur Textgenerierung besonders aussagekräftig. Nachfolgend sind Ergebnisse von llama.cpp mit dem Modell Llama 2 7B in der Quantisierung Q4_0 aufgeführt.
| Grafikkarte | Speicher | Prompt-Verarbeitung, tok/s | Generierung, tok/s |
|---|---|---|---|
| NVIDIA Tesla P40 | 24 GB | 1007 | 54,7 |
| NVIDIA Tesla P100 | 16 GB | 761 | 58,4 |
| NVIDIA Tesla V100 | 32 GB | 3043 | 129,1 |
| NVIDIA GeForce RTX 3060 | 12 GB | 2138 | 75,6 |
| NVIDIA GeForce RTX 3090 | 24 GB | 5175 | 158,2 |
llama-bench-Test: Verarbeitung von 512 Eingabetokens (pp512) und Generierung von 128 Tokens (tg128), CUDA ohne Flash Attention. Die Ergebnisse wurden auf unterschiedlichen Systemen und mit verschiedenen Versionen von llama.cpp ermittelt, daher ist der Vergleich nur als Richtwert zu verstehen.
Bei der Textgenerierung liegt die Tesla P40 trotz der deutlich geringeren Speicherbandbreite fast gleichauf mit der P100. Die RTX 3060 ist etwa 38 % schneller, die RTX 3090 fast dreimal so schnell.
Bei der Verarbeitung des Eingabeprompts ist der Unterschied größer: Die RTX 3090 liegt mehr als fünfmal vor der P40. Das macht sich besonders bei der Verarbeitung langer Dokumente bemerkbar, wenn vor der Generierung einer Antwort Tausende Eingabetokens verarbeitet werden müssen.
Llama 2 7B passt allerdings sogar in 8 GB Videospeicher. Ein solcher Test zeigt die GPU-Geschwindigkeit, macht aber den entscheidenden Vorteil der P40 nicht sichtbar - die Möglichkeit, größere Modelle auszuführen.
Welche LLMs in 24 GB passen
Ein gutes Beispiel ist Qwen2.5-32B-Instruct. Im GGUF-Format mit der Quantisierung Q4_K_M belegen die Modellgewichte etwa 19,9 GB. Auf der Tesla P40 bleibt Platz für den KV-Cache und Berechnungspuffer, wobei die verfügbare Kontextlänge von den Startparametern abhängt.
Auf einer RTX 3060 mit 12 GB passt ein solches Modell nicht vollständig in den Videospeicher. Es muss entweder eine stärkere Quantisierung verwendet oder ein Teil der Berechnungen in den Arbeitsspeicher ausgelagert werden.
Die Möglichkeiten der Tesla P40 hängen von der Größe und dem Format des Modells ab:
- 7B-8B: Ausreichend Speicher für Q4, Q8 und einen relativ langen Kontext.
- 14B: Viele Modelle passen sogar in Q8_0, sodass Speicher für Verwaltungsdaten übrig bleibt.
- 30B-32B: Der Betrieb mit Q4 ist möglich, wenn die Größe des KV-Caches und der anderen Puffer passend gewählt wird.
Speicherkapazität darf nicht mit Leistung verwechselt werden. Ein Modell mit 32 Milliarden Parametern erfordert deutlich mehr Berechnungen als Llama 2 7B. Die oben genannten Ergebnisse können ohne separate Tests nicht zur Einschätzung seiner Geschwindigkeit herangezogen werden.
Für die lokale Ausführung quantisierter GGUF-Modelle kann llama.cpp mit einem kompatiblen CUDA-Backend verwendet werden. Bei der häufigen Verarbeitung großer Dokumente oder beim gleichzeitigen Betrieb für mehrere Benutzer treten die Einschränkungen der P40 deutlicher hervor.
Einbau in einen gewöhnlichen Computer
Die Tesla P40 ist für Server mit Zwangsbelüftung ausgelegt. Die Karte besitzt keinen eigenen Lüfter, und ihre maximale Leistungsaufnahme beträgt bis zu 250 W.
Beim Einbau müssen folgende Punkte berücksichtigt werden:
- Kühlung. Erforderlich ist ein gerichteter Luftstrom durch den Kühlkörper, üblicherweise mit einem separaten Lüfter und einer Luftführung.
- Stromversorgung. Verwendet wird ein Server-CPU/EPS-8-Pin-Anschluss. Ein gewöhnliches PCIe-8-Pin-Kabel darf nicht direkt an seiner Stelle angeschlossen werden.
- Videoausgänge. HDMI und DisplayPort fehlen. Der Monitor muss an einen anderen Grafikadapter angeschlossen werden.
- Abmessungen. Die Platine ist etwa 267 mm lang und belegt zwei Steckplätze.
Eine weitere Einschränkung betrifft die Softwareunterstützung. Die Tesla P40 besitzt Compute Capability 6.1. Mit dem CUDA Toolkit 13.0 hat NVIDIA die Unterstützung für die Kompilierung von Anwendungen für Pascal eingestellt.
Für die Erstellung von Programmen für diese Architektur ist das CUDA Toolkit 12.9 oder eine frühere kompatible Version erforderlich. Der letzte NVIDIA-Treiberzweig mit Pascal-Unterstützung ist R580; seine Wartung ist bis Juni 2028 vorgesehen.
Das bedeutet nicht, dass die P40 nach diesem Zeitpunkt nicht mehr funktionieren wird. Neue Versionen von Rechenbibliotheken können jedoch modernere GPUs voraussetzen. Daher muss die Softwarekompatibilität jeweils separat geprüft werden.
Lohnt sich die Tesla P40 im Jahr 2026?
Die Tesla P40 bleibt dank ihrer 24 GB Speicher praktisch nutzbar. Sie ermöglicht die Ausführung quantisierter LLMs, die nicht auf eine RTX 3060 mit 12 GB oder eine Tesla P100 mit 16 GB passen. Beide Karten können bei Aufgaben, die keinen großen Videospeicher benötigen, jedoch schneller sein.
Eine RTX 3090 mit ebenfalls 24 GB übertrifft die P40 bei der Generierung und Verarbeitung von Prompts deutlich. Auch die Tesla V100 ist wesentlich schneller, aber die 16-GB-Version schränkt die Auswahl großer Modelle ein, während die 32-GB-Variante dieses Problem löst.
Bei der Wahl einer P40 müssen nicht nur die Kosten der Karte selbst berücksichtigt werden. Eine zusätzliche Kühlung, eine geeignete Stromversorgung, eine Leistungsaufnahme von bis zu 250 W und die Notwendigkeit, einen kompatiblen Software-Stack einzusetzen, erhöhen die Betriebskosten.
Die Tesla P40 ist sinnvoll, wenn für lokale LLMs genau 24 GB Speicher benötigt werden, hohe Geschwindigkeit nicht entscheidend ist und die Kosten eines fertigen Systems deutlich unter denen der Alternativen liegen. Für eine neue Workstation, die langfristig genutzt werden soll, ist eine modernere GPU vorzuziehen.
GPU-Vergleich
Tesla P40 mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
Verwandte GPU-Vergleiche


In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/de/gpu/nvidia-tesla-p40" target="_blank">NVIDIA Tesla P40</a>