NVIDIA Tesla V100 PCIe 16 GB

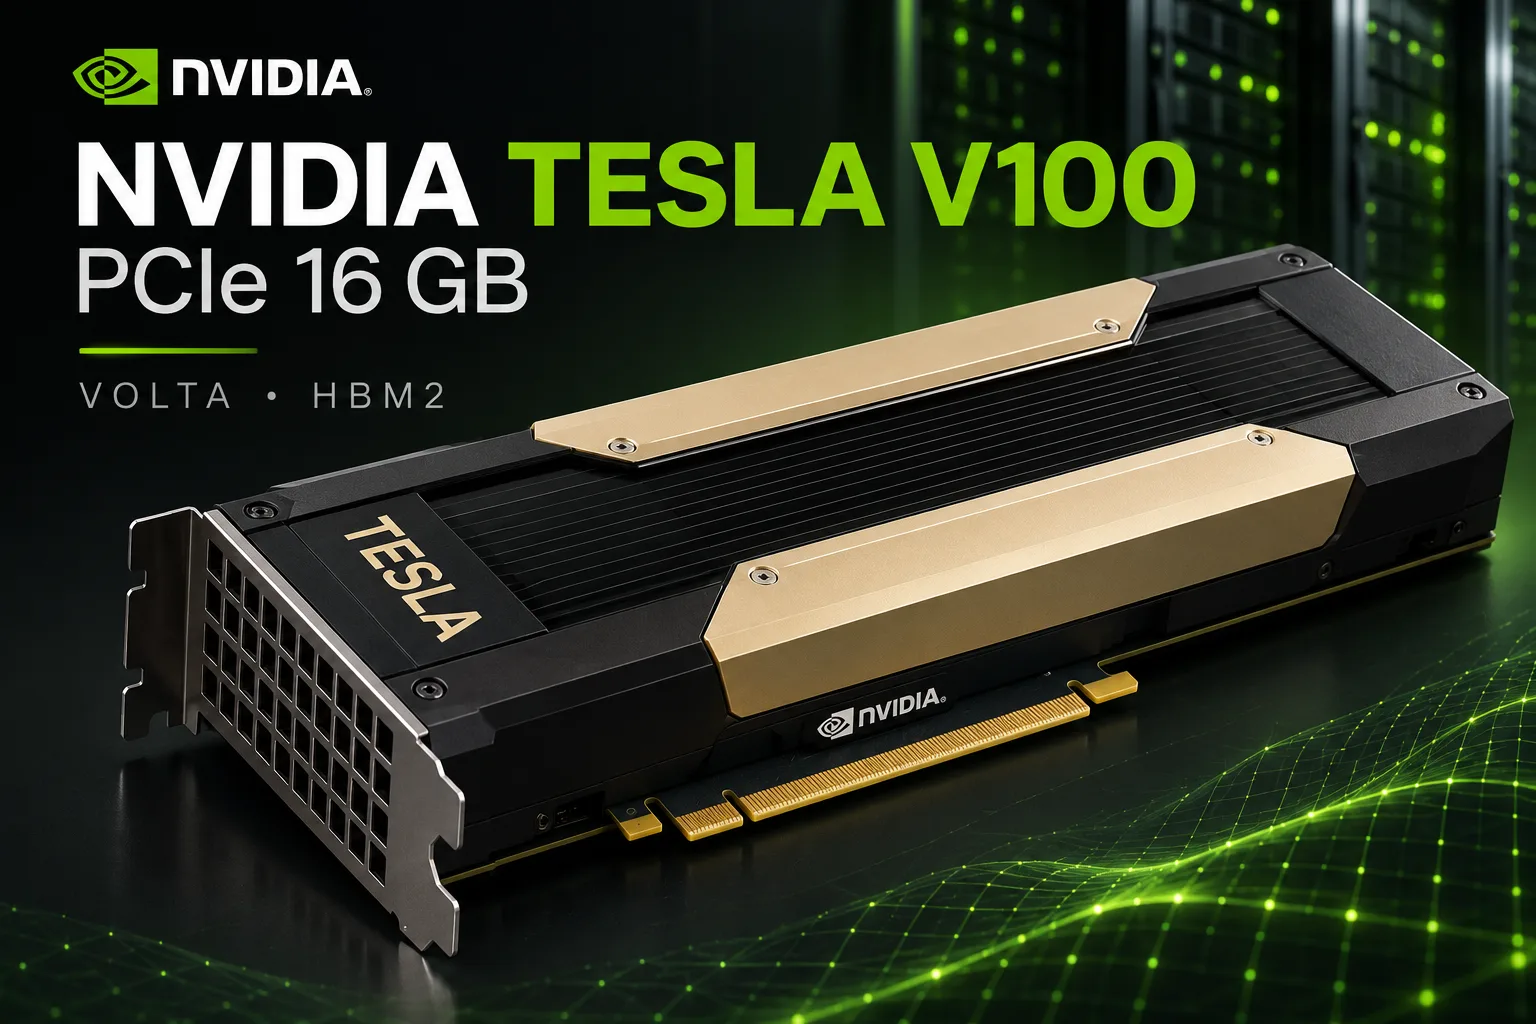
Tesla V100 PCIe 16 GB: 900 GB/s de HBM2 por pouco dinheiro, mas com suporte limitado a CUDA
A Tesla V100 PCIe 16 GB é um acelerador para servidores de 2017 que continua interessante para redes neurais locais e cálculos científicos. Seu principal destaque é a memória HBM2, com largura de banda de 900 GB/s, quase no mesmo nível da GeForce RTX 3090. No mercado de usados, a placa custa algumas centenas de dólares, embora as ofertas mais baratas frequentemente sejam módulos SXM2, e não placas PCIe completas.
Por um preço baixo, é preciso aceitar algumas limitações. A V100 não tem saídas de vídeo nem ray tracing por hardware, seus 16 GB de memória são insuficientes para modelos de linguagem grandes e o suporte às versões mais recentes do CUDA chegou ao fim. A NVIDIA manteve a Volta na ramificação de drivers R580, cujo suporte continuará até meados de 2028. Para executar LLMs modernos, cada vez mais é necessário escolher manualmente versões compatíveis dos programas.
Posição na linha
A Tesla V100 é baseada no chip GV100, com área de 815 mm², fabricado no processo de 12 nm da TSMC FFN. Dos 84 multiprocessadores de streaming, 80 estão ativos, resultando em 5120 núcleos CUDA e 640 núcleos tensores de primeira geração. Quatro stacks de HBM2 são conectados por um barramento de 4096 bits.
Com base no GV100, a NVIDIA lançou vários aceleradores com diferentes quantidades de memória, frequências e interfaces.
| Modelo | Memória | Largura de banda | Boost | TDP | Características |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16, sem NVLink |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | Dobro de memória |
| Tesla V100 SXM2 16/32 GB | 16/32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, suporte a NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | HBM2 mais rápida |
| Titan V | 12 GB HBM2 | 653 GB/s | 1455 MHz | 250 W | Saídas de vídeo, barramento de 3072 bits |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | Gráficos profissionais |
A versão PCIe de 16 GB alcança até 14 TFLOPS em FP32, 7 TFLOPS em FP64 e 112 TFLOPS em cálculos tensoriais FP16. Esses números são um pouco inferiores aos da SXM2, que tem frequência mais alta e limite de potência maior.
A Volta foi a primeira arquitetura da NVIDIA a receber núcleos tensores. No entanto, eles suportam apenas FP16 e não trabalham com BF16, TF32 e FP8. A ausência desses formatos limita a eficiência de bibliotecas e modelos modernos. O GV100 também não possui núcleos RT por hardware.
Desempenho
Modelos de linguagem locais
Durante a geração de tokens, o desempenho costuma ser limitado pela velocidade de leitura dos pesos na memória de vídeo. Por isso, a V100, com seus 900 GB/s, continua competitiva mesmo diante de GPUs muito mais novas.
Para comparação, pode ser usada a tabela de resultados do Llama 2 7B em quantização Q4_0 publicada pelos desenvolvedores do llama.cpp. Ela mede a velocidade de processamento de um prompt de 512 tokens e a geração de 128 tokens sem FlashAttention.
| Placa de vídeo | Memória | Processamento do prompt, tokens/s | Geração, tokens/s |
|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1007 | 55 |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 3043 | 129 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5175 | 158 |
| GeForce RTX 4090 | 24 GB GDDR6X | 11 993 | 186 |
| GeForce RTX 5090 | 32 GB GDDR7 | 14 073 | 290 |
Os resultados foram reunidos a partir de testes realizados por usuários diferentes. O modelo e os principais parâmetros são iguais, mas as versões do llama.cpp, os drivers e as configurações dos sistemas podem variar.
A V100 PCIe 32 GB foi usada no teste da tabela. A versão de 16 GB tem as mesmas frequências e a mesma largura de banda da HBM2, e o próprio modelo ocupa menos de 4 GB. Portanto, espera-se um desempenho próximo, embora não haja aqui uma medição direta da placa de 16 GB.
Na geração, a V100 fica aproximadamente 18% atrás da RTX 3090; no processamento do prompt, a diferença é de 41%. Em um diálogo curto, essa diferença nem sempre é significativa, mas se torna mais perceptível ao processar documentos grandes e históricos longos de conversa.
A RTX 4090 processa o prompt quase quatro vezes mais rápido que a V100, embora sua vantagem na geração seja de apenas 44%. Isso mostra por que a largura de banda da memória, por si só, não determina o desempenho em todas as tarefas.
A principal limitação da V100 PCIe 16 GB é a quantidade de memória. A placa é adequada para modelos de 7 a 14 bilhões de parâmetros em quantização de 4 bits. Modelos com 27 a 32 bilhões de parâmetros normalmente exigem o descarregamento parcial para a memória RAM ou uma compressão mais agressiva. Em ambos os casos, é preciso fazer concessões em velocidade, qualidade ou comprimento do contexto.
Treinamento e cálculos científicos
A V100 foi criada principalmente para o treinamento de redes neurais e a computação de alto desempenho. Seus núcleos tensores FP16 continuam úteis, mas os aceleradores mais novos receberam formatos de computação mais eficientes, caches maiores e bibliotecas otimizadas.
As limitações são especialmente perceptíveis no treinamento de modelos que usam BF16. A V100 não oferece suporte de hardware a esse formato, portanto nem todas as configurações atuais do PyTorch e de outros frameworks podem ser transferidas para a Volta sem alterações.
Por outro lado, em cálculos de precisão dupla, a placa mantém uma vantagem significativa sobre as GeForce para jogos. Seu desempenho chega a 7 TFLOPS em FP64, aproximadamente 5,4 vezes mais que o da RTX 4090.
Para dinâmica molecular, modelagem numérica e outras tarefas de HPC, a V100 continua interessante, desde que o software utilizado ofereça suporte à Volta. No entanto, a alta taxa nominal de FP64, por si só, não garante a mesma vantagem em um programa específico.
É possível jogar na Tesla V100?
A V100 PCIe não tem saídas de vídeo. Para exibir a imagem, será necessária outra placa de vídeo ou os gráficos integrados do processador. No Windows, também é preciso escolher um driver compatível e configurar a execução dos jogos no acelerador de computação.
Entusiastas verificaram as capacidades para jogos da V100 SXM2 16 GB usando um adaptador PCIe. Em um sistema com Ryzen 7 5700GE, a placa apresentou os seguintes resultados em configurações altas, sem upscaling nem geração de quadros.
| Jogo | 2560×1080, FPS médio | 3440×1440, FPS médio |
|---|---|---|
| Cyberpunk 2077 | ~78 | ~56 |
| Hogwarts Legacy | ~55-60 | ~40 |
| Atomic Heart | ~115 | ~75-80 |
| Red Dead Redemption 2 | ~80 | ~65 |
No Cyberpunk 2077, o consumo de energia do acelerador ficou em aproximadamente 181 W. Os resultados mostram que a Volta ainda é capaz de lidar com jogos modernos, embora a ausência de DLSS e de ray tracing por hardware limite significativamente suas possibilidades.
É importante destacar que esses são testes da SXM2, não da PCIe. A frequência Boost da SXM2 chega a 1530 MHz, contra 1380 MHz na PCIe, e seu limite de potência é 50 W maior. Portanto, a versão PCIe pode ser mais lenta. Não é possível determinar a diferença de FPS sem medições específicas.
Comprar uma V100 especificamente para jogos não é vantajoso. Uma GeForce comum é mais fácil de instalar, oferece suporte a tecnologias gráficas modernas e não exige uma placa de vídeo adicional para exibir a imagem.
Instalação em um computador comum
Diferentemente da SXM2, a Tesla V100 PCIe é conectada diretamente a um slot PCIe x16 padrão. Ainda assim, instalar a placa em um PC doméstico exige preparação.
Alimentação. A V100 PCIe de referência possui um conector EPS12V de 8 pinos para CPU. Ele é diferente do conector PCIe comum de 8 pinos. A NVIDIA permite conectar um cabo EPS12V adequado ou usar um adaptador específico com conectores PCIe.
Antes da primeira inicialização, é necessário verificar a pinagem e a carga máxima suportada pelos cabos. Não se deve conectar um cabo inadequado apenas porque o conector parece semelhante.
Refrigeração. A placa vem equipada com um dissipador passivo projetado para um fluxo de ar intenso dentro de um servidor. Em um gabinete comum, será necessária uma ventoinha separada com fluxo de ar direcionado.
Sem refrigeração suficiente, o acelerador pode reduzir suas frequências ou superaquecer. É preciso verificar não apenas a temperatura do chip, mas também a estabilidade durante uma carga prolongada.
Consumo. O limite nominal é de 250 W. Por meio do nvidia-smi, é possível reduzir o limite de potência, por exemplo, para 180 W. Isso diminui o aquecimento e as exigências de refrigeração, mas o impacto no desempenho depende da tarefa.
Suporte de software: a principal limitação
A NVIDIA confirmou que a R580 será a última ramificação de drivers com suporte a Maxwell, Pascal e Volta. Para aceleradores de servidores, ela faz parte da linha de suporte de longo prazo, com manutenção até junho de 2028.
O CUDA 13 não permite mais compilar aplicações para a arquitetura Volta com capacidade de computação sm_70. A última linha compatível do CUDA Toolkit é a 12.x, incluindo a versão 12.9.
Isso não significa que a V100 tenha deixado de funcionar após o lançamento do CUDA 13. Programas compilados com suporte à Volta em versões anteriores do CUDA continuam sendo executados com drivers compatíveis.
O problema está nas versões novas de programas e bibliotecas:
- llama.cpp. O código-fonte permite compilar versões compatíveis com sm_70, mas novas otimizações podem não oferecer suporte à Volta.
- PyTorch. Para a V100, é necessário escolher builds com suporte ao CUDA 12.x e às arquiteturas de computação correspondentes.
- LM Studio e Ollama. A compatibilidade depende da versão do aplicativo e do CUDA Runtime fornecido. Algumas funções podem exigir builds mais antigos.
- FlashAttention 2. A implementação CUDA comum foi projetada para arquiteturas mais novas, portanto a V100 precisa usar mecanismos alternativos de processamento de atenção.
Para experimentos domésticos, isso é aceitável: é possível manter um ambiente compatível e atualizá-lo seletivamente. Para um servidor de produção, as limitações são mais sérias, pois as novas versões dos frameworks deixam gradualmente de oferecer suporte à Volta.
Preços no mercado de usados
O preço da V100 varia bastante conforme a versão. Módulos SXM2 baratos frequentemente aparecem nos resultados gerais de busca por Tesla V100, embora não possam ser instalados em um PC sem um adaptador.
De acordo com o levantamento de ofertas do eBay em 28 de outubro de 2026, a situação é a seguinte:
| Placa de vídeo | Faixa inferior das ofertas | Mediana dos anúncios |
|---|---|---|
| Tesla V100 PCIe 16 GB, versão passiva | $329 | $422 |
| Tesla V100 SXM2 16 GB | $191 | $300 |
| Tesla V100 SXM2 32 GB | $842 | $990 |
| Tesla V100 PCIe 32 GB, versão passiva | $860 | $960 |
| GeForce RTX 3090 24 GB | $1651 | $1970 |
Os preços correspondem a anúncios ativos, não a transações concluídas. Algumas unidades da V100 PCIe 16 GB foram vendidas por aproximadamente $240-275, mas não se pode considerar que essas ofertas estejam garantidamente disponíveis.
Para a versão PCIe de 16 GB, é razoável considerar um preço de $300-350 por uma placa em bom estado cuja operação possa ser verificada. Por cerca de $400, a compra se torna menos atraente, especialmente se também forem necessários refrigeração e cabo de alimentação.
O custo de um sistema doméstico completo pode ficar significativamente acima do preço do próprio acelerador. Portanto, a V100 só deve ser comparada com alternativas depois de considerar todos os componentes.
Concorrentes e alternativas
Tesla V100 SXM2 16 GB. O módulo em si é mais barato que a versão PCIe, mas exige adaptador, alimentação e refrigeração separada. O custo total pode acabar sendo semelhante ao de uma placa PCIe pronta. Para uma única GPU, a vantagem da SXM2 normalmente não compensa a montagem complexa. A situação é diferente no caso de placas com vários módulos e NVLink.
Tesla V100 PCIe 32 GB. Tem a mesma arquitetura de computação e a mesma largura de banda de memória, mas oferece o dobro de HBM2. É significativamente mais adequada para modelos de linguagem com 27 a 32 bilhões de parâmetros. No entanto, com preços de $800-1000, a vantagem econômica de uma arquitetura antiga já não é tão evidente.
GeForce RTX 3090 24 GB. É mais rápida no processamento de prompts, oferece suporte a BF16, otimizações CUDA modernas e ray tracing por hardware. Seus 24 GB permitem trabalhar com modelos maiores do que os suportados pela V100 16 GB. No mercado de usados, há anúncios a partir de aproximadamente $1200, embora a maioria das ofertas seja mais cara. É uma placa mais versátil, mas o custo adicional é significativo.
GeForce RTX 5060 Ti 16 GB. Oferece arquitetura nova, suporte às bibliotecas atuais, saídas de vídeo, DLSS 4 e garantia do fabricante. Sua largura de banda de memória é menor: 448 GB/s contra 900 GB/s da V100. No entanto, não é possível prever diretamente a velocidade de LLM com base nessa diferença: os núcleos de computação modernos e as otimizações de software podem compensar a menor largura de banda. Para jogos e uso cotidiano, a RTX 5060 Ti é preferível.
AMD Instinct MI50 32 GB. É uma alternativa com o dobro de HBM2, largura de banda de aproximadamente 1 TB/s e alto desempenho em FP64. Os preços de alguns anúncios começam em cerca de $650. A principal limitação é o suporte ao ROCm, que está ficando obsoleto, além das dificuldades com softwares de computação modernos. Para programas projetados para CUDA, a V100 normalmente é mais fácil de usar.
Tesla P40 24 GB. É uma placa mais antiga, com GDDR5 e 24 GB de memória. No teste do llama.cpp, ela gera aproximadamente 55 tokens/s, contra 129 tokens/s da V100. No entanto, seus 8 GB adicionais permitem executar modelos que não cabem nos 16 GB da V100. Por isso, a P40 continua sendo uma alternativa quando a quantidade de memória é mais importante que a velocidade.
Vale a pena comprar a Tesla V100 PCIe 16 GB?
A Tesla V100 PCIe 16 GB continua atraente para redes neurais locais, cálculos científicos e experimentos com CUDA. Por algumas centenas de dólares, o comprador obtém 900 GB/s de largura de banda de memória, 640 núcleos tensores e 7 TFLOPS em FP64.
No entanto, 16 GB limitam a escolha de modelos de linguagem, e o suporte de software à Volta está diminuindo gradualmente. A placa exige refrigeração direcionada, alimentação adequada e atenção na escolha das versões de drivers e bibliotecas.
Por até $300-350, a V100 PCIe 16 GB pode ser considerada uma boa compra para um sistema doméstico de computação. Se a placa custar $400 ou mais, é preciso compará-la com a SXM2 16 GB, a P40 24 GB e aceleradores mais modernos, levando em conta os custos de instalação.
Para modelos de até 14 bilhões de parâmetros, as capacidades da V100 normalmente são suficientes. Se o objetivo for executar localmente modelos de 27 a 32 bilhões de parâmetros sem descarregamento para a memória RAM, é melhor considerar desde o início uma placa de vídeo com 24-32 GB de memória.
A V100 deve ser comprada por causa de tarefas de computação específicas, não como uma placa de vídeo universal. Seu desempenho ainda é suficiente para muitos experimentos, mas já não é possível contar com suporte completo a softwares novos nos próximos anos.
Comparação de GPU
Comparar Tesla V100 PCIe 16 GB com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Comparações de GPU relacionadas


Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/pt/gpu/nvidia-tesla-v100-pcie-16-gb" target="_blank">NVIDIA Tesla V100 PCIe 16 GB</a>