NVIDIA Tesla P100 PCIe 12 GB

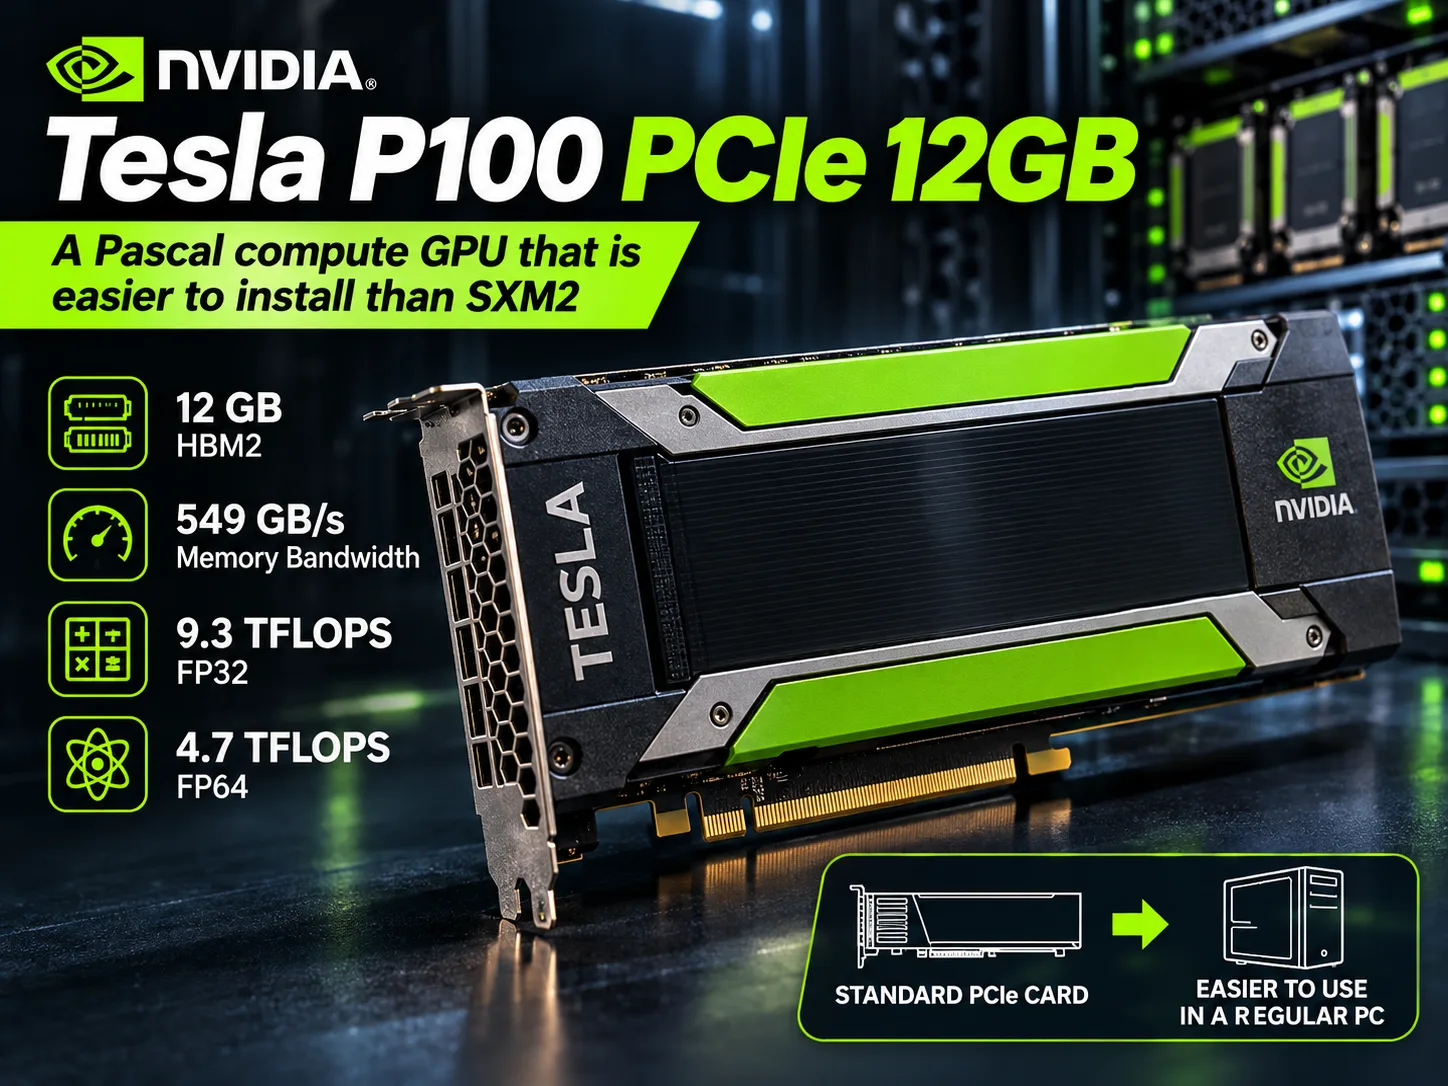
Tesla P100 PCIe 12 GB: FP64-Rechner für 80 $ mit Abschaltdatum
Die Tesla P100 war der erste NVIDIA-Beschleuniger auf Pascal-Basis und in den Jahren 2016-2017 eine der wichtigsten Karten für Supercomputer und das Training neuronaler Netze. Damals kostete die 12-GB-Version für PCIe rund 4.600 $. Heute stammen die Karten aus ausgemusterten Servern und werden bei eBay für 70-140 $ verkauft - günstiger als eine Budget-Gaming-Grafikkarte.
Gekauft wird sie wegen der doppelten Genauigkeit und des HBM2-Speichers. Bei FP64 erreicht die Karte 4,7 TFLOPS und damit mehr als eine RTX 4090. Bei der Speicherausstattung sieht es bei der kleineren Version schlechter aus: Einer von vier HBM2-Stacks ist deaktiviert, weshalb Kapazität und Speicherbandbreite um ein Viertel niedriger sind als bei der P100 16 GB. Die gesamte Softwareunterstützung für Pascal endet mit dem Treiberzweig R580 Mitte 2028.
Einordnung und Architektur
Alle Tesla-P100-Karten basieren auf GP100, einem 16-nm-Chip mit einer Fläche von 610 mm², der zusammen mit vier HBM2-Stacks auf einem CoWoS-Substrat sitzt. Von den 3840 CUDA-Kernen des vollständigen Chips sind bei der P100 3584 aktiv. Die PCIe-Version arbeitet mit 1190-1329 MHz bei einer TDP von 250 W.
Die 12-GB-Version ist dieselbe Platine mit einem deaktivierten Speicher-Stack. Chip und Taktraten wurden nicht verändert, daher ist die Rechenleistung identisch mit der des größeren Modells.
| Modell | Speicher | Bus | Speicherbandbreite | FP64 | FP16 | TDP |
|---|---|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 GB HBM2 | 3072 Bit | 549 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 4096 Bit | 732 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 SXM2 | 16 GB HBM2 | 4096 Bit | 732 GB/s | 5,3 TFLOPS | 21,2 TFLOPS | 300 W |
| Tesla P40 | 24 GB GDDR5 | 384 Bit | 347 GB/s | 1/32 von FP32 | 1/64 von FP32 | 250 W |
Der GP100-Chip kam in keiner GeForce zum Einsatz. Sein engster Verwandter für Workstations ist die Quadro GP100 mit Videoausgängen. GTX 1080 Ti und Tesla P40 basieren auf einem anderen Chip, dem GP102. Der GP100 berechnet FP64 mit halber FP32-Geschwindigkeit und FP16 mit doppelter Geschwindigkeit; beim GP102 sind beide Modi fast vollständig beschnitten. Dafür besitzt der GP100 (Compute Capability 6.0) keine DP4A-Instruktionen für ganzzahlige Skalarprodukte, die beim GP102 vorhanden sind. Für quantisierte neuronale Netze erwies sich das als wichtiger, als es 2016 schien.
Tensor Cores besitzt die P100 nicht. Sie kamen erst 2017 mit der Tesla V100 und der Volta-Architektur.
Leistung
Für Spiele ist die Karte ungeeignet. Sie hat keine Videoausgänge, und Enthusiasten, die das Bild über eine zweite Grafikkarte ausgaben, berichten von Problemen mit den Datacenter-Treibern und raten von der P100 für Spiele ab. Sinnvoll eingesetzt werden kann sie noch bei lokalen Sprachmodellen und Berechnungen mit doppelter Genauigkeit.
Zusammenfassung der llama.cpp-Community für CUDA (Llama 2 7B, Q4_0, ohne Flash Attention):
| Beschleuniger | Speicher | Prompt-Verarbeitung, tok/s | Generierung, tok/s |
|---|---|---|---|
| RTX 3090 | 24 GB GDDR6X | 5174 | 158 |
| Tesla V100 | 32 GB HBM2 | 3043 | 129 |
| RTX 2080 Ti | 11 GB GDDR6 | 2890 | 107 |
| GTX 1080 Ti | 11 GB GDDR5X | 1084 | 62 |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 761 | 58,4 |
| Tesla P40 | 24 GB GDDR5 | 1007 | 54,7 |
| Tesla T4 | 16 GB GDDR6 | 1219 | 46,4 |
Bei der Generierung liegt die P100 auf dem Niveau der GTX 1080 Ti und der P40. Prompts verarbeitet sie 3,8-mal langsamer als die RTX 2080 Ti und auch langsamer als die P40. Bei kurzen Anfragen im Chat ist das noch akzeptabel, bei langen Dokumenten „liest“ das Modell den Text vor der Antwort jedoch spürbar lange ein.
Ein Test von ComputingForGeeks mit einer aktuellen llama.cpp-Version zeigte im Oktober 2026 dasselbe. Bei Qwen3 8B in Q4_K_M erreichte die P100 16 GB 38,4 tok/s gegenüber 47 bei der P40, obwohl der Speicher der P100 doppelt so schnell ist. Der Grund ist das Fehlen von DP4A: Mit Compute Capability 6.0 verwenden die quantisierten llama.cpp-Kernels den langsamen Pfad.
Deshalb spielt der beschnittene Speicherbus der 12-GB-Version bei Sprachmodellen kaum eine Rolle. Im Test mit Llama 2 7B erreicht die P100 16 GB etwa 220 GB/s - weniger als ein Drittel ihrer maximalen Speicherbandbreite. Sie ist also durch die Rechenleistung begrenzt. Separate Messungen der kleineren Version in llama.cpp gibt es nicht, aber bei kleinen Modellen dürfte ihre Generierungsgeschwindigkeit nahe an der 16-GB-Version liegen. Das Problem der 12-GB-Version ist die Kapazität: gpt-oss-20b und dichte Modelle über 14B passen nicht hinein.
Bei FP64 ist die Situation umgekehrt. Eine RTX 4090 erreicht bei doppelter Genauigkeit etwa 1,3 TFLOPS, bei der RTX 3090 ist es zehnmal weniger als bei der P100. Bei FP64 kommen nur Serverkarten der nächsten Generation näher heran: die V100 PCIe mit 7 TFLOPS und die AMD Instinct MI50 mit 6,6 TFLOPS. Bei Berechnungen, die bei FP64 an der Speicherbandbreite hängen, etwa bei Gitterverfahren und in der Hydrodynamik, verliert die 12-GB-Version gegenüber dem größeren Modell bis zu 25 %.
Ergebnisse in konkreten Systemen
Veröffentlichte Tests speziell der 12-GB-Version gibt es kaum, deshalb enthält die Tabelle auch Ergebnisse des 16-GB-Modells mit demselben Chip.
| System | Konfiguration | P100-Version | Test | Ergebnis |
|---|---|---|---|---|
| Uniwide RB228H | 2× Xeon E5-2699 v4 | PCIe 12 GB | SPEC ACCEL OpenCL, base | 5,15 |
| Hosting-Server von Database Mart | 2× Xeon E5-2660 v2, 128 GB DDR3 | PCIe 16 GB | Ollama, Llama 2 7B | 49,7 tok/s |
| Gemieteter Knoten bei vast.ai | k. A. | PCIe 16 GB | llama.cpp, Qwen3 8B Q4_K_M | 38,4 tok/s |
Der Unterschied zwischen 49,7 und 38,4 tok/s wird durch Modell und Quantisierung verursacht, nicht durch den Server. Wenn das Modell vollständig in den Grafikspeicher passt, hat der Prozessor kaum Einfluss auf die Generierungsgeschwindigkeit. Selbst eine Plattform mit einem Xeon E5 v2 aus dem Jahr 2013 bremst die Karte nicht aus.
Im Leerlauf benötigt die P100 28 W, die P40 11 W. Unter LLM-Last steigt der Spitzenverbrauch der P100 auf bis zu 211 W.
Wo sie zu finden ist, Preise und Verfügbarkeit
Neue Geräte mit P100 werden nicht mehr verkauft. Zu ihrer Zeit wurde die Karte als Option in Servern wie Dell PowerEdge R730, R740, C4130 und C4140, Cisco UCS C240 M5 und C220 M5SX sowie HPE ProLiant angeboten. Von dort gelangen die Karten auf den Gebrauchtmarkt, meist ohne Kabel.
| Variante | Zustand | Preis |
|---|---|---|
| Tesla P100 PCIe 12 GB | gebraucht, Großserienangebote | $70-100 |
| Tesla P100 PCIe 12 GB | gebraucht, geprüft und mit Rückgaberecht | $110-165 |
| Tesla P100 PCIe 16 GB | gebraucht, Angebote aus China | $118-130 |
| Tesla P100 PCIe 16 GB | generalüberholt, Amazon | etwa $155 |
Für den Einbau in einen gewöhnlichen PC müssen einige Komponenten zusätzlich gekauft werden:
| Was benötigt wird | Zweck | Preis |
|---|---|---|
| Abdeckung und Radiallüfter | passive Kühlung | ab $20 plus Lüfter |
| Adapter auf 8-Pin-EPS | Prozessoranschluss, nicht PCIe | etwa $13 |
| Integrierte Grafik oder zweite Grafikkarte | keine Videoausgänge vorhanden | - |
Im BIOS muss die Option Above 4G Decoding aktiviert sein. Eine P100 lässt sich nicht zusammen mit einer Blackwell-Karte in einem System betreiben: Dafür werden unterschiedliche NVIDIA-Kernelmodule benötigt. Eine betriebsbereite P100 12 GB kostet damit letztlich $110-150.
Konkurrenten und Alternativen
Tesla P100 PCIe 16 GB (etwa $130-155). Der Chip ist derselbe, aber es stehen 4 GB mehr Speicher und ein Drittel mehr Speicherbandbreite zur Verfügung. Ein Aufpreis von $40-60 ermöglicht gpt-oss-20b, 14B-Modelle mit normalem Kontext und die volle Geschwindigkeit bei speicherbegrenzten Aufgaben. Die kleinere Version bleibt nur für FP64-Berechnungen günstiger, bei denen die Kapazität keine Rolle spielt: Sie rechnet genauso schnell und kostet weniger.
Tesla P40 24 GB (etwa $300-350). Sie besitzt doppelt so viel Speicher und DP4A; 32B-Modelle in Q4 passen vollständig hinein und werden mit etwa 12 tok/s generiert. FP16 und FP64 sind praktisch nicht vorhanden, daher eignet sich die P40 nicht für Berechnungen. Für Modelle über 14B ist sie nützlicher als jede P100.
Tesla V100 PCIe 16 GB (etwa $365). Sie besitzt Tensor Cores, verarbeitet Prompts 3-4-mal schneller und erreicht bei FP64 7 TFLOPS. Die Unterstützung endet ebenso wie bei Pascal. Für dreimal so viel Geld erhält man eine spürbar schnellere Karte mit derselben Lebensdauer.
GeForce RTX 3060 12 GB (etwa $300-320 gebraucht). Sie besitzt genauso viel Speicher, unterstützt aber aktuelle CUDA-Versionen, vLLM und künftige PyTorch-Versionen. Außerdem bietet sie Videoausgänge, eine normale Kühlung und einen Verbrauch von 170 W. Tensor Cores beschleunigen die Prompt-Verarbeitung deutlich. Die Leistung bei doppelter Genauigkeit ist symbolisch. Wenn eine gewöhnliche Grafikkarte mit Software benötigt wird, die noch mehrere Jahre unterstützt wird, ist die RTX 3060 trotz des dreimal höheren Preises die bessere Wahl.
Fazit
Bei Sprachmodellen generiert die P100 12 GB Text auf dem Niveau einer GTX 1080 Ti, verarbeitet Prompts aber 3-4-mal langsamer als eine RTX 2080 Ti. Sie reicht für 7-14B-Modelle mit 4-Bit-Quantisierung sowie für Experimente mit Ollama und llama.cpp auf einem alten Server. Modelle über 14B passen nicht hinein, und lange Prompts werden langsam verarbeitet. vLLM wird nicht unterstützt, PyTorch hat das Ende der fertigen Builds für Pascal angekündigt, und 2028 werden keine Treiber mehr erscheinen. Dazu kommen 250 W Verbrauch und ein lauter Radiallüfter.
Mehr als $80 sollte man für diese Karte nicht bezahlen. Wenn Modelle über 14B benötigt werden, ist die P40 die bessere Wahl; wenn die Software auch nach 2028 noch funktionieren soll, sollte man zur RTX 3060 12 GB greifen.
Für Berechnungen mit doppelter Genauigkeit hat die P100 12 GB für $70-80 kaum Konkurrenz. Für neuronale Netze lohnt sich ein Aufpreis von $50 und der Griff zur 16-GB-Version.
GPU-Vergleich
Tesla P100 PCIe 12 GB mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/de/gpu/nvidia-tesla-p100-pcie-12-gb" target="_blank">NVIDIA Tesla P100 PCIe 12 GB</a>