NVIDIA Tesla P100 PCIe 12 GB

Tesla P100 PCIe 12 GB: FP64-калькулятор за $80 с датой отключения
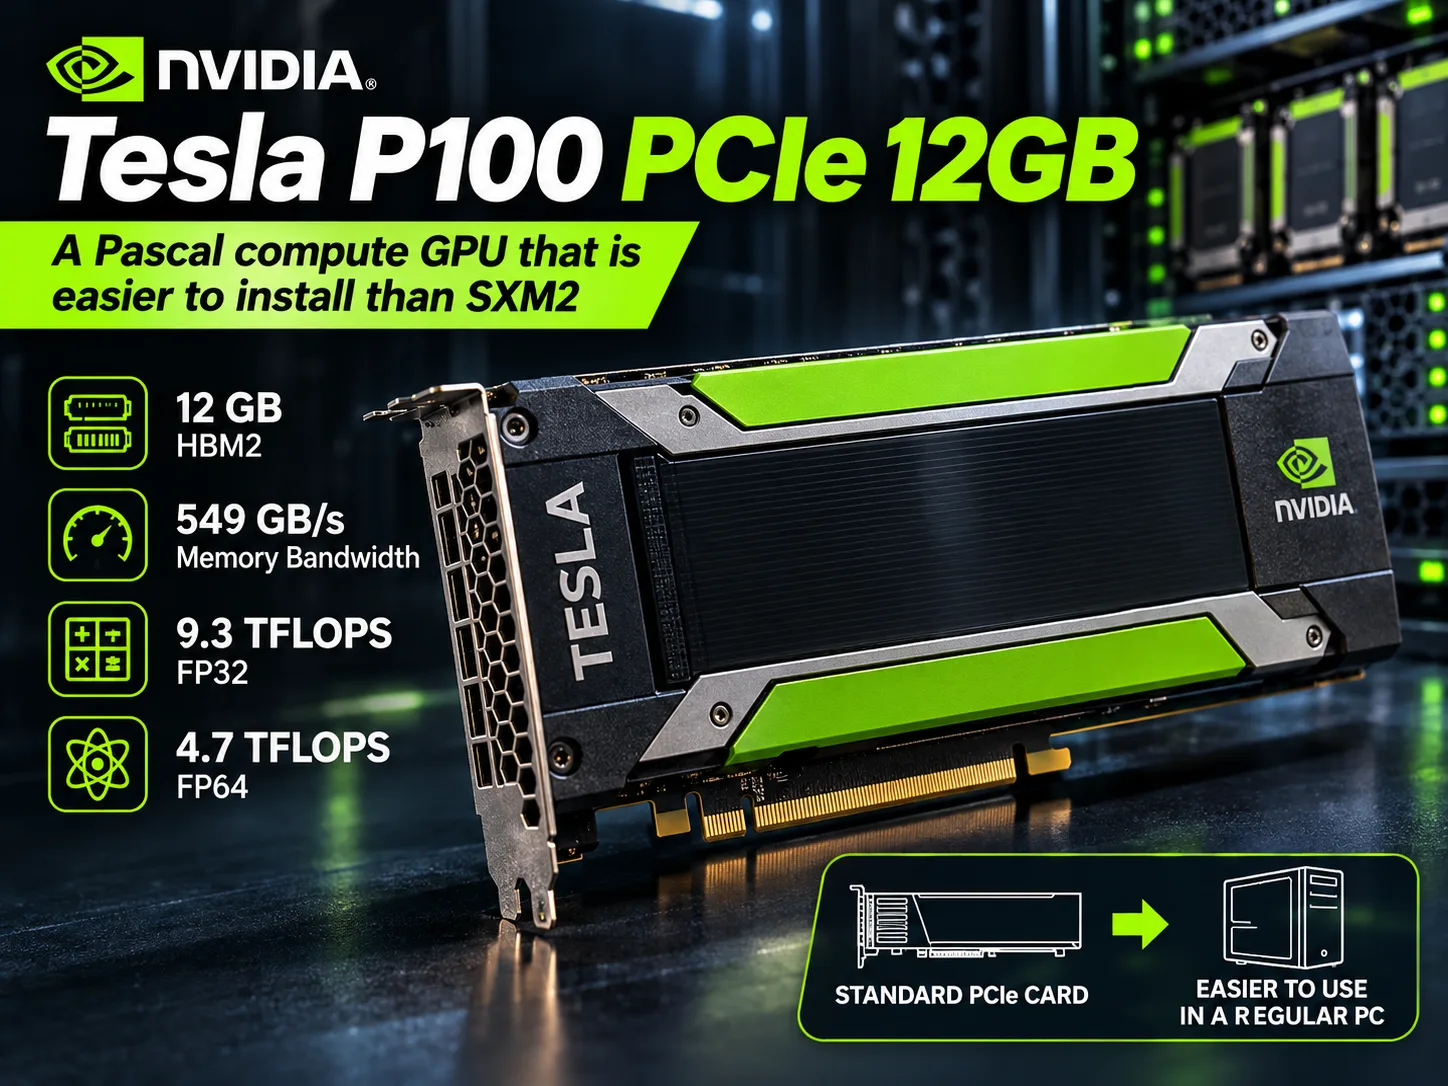
Tesla P100 - первый ускоритель NVIDIA на архитектуре Pascal, в 2016-2017 годах одна из главных карт для суперкомпьютеров и обучения нейросетей. Тогда 12-гигабайтная версия для PCIe стоила около $4600. Сейчас карты уходят из списанных серверов и продаются на eBay за $70-140, дешевле бюджетной игровой видеокарты.
Покупают ее ради двойной точности и памяти HBM2. По FP64 карта выдает 4,7 TFLOPS, больше, чем RTX 4090. С памятью у младшей версии хуже: один из четырех стеков HBM2 отключен, поэтому объем и пропускная способность на четверть ниже, чем у P100 16 GB. Вся программная поддержка Pascal заканчивается вместе с драйверной веткой R580 в середине 2028 года.
Положение в линейке и архитектура
Все Tesla P100 построены на GP100 - 16-нм кристалле площадью 610 мм², который стоит на подложке CoWoS вместе с четырьмя стеками HBM2. Из 3840 CUDA-ядер полного чипа у P100 активно 3584. PCIe-версия работает на 1190-1329 МГц при теплопакете 250 Вт.
Версия на 12 ГБ - та же плата с выключенным стеком памяти. Ядро и частоты у нее не изменились, поэтому вычислительная мощность такая же, как у старшей модели.
| Модель | Память | Шина | ПСП | FP64 | FP16 | TDP |
|---|---|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 ГБ HBM2 | 3072 бит | 549 ГБ/с | 4,7 TFLOPS | 18,7 TFLOPS | 250 Вт |
| Tesla P100 PCIe 16 GB | 16 ГБ HBM2 | 4096 бит | 732 ГБ/с | 4,7 TFLOPS | 18,7 TFLOPS | 250 Вт |
| Tesla P100 SXM2 | 16 ГБ HBM2 | 4096 бит | 732 ГБ/с | 5,3 TFLOPS | 21,2 TFLOPS | 300 Вт |
| Tesla P40 | 24 ГБ GDDR5 | 384 бит | 347 ГБ/с | 1/32 от FP32 | 1/64 от FP32 | 250 Вт |
В GeForce чип GP100 не попал. Его ближайший родственник для рабочих станций - Quadro GP100 с видеовыходами. GTX 1080 Ti и Tesla P40 сделаны на другом кристалле, GP102. GP100 считает FP64 на половине скорости FP32, а FP16 на удвоенной, у GP102 оба режима урезаны почти до нуля. Зато у GP100 (compute capability 6.0) нет инструкций DP4A для целочисленного скалярного произведения, которые есть у GP102. Для квантованных нейросетей это оказалось важнее, чем казалось в 2016 году.
Тензорных ядер у P100 нет. Они появились уже в 2017 году в Tesla V100 на архитектуре Volta.
Производительность
Для игр карта не подходит. Видеовыходов у нее нет, а энтузиасты, которые выводили картинку через вторую видеокарту, жалуются на драйверы для дата-центров и не советуют P100 для игр. Где она еще работает, так это в локальных языковых моделях и расчетах с двойной точностью.
Сводная таблица сообщества llama.cpp для CUDA (Llama 2 7B, Q4_0, без Flash Attention):
| Ускоритель | Память | Обработка промпта, ток/с | Генерация, ток/с |
|---|---|---|---|
| RTX 3090 | 24 ГБ GDDR6X | 5174 | 158 |
| Tesla V100 | 32 ГБ HBM2 | 3043 | 129 |
| RTX 2080 Ti | 11 ГБ GDDR6 | 2890 | 107 |
| GTX 1080 Ti | 11 ГБ GDDR5X | 1084 | 62 |
| Tesla P100 PCIe 16 GB | 16 ГБ HBM2 | 761 | 58,4 |
| Tesla P40 | 24 ГБ GDDR5 | 1007 | 54,7 |
| Tesla T4 | 16 ГБ GDDR6 | 1219 | 46,4 |
Генерирует P100 на уровне GTX 1080 Ti и P40. Промпт она обрабатывает в 3,8 раза медленнее RTX 2080 Ti и медленнее той же P40. С короткими запросами в чате это терпимо, а на длинных документах модель заметно долго «читает» текст перед ответом.
Тест ComputingForGeeks на свежей версии llama.cpp в октябре 2026 года показал то же. На Qwen3 8B в Q4_K_M P100 16 GB выдала 38,4 ток/с против 47 у P40, хотя память у P100 вдвое быстрее. Причина в отсутствии DP4A: на compute capability 6.0 квантованные ядра llama.cpp идут по медленному пути.
Поэтому урезанная шина версии на 12 ГБ в языковых моделях почти не мешает. В тесте Llama 2 7B P100 16 GB прокачивает около 220 ГБ/с, меньше трети своей пиковой ПСП, то есть упирается в вычисления. Отдельных замеров младшей версии в llama.cpp нет, но на небольших моделях ее скорость генерации должна быть близкой к 16-гигабайтной. Проблема 12 ГБ в объеме: gpt-oss-20b и плотные модели крупнее 14B в нее не помещаются.
С FP64 ситуация обратная. У RTX 4090 около 1,3 TFLOPS в двойной точности, у RTX 3090 вдесятеро меньше, чем у P100. Ближе по FP64 только серверные карты следующего поколения: V100 PCIe с 7 TFLOPS и AMD Instinct MI50 с 6,6 TFLOPS. В расчетах, где FP64 упирается в память, например в сеточных методах и гидродинамике, версия на 12 ГБ проиграет старшей вплоть до 25%.
Результаты в конкретных системах
Опубликованных тестов именно версии на 12 ГБ почти нет, поэтому в таблице есть и результаты 16-гигабайтной модели с тем же чипом.
| Система | Конфигурация | Версия P100 | Тест | Результат |
|---|---|---|---|---|
| Uniwide RB228H | 2× Xeon E5-2699 v4 | PCIe 12 GB | SPEC ACCEL OpenCL, base | 5,15 |
| Сервер хостинга Database Mart | 2× Xeon E5-2660 v2, 128 ГБ DDR3 | PCIe 16 GB | Ollama, Llama 2 7B | 49,7 ток/с |
| Арендованный узел vast.ai | н/д | PCIe 16 GB | llama.cpp, Qwen3 8B Q4_K_M | 38,4 ток/с |
Разница между 49,7 и 38,4 ток/с объясняется моделью и квантованием, а не сервером. Если модель целиком помещается в видеопамять, процессор почти не влияет на скорость генерации, и даже платформа на Xeon E5 v2 2013 года не тормозит карту.
Простаивает P100 при 28 Вт, P40 при 11 Вт. Под нагрузкой LLM пиковое потребление P100 доходит до 211 Вт.
Где встречается, цены и доступность
Новых устройств с P100 не продается. В свое время карта ставилась опцией в серверы Dell PowerEdge R730, R740, C4130 и C4140, Cisco UCS C240 M5 и C220 M5SX и в HPE ProLiant. Оттуда она и приходит на вторичный рынок, обычно без кабелей.
| Вариант | Состояние | Цена |
|---|---|---|
| Tesla P100 PCIe 12 GB | б/у, массовые лоты | $70-100 |
| Tesla P100 PCIe 12 GB | б/у, с проверкой и возвратом | $110-165 |
| Tesla P100 PCIe 16 GB | б/у, лоты из Китая | $118-130 |
| Tesla P100 PCIe 16 GB | восстановленная, Amazon | около $155 |
Чтобы поставить карту в обычный ПК, придется кое-что докупить:
| Что нужно | Зачем | Цена |
|---|---|---|
| Кожух и вентилятор-турбина | охлаждение пассивное | от $20 плюс вентилятор |
| Переходник на 8-pin EPS | разъем процессорный, не PCIe | около $13 |
| Встроенная графика или вторая карта | видеовыходов нет | - |
В BIOS должна быть включена опция Above 4G Decoding. Поставить P100 в одну систему с картой на Blackwell не выйдет: им нужны разные модули ядра NVIDIA. Готовая к работе P100 12 GB в итоге обходится в $110-150.
Конкуренты и альтернативы
Tesla P100 PCIe 16 GB (около $130-155). Чип тот же, памяти на 4 ГБ больше, ПСП на треть выше. Доплата $40-60 дает gpt-oss-20b, модели 14B с нормальным контекстом и полную скорость в задачах, которые упираются в память. Младшая версия остается выгоднее только для FP64-расчетов, где объем не важен: считает она так же и стоит дешевле.
Tesla P40 24 GB (около $300-350). Памяти вдвое больше, есть DP4A, модели 32B в Q4 помещаются целиком и генерируют около 12 ток/с. FP16 и FP64 у нее фактически нет, так что для расчетов P40 не подходит. Для моделей крупнее 14B она полезнее любой P100.
Tesla V100 PCIe 16 GB (около $365). Есть тензорные ядра, промпт обрабатывается в 3-4 раза быстрее, FP64 достигает 7 TFLOPS. Поддержка закончится так же, как у Pascal. За втрое большие деньги вы получаете заметно более быструю карту с тем же сроком жизни.
GeForce RTX 3060 12 GB (около $300-320 б/у). Памяти столько же, но работают актуальная CUDA, vLLM и будущие версии PyTorch. Есть видеовыходы и обычное охлаждение, потребление 170 Вт. Тензорные ядра заметно ускоряют обработку промпта. Двойная точность символическая. Если нужна обычная видеокарта со софтом, который будет поддерживаться несколько лет, RTX 3060 выгоднее, хотя и стоит втрое дороже.
Вывод
В языковых моделях P100 12 GB генерирует текст как GTX 1080 Ti, а промпт обрабатывает в 3-4 раза медленнее RTX 2080 Ti. Ее хватает на модели 7-14B в 4-битном квантовании и на эксперименты с Ollama и llama.cpp на старом сервере. Модели крупнее 14B в нее не помещаются, длинные промпты обрабатываются медленно. vLLM не поддерживается, PyTorch объявил о прекращении готовых сборок для Pascal, а драйверы перестанут выходить в 2028 году. К этому добавляются 250 Вт и шумная турбина.
Платить за эту карту больше $80 не стоит. Если нужны модели крупнее 14B, смотрите на P40, если нужен софт, который будет работать после 2028 года, на RTX 3060 12 GB.
Для расчетов с двойной точностью за $70-80 у P100 12 GB почти нет конкурентов. Для нейросетей лучше доплатить $50 и взять версию на 16 ГБ.
Сравнение GPU
Сравнить Tesla P100 PCIe 12 GB с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/ru/gpu/nvidia-tesla-p100-pcie-12-gb" target="_blank">NVIDIA Tesla P100 PCIe 12 GB</a>