NVIDIA CMP 50HX

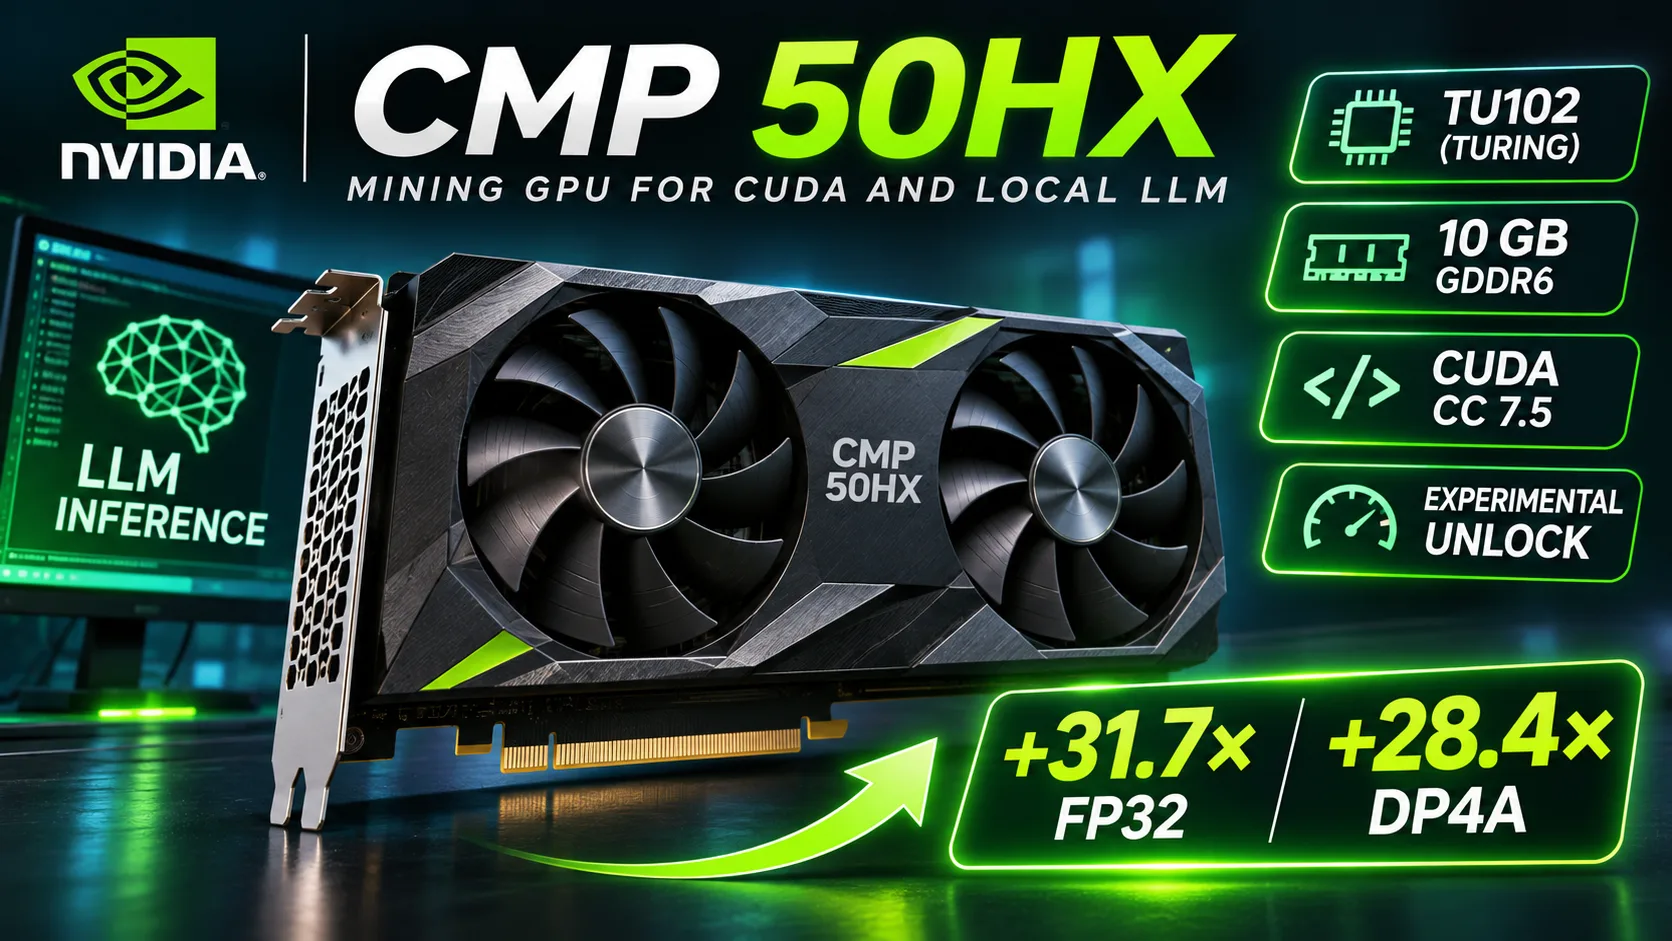
NVIDIA CMP 50HX: 10 GB памяти для CUDA и локальных LLM
NVIDIA CMP 50HX - специализированная видеокарта для майнинга, выпущенная в 2021 году. Она использует графический процессор TU102 архитектуры Turing, родственный GPU из GeForce RTX 2080 Ti. Карта получила 3584 CUDA-ядра и 10 GB памяти GDDR6, но лишена видеовыходов и имеет ограничения вычислительной производительности.
После перехода Ethereum на Proof of Stake CMP 50HX стали использовать для экспериментов с CUDA и локальными нейросетями. В некоторых LLM она обеспечивает около 30 токенов/с, однако скорость зависит от типа вычислений и программной конфигурации. В 2026 году появились экспериментальные способы снятия части ограничений.
Архитектура и характеристики
CMP 50HX основана на 12 nm GPU TU102 с 56 потоковыми мультипроцессорами. По сравнению с RTX 2080 Ti у неё меньше активных вычислительных блоков и более узкая шина памяти.
| Характеристика | CMP 50HX | RTX 2080 Ti |
|---|---|---|
| CUDA-ядер | 3584 | 4352 |
| Потоковых мультипроцессоров | 56 | 68 |
| Память GDDR6 | 10 GB | 11 GB |
| Шина памяти | 320-bit | 352-bit |
| Пропускная способность | 560 GB/s | 616 GB/s |
| Частота Boost | 1545 MHz | 1545 MHz |
| PCIe | 1.0 x4 | 3.0 x16 |
| Энергопотребление | 225 W | 250 W |
| Видеовыходы | Нет | Есть |
Характеристики MSI CMP 50HX MINER и стандартной RTX 2080 Ti.
CMP 50HX работает на частотах 1350-1545 MHz. Память GDDR6 со скоростью 14 Gb/s обеспечивает пропускную способность 560 GB/s. Теоретическая производительность FP32 при частоте Boost составляет около 11.07 TFLOPS.
Однако в стандартной конфигурации доступная вычислительная производительность значительно ниже.
Особенности CMP 50HX:
- Поддержка CUDA Compute Capability 7.5.
- 10 GB GDDR6 для вычислений и хранения моделей.
- Отсутствие HDMI и DisplayPort.
- Ограниченный интерфейс PCIe 1.0 x4.
- Два дополнительных разъёма питания 8-pin.
- Зависимость доступных функций от драйверов.
Версия MSI потребляет 225 W, тогда как эталонная спецификация NVIDIA предусматривает 250 W. Для длительной работы требуется достаточный воздушный поток внутри корпуса.
Производительность FP32, FP16 и INT8
Главная особенность CMP 50HX - программные ограничения отдельных вычислительных операций. В стандартной конфигурации особенно сильно снижается скорость FP32 и DP4A, тогда как FP16 работает значительно быстрее.
В сентябре 2026 года разработчики экспериментальной разблокировки сравнили производительность одной карты с обычным драйвером и тем же драйвером после применения модификации.
| Вычисления | До разблокировки | После разблокировки | Прирост |
|---|---|---|---|
| FP32, TFLOPS | 0.427 | 13.512 | 31.7× |
| FP16 half2, TFLOPS | 26.923 | 26.698 | ≈1× |
| DP4A / INT8, TIOPS | 1.689 | 47.984 | 28.4× |
Результаты одного сравнительного эксперимента при одинаковой программной основе. Измерения после разблокировки не являются заводскими характеристиками.
Производительность FP32 выросла почти в 32 раза, а DP4A - более чем в 28 раз. При этом скорость обычных FP16-операций практически не изменилась.
Это подтверждает, что ограничения затрагивают конкретные вычислительные блоки и инструкции, а не весь GPU.
После разблокировки FP32 достигла 13.51 TFLOPS - выше теоретических 11.07 TFLOPS при заводской частоте Boost. Причина в более высокой рабочей частоте во время эксперимента. Сравнивать эти результаты без учёта частот некорректно.
В отдельном тесте после разблокировки FP16 Tensor WMMA достигла 106.8 TFLOPS. Этот результат относится к тензорным операциям и не сопоставим напрямую с обычным FP16 из таблицы.
Экспериментальная разблокировка в 2026 году
Разработчики смогли восстановить вычислительную производительность CMP 50HX с помощью UEFI-модификации и изменений программной конфигурации.
Для проверенной версии используется драйвер NVIDIA 610.43.03. Разблокировка требует загрузки UEFI и включённого Above 4G Decoding. Secure Boot можно сохранить при правильной подписи UEFI-приложения и регистрации ключа.
Дополнительные модификации позволяют задействовать PCIe Gen2 и экспериментальную поддержку ReBAR. Однако для этих функций могут потребоваться отдельные изменения драйверов.
Результаты подтверждены на конкретных тестовых конфигурациях. Совместимость с другими платами и системами необходимо проверять отдельно.
Производительность в локальных LLM
10 GB видеопамяти позволяют размещать на CMP 50HX многие квантованные языковые модели с 7-9 миллиардами параметров.
В тестировании Ollama с модифицированными драйверами были получены следующие результаты генерации:
| Модель | CMP 50HX, токенов/с |
|---|---|
| Qwen3 8B Q4_K_M | около 28 |
| Llama 3.1 8B Instruct Q6_K | 32 |
| Dolphin3 8B | 28 |
| Gemma 2 9B | 33 |
| Gemma 3 4B Q8_0 | 57 |
Скорость генерации до экспериментальной разблокировки вычислений 2026 года.
Эти показатели объясняют, почему CMP 50HX оставалась пригодной для инференса даже при крайне низкой производительности FP32.
Однако ограничение DP4A тоже важно. При обработке квантованных моделей CUDA может использовать целочисленные операции, включая DP4A. Снижение их скорости способно ограничивать как генерацию токенов, так и обработку входного контекста.
Особенно чувствительной может оказаться обработка длинных промптов (prefill), где вычислительная нагрузка выше. Но подтверждённых сравнительных измерений prefill до и после разблокировки пока недостаточно для количественных выводов.
CMP 50HX имеет пропускную способность памяти 560 GB/s против 360 GB/s у RTX 3060 12 GB. Однако высокая пропускная способность сама по себе не гарантирует более быструю генерацию: ограничения вычислений, особенности CUDA-ядер и квантования также влияют на результат.
Разблокировка DP4A создаёт предпосылки для ускорения LLM, но прирост в 28 раз в синтетическом тесте нельзя переносить на скорость генерации токенов.
При подходящем квантовании и небольшом контексте отдельные модели на 12-14 миллиардов параметров также могут помещаться в 10 GB VRAM. Это зависит от размера весов, KV-кеша и накладных расходов приложения. Если часть слоёв переносится на CPU, скорость заметно снижается.
Ограничения PCIe
Для MSI CMP 50HX заявлен интерфейс PCIe 1.0 x4 с теоретической пропускной способностью около 1 GB/s в каждом направлении.
Для майнинга это не было критично, поскольку обмен данными с CPU относительно невелик. Однако при загрузке LLM и передаче крупных массивов данных медленный PCIe увеличивает время ожидания.
Экспериментальные модификации позволяют перевести интерфейс в режим PCIe Gen2 x4. Его теоретическая пропускная способность составляет около 2 GB/s в каждом направлении. В тестовой системе после модификации измеренная скорость передачи достигала примерно 1.7 GB/s.
Если модель полностью помещается в VRAM, скорость генерации токенов может сравнительно слабо зависеть от PCIe. При переносе слоёв между RAM и GPU влияние интерфейса становится значительно заметнее.
Производительность в майнинге
CMP 50HX первоначально предназначалась для добычи Ethereum на алгоритме Ethash. NVIDIA заявляла следующие показатели семейства CMP:
| Видеокарта | Ethash | Энергопотребление |
|---|---|---|
| CMP 30HX | 26 MH/s | 125 W |
| CMP 40HX | 36 MH/s | 185 W |
| CMP 50HX | 45 MH/s | 250 W |
| CMP 90HX | 86 MH/s | 320 W |
Заявленные характеристики эталонных решений NVIDIA для условий 2021 года.
CMP 50HX обеспечивала на 25% более высокий хешрейт, чем CMP 40HX. Но после перехода Ethereum на Proof of Stake в сентябре 2022 года добыча ETH на видеокартах прекратилась.
Использование CMP 50HX для других алгоритмов возможно, но его экономическая целесообразность зависит от сложности сети и стоимости электроэнергии.
Можно ли использовать CMP 50HX для игр
Несмотря на родство с RTX 2080 Ti, CMP 50HX не предназначена для игр.
У карты нет видеовыходов, а стандартная конфигурация ограничивает графические функции. Модифицированные драйверы позволяют запускать отдельные приложения, но не гарантируют совместимость с играми.
Даже после разблокировки вычислительных операций сохраняются ограничения графического конвейера. Поэтому производительность RTX 2080 Ti нельзя автоматически переносить на CMP 50HX.
Стоит ли покупать NVIDIA CMP 50HX в 2026 году
CMP 50HX представляет интерес для экспериментов с CUDA, локальными LLM и модификацией GPU. Её основные преимущества - 10 GB GDDR6, широкая шина памяти и возможность восстановления вычислительной производительности.
Но для обычной рабочей системы остаются ограничения: нестандартные драйверы, медленный PCIe и отсутствие видеовыходов.
Для локальных нейросетей более универсальной альтернативой остаётся GeForce RTX 3060 12 GB. Она предлагает больше видеопамяти, полноценную поддержку CUDA и стандартный интерфейс PCIe.
CMP 50HX имеет смысл рассматривать при существенной экономии относительно RTX 3060 и готовности самостоятельно настраивать программное обеспечение. Для стабильной работы без модификаций предпочтительнее обычная GeForce.
Вывод: NVIDIA CMP 50HX - специализированный ускоритель на базе TU102 с 10 GB GDDR6. Экспериментальная разблокировка 2026 года показала рост FP32 в 31.7 раза и DP4A в 28.4 раза, но её влияние на реальные LLM ещё требует отдельных измерений. Карта интересна для вычислительных экспериментов, однако не является полноценной заменой GeForce.
Сравнение GPU
Сравнить CMP 50HX с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Похожие сравнения видеокарт


Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/ru/gpu/nvidia-cmp-50hx" target="_blank">NVIDIA CMP 50HX</a>