NVIDIA Tesla V100 SXM2 32 GB

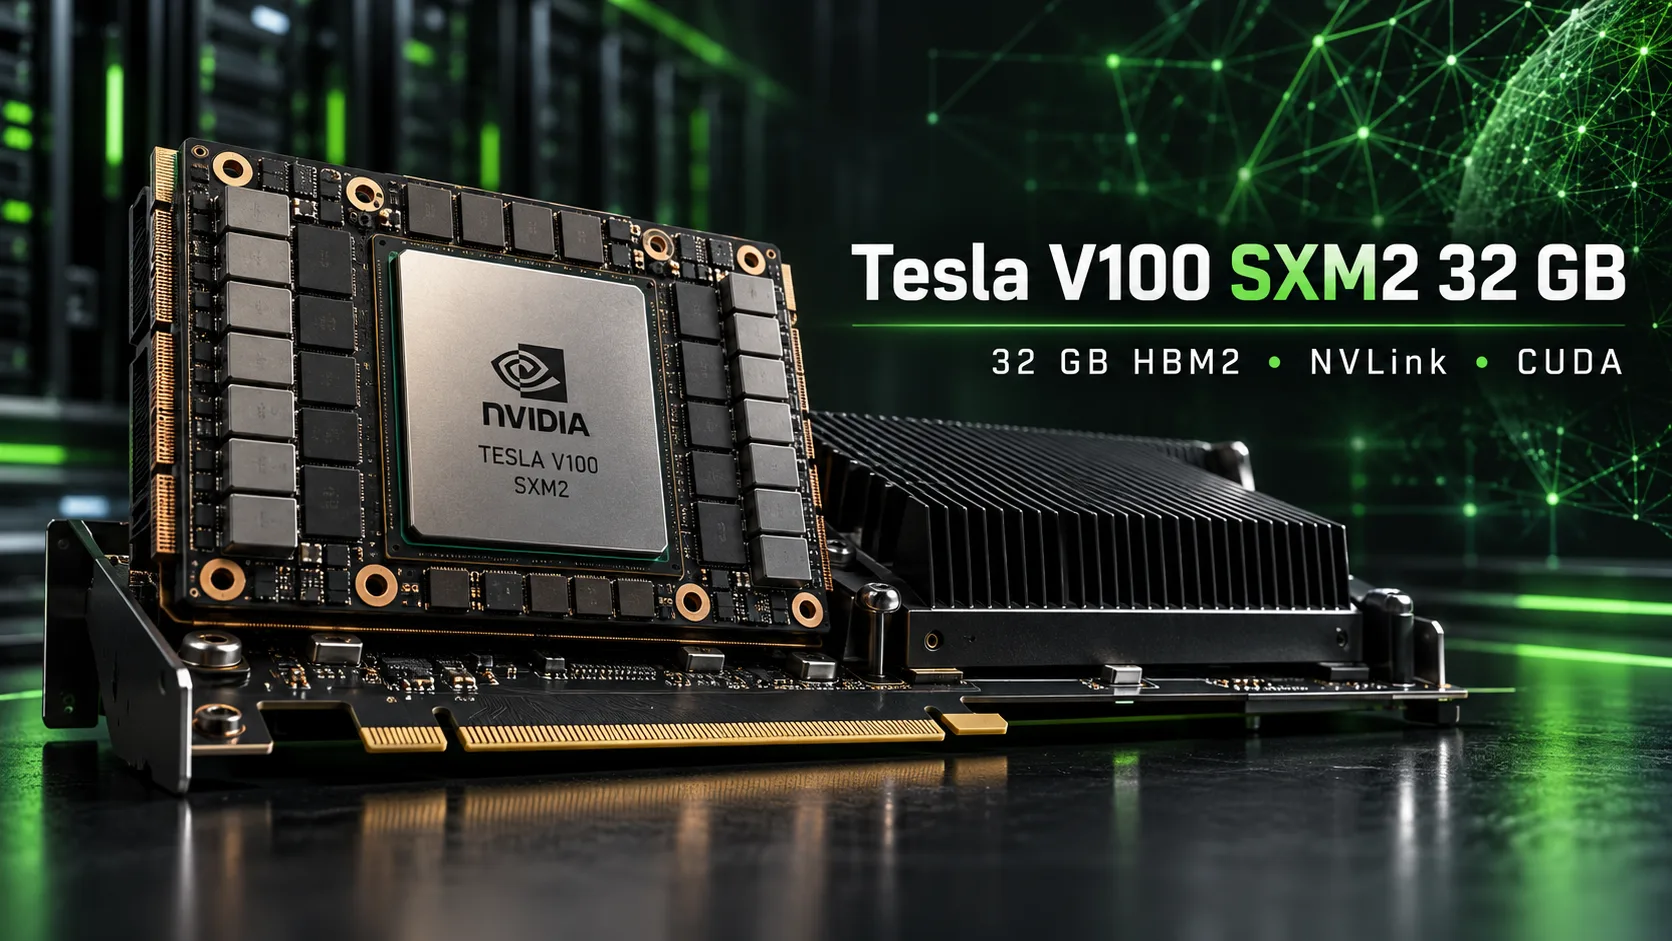
Tesla V100 SXM2 32 GB : beaucoup de mémoire pour les réseaux neuronaux, mais une intégration complexe
La Tesla V100 SXM2 32 GB est un module de calcul pour serveur doté de 32 GB de mémoire HBM2, qui peut être connecté à un PC classique au moyen d’un adaptateur. Ses performances sont proches de celles de la Tesla V100 PCIe, mais elle permet de relier plusieurs accélérateurs via NVLink. Sur le marché de l’occasion, ces modules coûtent parfois moins cher que des cartes PCIe prêtes à l’emploi, bien que l’économie dépende du prix de l’adaptateur et du système de refroidissement.
NVIDIA a présenté la version 32 GB en mars 2018. Son prix initial était d’environ $11 500. Aujourd’hui, ces modules proviennent de serveurs réformés et attirent les passionnés qui ont besoin de plus de 24 GB de mémoire vidéo pour exécuter des modèles de langage en local.
Cependant, le SXM2 ne s’installe pas directement dans un slot PCIe et nécessite une alimentation ainsi qu’un refroidissement séparés. Une autre limitation concerne le support logiciel : NVIDIA met fin au développement des pilotes pour l’architecture Volta, et CUDA 13 ne prend plus en charge la compilation d’applications pour les V100.
Positionnement dans la gamme
La Tesla V100 SXM2 repose sur une puce GV100 gravée en 12 nm, avec 5120 cœurs CUDA et 640 cœurs Tensor. La mémoire HBM2 est connectée via un bus de 4096 bits. Par rapport à la version PCIe, le module se distingue par ses fréquences, sa consommation électrique et son interface.
| Modèle | Mémoire | Bande passante | Boost | TDP | Interface |
|---|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16 |
| Tesla V100 SXM2 16 GB | 16 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, NVLink 2.0 |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, NVLink 2.0 |
Les performances théoriques de la SXM2 atteignent 15,7 TFLOPS en FP32, 7,8 TFLOPS en FP64 et 125 TFLOPS avec les cœurs Tensor en FP16.
Les six lignes NVLink 2.0 offrent jusqu’à 300 GB/s de bande passante bidirectionnelle cumulée. C’est nettement supérieur aux possibilités du PCIe 3.0, mais le débit réel des échanges entre deux GPU dépend du nombre de liaisons qui les relient.
Ces modules ont été utilisés dans les systèmes serveurs NVIDIA DGX-1 et dans les configurations cloud AWS p3dn. Sur le marché de l’occasion, on trouve des exemplaires portant les références 699-2G503-0203-200 et 699-2G503-0204-200, ainsi que des versions serveur HPE P05912-001.
Installer le module dans un PC classique
Adaptateur SXM2-PCIe. Les cartes pour un seul module coûtent environ $60-100. Elles se connectent à un port PCIe 3.0 x16 et nécessitent généralement une alimentation supplémentaire via deux connecteurs à 8 broches. Avant l’achat, il faut vérifier que l’adaptateur est bien compatible avec la V100 SXM2 et contrôler son schéma d’alimentation.
Un adaptateur classique ne prend pas en charge le NVLink. Avec lui, la V100 fonctionne comme un accélérateur autonome, et les avantages du SXM2 se limitent à sa fréquence plus élevée et à sa limite de puissance nominale.
Cartes pour plusieurs modules. Des cartes spéciales dotées de lignes NVLink sont disponibles pour relier deux ou quatre V100. Les modèles pour deux modules se trouvent aux alentours de $300-500. Dans certaines configurations, la connexion à la carte mère s’effectue par l’intermédiaire d’un commutateur PCIe et de câbles spécifiques.
Avant l’achat, il faut vérifier la topologie des connexions entre les modules : la présence de deux connecteurs SXM2 ne garantit pas à elle seule le fonctionnement du NVLink.
Refroidissement. La V100 SXM2 est conçue pour un système de refroidissement serveur ; un simple radiateur sans flux d’air important ne suffit donc pas. Avec un TDP de 300 W, il faut choisir un radiateur adapté, assurer un flux d’air dirigé et vérifier les températures lors d’une charge prolongée.
Pour les configurations domestiques, on utilise des ventilateurs séparés avec des carénages, parfois fabriqués à l’aide d’une imprimante 3D. La réduction de la limite de puissance via nvidia-smi permet de diminuer la température et le bruit, mais peut limiter les performances.
Système d’exploitation. Linux est préférable pour un banc de test domestique : il est plus facile d’y trouver des instructions, des pilotes et des compilations spécialisées. Windows est également pris en charge, y compris dans certaines configurations expérimentales avec plusieurs V100, mais la compatibilité doit être vérifiée séparément.
Sous Linux, il est important d’installer le module propriétaire du pilote NVIDIA. À partir de la branche 560, le module de noyau open source est proposé par défaut ; il ne prend en charge que les architectures Turing et plus récentes. Il ne convient pas à Volta.
Performances dans les modèles de langage
Un seul module avec 32 GB de mémoire
Lors de la génération de tokens, les performances sont souvent limitées par la bande passante de la mémoire vidéo. Celle-ci est identique sur les versions SXM2 et PCIe, à 900 GB/s ; l’avantage de la SXM2 est donc généralement faible dans ce type de tâche.
Lors d’un test réalisé par un utilisateur avec une seule V100 SXM2 32 GB, le modèle Qwen3.6-27B a été exécuté dans llama.cpp avec différents niveaux de quantification.
| Quantification | Génération, tok/s |
|---|---|
| Q4_K_M | 32,2 |
| Q5_K_M | 29,1 |
| Q6_K | 25,1 |
| Q8_0 | 22,8 |
Le test a été réalisé sur un seul thread, avec une génération de 128 à 2048 tokens. Il s’agit des résultats d’une configuration précise, et non d’une vitesse garantie pour n’importe quelle V100.
Le principal avantage de la version 32 GB est la possibilité de placer entièrement Qwen3.6-27B en Q8_0. Une carte graphique dotée de 24 GB ne dispose pas de suffisamment de mémoire pour cette quantification.
Cependant, les poids en Q8_0 occupent presque toute la mémoire vidéo disponible. Pour les longues conversations, il vaut mieux choisir Q4_K_M ou Q5_K_M afin de laisser davantage de place au cache KV.
Long contexte et compilations optimisées
Avec un long contexte, les performances diminuent sensiblement. Les passionnés tentent de réduire ces pertes en modifiant llama.cpp et en utilisant le décodage spéculatif MTP.
Dans un test publié, les résultats suivants ont été obtenus avec Qwen3.8-27B Q4_K_M sur une seule V100 SXM2 32 GB :
| Compilation de llama.cpp | Contexte de 1 k, tok/s | Contexte de 128 k, tok/s |
|---|---|---|
| Standard | 36,0 | 16,5 |
| Avec des correctifs pour Volta, sans MTP | 35,2 | 23,8 |
| Avec correctifs et MTP | 65,1 | 42,2 |
Avec un contexte de 128 k tokens, la compilation optimisée avec MTP s’est révélée 2,6 fois plus rapide que la version standard. Il s’agit toutefois du résultat d’une configuration particulière, qui dépend du modèle, des requêtes et de l’efficacité du décodage spéculatif.
La mise en cache du prompt accélère également les sessions d’agents en plusieurs étapes. Dans la même expérience, le temps de traitement d’un tour est passé de 22,94 à 3,08 secondes grâce à la réutilisation de l’historique déjà traité.
Plusieurs modules et NVLink
Les avantages du SXM2 deviennent plus visibles dans les systèmes équipés de plusieurs GPU. Le NVLink accélère les échanges de données entre les accélérateurs et permet d’utiliser plus efficacement le parallélisme tensoriel.
Le parallélisme tensoriel est également possible via PCIe, mais les échanges intensifs entre les GPU peuvent limiter la vitesse.
| Configuration | Tâche | Résultat |
|---|---|---|
| 2× V100 SXM2 32 GB, NVLink, vLLM 0.6.4 | Qwen2.5-32B, 32 requêtes simultanées | 206 tok/s au total |
| 4× V100 SXM2 32 GB, fork de llama.cpp | Qwen3.8-Flash-Next 125B, contexte de 16 k | 42,2 tok/s |
| 4× V100 SXM2 32 GB, même fork | Même modèle, contexte de 256 k | 21,8 tok/s |
Lors du premier test, la vitesse cumulée de traitement de 32 requêtes a été mesurée, et non les performances d’une seule conversation.
Dans la configuration à quatre V100, le modèle MoE Qwen3.8-Flash-Next comportait 125 milliards de paramètres principaux et environ 6 milliards de paramètres actifs par token. Sa version quantifiée, d’environ 156 GiB, ne tenait pas entièrement dans les 128 GiB de mémoire vidéo. Une partie des données se trouvait dans la mémoire vive du serveur.
Cette expérience a été réalisée sous Windows Server 2022 avec CUDA 12.8 et une version modifiée de llama.cpp. Elle montre les possibilités du matériel, mais nécessite une configuration nettement plus complexe qu’un lancement standard du modèle sur une seule carte graphique.
Lors d’une comparaison publiée par Level1Techs, une paire de Radeon AI PRO R9700 32 GB exécutant llama.cpp a affiché des performances cumulées maximales supérieures de 32 % à celles d’une paire de V100. En revanche, avec vLLM et le parallélisme tensoriel, deux V100 ont atteint 206 tok/s, soit 58 % de plus que le meilleur résultat obtenu par les R9700 dans cette expérience.
Cette comparaison concerne des versions précises des logiciels, le modèle Qwen2.5-32B et le traitement par lots de requêtes courtes. Ces pourcentages ne peuvent pas être transposés à d’autres modèles ni aux contextes longs.
Jeux et calculs en FP64
Bien que la Tesla V100 soit destinée au calcul, des passionnés ont également lancé des jeux sur la version SXM2. Lors d’un test utilisateur, une V100 SXM2 16 GB a fourni environ 78 FPS dans Cyberpunk 2077 en 2560×1080, avec des réglages élevés, sans mise à l’échelle ni génération d’images.
Cependant, le module ne possède pas de sorties vidéo, de ray tracing matériel ni de prise en charge du DLSS. Les jeux nécessitent une configuration supplémentaire du système, et les 32 GB de HBM2 n’apportent aucun avantage pratique par rapport à des cartes graphiques de jeu offrant des performances comparables.
En calculs double précision, la V100 atteint 7,8 TFLOPS en FP64, soit environ six fois plus que la RTX 4090. Cet ancien accélérateur reste donc intéressant pour les calculs scientifiques qui exigent de hautes performances en FP64.
Support logiciel
NVIDIA a limité le support de l’architecture Volta à la branche de pilotes R580. Sa maintenance est prévue jusqu’en juin 2028, mais les branches suivantes ne sont déjà plus conçues pour les V100.
CUDA 13 a supprimé la compilation et la prise en charge des bibliothèques pour Volta. La dernière branche compatible du CUDA Toolkit est la 12.x. Le pilote R580 reste toutefois compatible avec les applications compilées pour des versions antérieures de CUDA.
Le problème touche progressivement aussi les logiciels destinés aux réseaux neuronaux. Les nouvelles compilations prêtes à l’emploi peuvent ne plus inclure le code pour l’architecture sm_70 ; les utilisateurs doivent donc rester sur des versions compatibles ou compiler eux-mêmes les programmes.
Actuellement, la V100 peut être utilisée avec llama.cpp, certaines compilations de PyTorch, des versions adaptées de vLLM et des projets expérimentaux pour Volta. Cependant, les optimisations destinées aux GPU modernes ne sont pas toujours disponibles sur cette génération.
L’absence de prise en charge matérielle du BF16 et du FP8 limite également le choix des modèles et des formats de calcul.
Combien coûte la V100 SXM2 32 GB ?
En 2018, Microway indiquait un prix de $11 458 pour la V100 SXM2 32 GB. Les nouveaux modules ne sont plus fabriqués et le marché de l’occasion dépend fortement de l’approvisionnement en matériel serveur réformé.
En octobre 2026, on trouve les offres suivantes sur eBay :
| Matériel | Prix |
|---|---|
| Tesla V100 SXM2 32 GB, module seul | $658-839 |
| Tesla V100 SXM2 16 GB, module seul | $150-200 |
| Tesla V100 PCIe 32 GB | $650-900 |
| Adaptateur SXM2-PCIe | $60-100 |
| Carte pour deux SXM2 avec NVLink | environ $300-500 |
| Radiateur et ventilateur pour SXM2 | environ $45-100 |
Il s’agit des prix d’annonces individuelles, et non de prix de vente moyens. Les frais de livraison, les taxes et la compatibilité des composants peuvent modifier sensiblement le coût final.
Si l’on achète une SXM2 32 GB à $658, que l’on ajoute un adaptateur à $60 et un système de refroidissement à $60, on arrive à environ $778, hors livraison. À ce prix, l’économie par rapport à une V100 PCIe 32 GB prête à l’emploi n’est plus garantie.
La situation est différente si l’on trouve un module à $350-400. La configuration complète peut alors coûter environ $470-560, tout en conservant un avantage notable par rapport à la version PCIe.
Pour un système équipé de deux modules, le calcul est encore plus complexe. Une carte avec NVLink, les câbles supplémentaires, le refroidissement et l’alimentation peuvent augmenter sensiblement le budget.
Concurrents et alternatives
Tesla V100 PCIe 32 GB. L’alternative la plus proche, avec la même capacité et la même bande passante mémoire. La carte s’installe directement dans un port PCIe, même si son refroidissement passif nécessite toujours un flux d’air dirigé. À coût total comparable, la version PCIe est préférable pour un accélérateur unique.
Tesla V100 SXM2 16 GB. Nettement moins chère que la version 32 GB. Avec un adaptateur et un système de refroidissement, la configuration peut coûter environ $260-350. Elle convient aux modèles quantifiés de petite et moyenne taille, mais les 16 GB limitent le choix des modèles et la longueur du contexte. Deux modules avec NVLink offrent 32 GB de mémoire cumulée, mais ne forment pas pour autant un espace d’adressage unifié pour toutes les applications.
GeForce RTX 3090 24 GB. Une carte graphique plus polyvalente, avec prise en charge matérielle du BF16, des bibliothèques CUDA modernes et un fonctionnement normal sous Windows. Dans certaines tâches de traitement des prompts, elle est nettement plus rapide que la V100. Sur eBay, les offres commencent autour de $1200, tandis que le prix plancher de la majorité des annonces se situe autour de $1600 à la fin du mois d’octobre. Son principal défaut pour les grands modèles est sa capacité de 24 GB au lieu de 32 GB.
AMD Instinct MI50 32 GB. Une alternative dotée de 32 GB de HBM2 et d’une bande passante d’environ 1 TB/s. Sur eBay, les offres commencent autour de $650, même si les prix peuvent différer sur d’autres plateformes. Le principal problème réside dans le support obsolète de ROCm et dans la configuration plus complexe des logiciels de calcul. Pour llama.cpp, des compilations compatibles peuvent être utilisées, notamment des variantes avec Vulkan, mais les programmes CUDA ne fonctionneront pas sans adaptation.
Faut-il l’acheter ?
La Tesla V100 SXM2 32 GB peut intéresser ceux qui souhaitent exécuter en local des modèles de langage nécessitant plus de 24 GB de mémoire vidéo et qui sont prêts à construire eux-mêmes le système de refroidissement.
Si le prix du module ne dépasse pas $350-400, l’achat peut être plus avantageux qu’une V100 PCIe 32 GB, même en tenant compte des composants supplémentaires. Si le coût de la configuration complète se rapproche de celui d’une carte PCIe, l’avantage du SXM2 disparaît pratiquement.
Pour plusieurs accélérateurs, les cartes avec NVLink sont plus intéressantes. Elles accélèrent les échanges entre les GPU et conviennent aux expérimentations avec le parallélisme tensoriel, mais nécessitent davantage de dépenses et une configuration complexe.
Les principales limites de la V100 SXM2 sont son refroidissement, sa consommation pouvant atteindre 300 W, l’absence de formats de calcul modernes et un support logiciel qui se réduit progressivement. Le module reste utilisable pour les LLM locaux, les calculs scientifiques et les expérimentations avec CUDA.
Si vous avez besoin d’une seule carte graphique sans configuration complexe, mieux vaut choisir une V100 PCIe 32 GB. Le SXM2 ne se justifie qu’en cas d’économie substantielle ou de besoin du NVLink.
Comparaison de GPU
Comparer Tesla V100 SXM2 32 GB avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Comparaisons de GPU associées


Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/fr/gpu/nvidia-tesla-v100-sxm2-32-gb" target="_blank">NVIDIA Tesla V100 SXM2 32 GB</a>