NVIDIA Tesla V100 SXM2 32 GB
Tesla V100 SXM2 32 GB: mucha memoria para redes neuronales, pero un montaje complicado
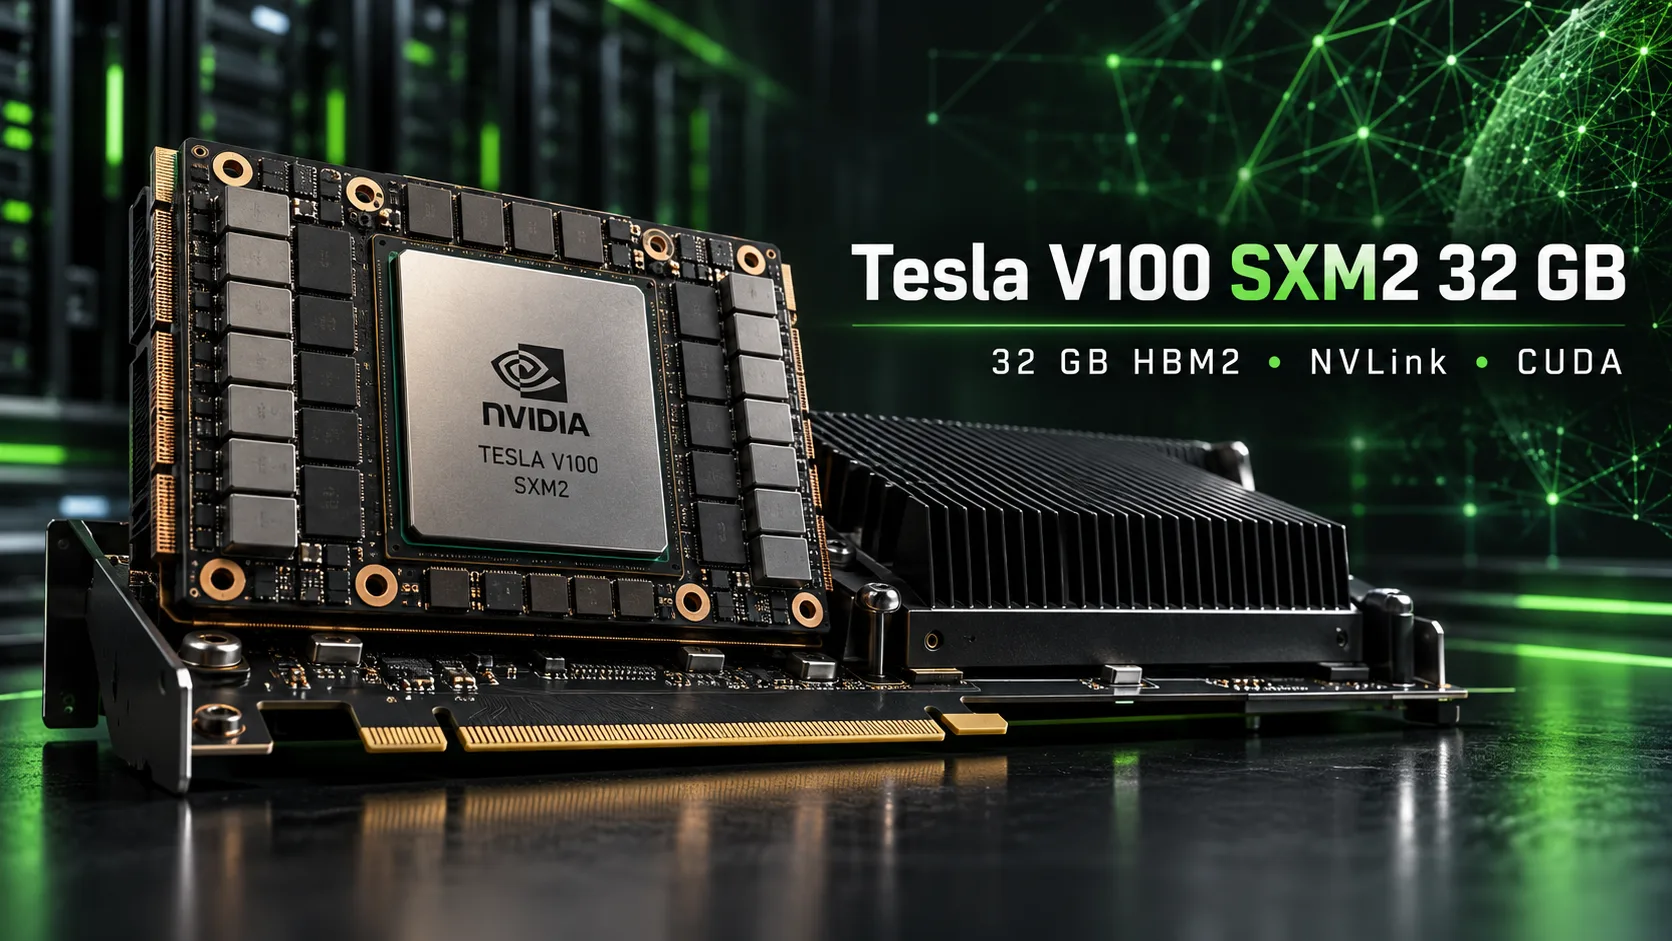
Tesla V100 SXM2 32 GB es un módulo de cómputo para servidores con 32 GB de memoria HBM2 que se puede conectar a un PC convencional mediante un adaptador. Su rendimiento es similar al de la Tesla V100 PCIe, pero permite combinar varios aceleradores mediante NVLink. En el mercado de segunda mano, estos módulos a veces cuestan menos que las tarjetas PCIe listas para usar, aunque el ahorro depende del precio del adaptador y del sistema de refrigeración.
NVIDIA presentó la versión de 32 GB en marzo de 2018. El precio inicial era de unos $11 500. Actualmente, los módulos se venden después de la retirada de servidores y atraen a los entusiastas que necesitan más de 24 GB de memoria de vídeo para ejecutar modelos de lenguaje localmente.
Sin embargo, la SXM2 no se instala directamente en una ranura PCIe y requiere alimentación y refrigeración independientes. Otra limitación está relacionada con el soporte de software: NVIDIA está poniendo fin al desarrollo de controladores para la arquitectura Volta, y CUDA 13 ya no permite compilar aplicaciones para V100.
Posición en la gama
Tesla V100 SXM2 está construida sobre un chip GV100 de 12 nm con 5120 núcleos CUDA y 640 núcleos tensoriales. La memoria HBM2 está conectada mediante un bus de 4096 bits. El módulo se diferencia de la versión PCIe en las frecuencias, el consumo energético y la interfaz.
| Modelo | Memoria | Ancho de banda | Boost | TDP | Interfaz |
|---|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16 |
| Tesla V100 SXM2 16 GB | 16 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, NVLink 2.0 |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, NVLink 2.0 |
El rendimiento especificado de la SXM2 alcanza 15,7 TFLOPS en FP32, 7,8 TFLOPS en FP64 y 125 TFLOPS en los núcleos tensoriales FP16.
Seis enlaces NVLink 2.0 proporcionan hasta 300 GB/s de ancho de banda bidireccional total. Es considerablemente más que lo que ofrece PCIe 3.0, pero la velocidad real de comunicación entre dos GPU depende del número de enlaces que las conecten.
Los módulos se utilizaban en los sistemas de servidores NVIDIA DGX-1 y en configuraciones en la nube AWS p3dn. En el mercado de segunda mano aparecen unidades con los números de pieza 699-2G503-0203-200 y 699-2G503-0204-200, así como versiones para servidores HPE P05912-001.
Cómo instalar el módulo en un PC convencional
Adaptador SXM2-PCIe. Las placas para un solo módulo cuestan aproximadamente $60-100. Se conectan a PCIe 3.0 x16 y normalmente requieren alimentación adicional mediante dos conectores de 8 pines. Antes de comprar, hay que comprobar que el adaptador sea compatible específicamente con V100 SXM2 y revisar su esquema de alimentación.
Un adaptador convencional no proporciona NVLink. Con él, la V100 funciona como un acelerador independiente, y las ventajas de la SXM2 se limitan a una frecuencia más alta y a un límite de potencia especificado superior.
Placas para varios módulos. Para combinar dos o cuatro V100 existen placas especiales con los enlaces NVLink cableados. Las variantes para dos módulos se encuentran aproximadamente por $300-500. En algunos diseños, la conexión con la placa base se realiza mediante un conmutador PCIe y cables especiales.
Antes de comprar, es necesario comprobar la topología de las conexiones entre módulos: la presencia de dos conectores SXM2 no garantiza que NVLink vaya a funcionar.
Refrigeración. La V100 SXM2 está diseñada para un sistema de refrigeración de servidor, por lo que un disipador convencional sin un flujo de aire intenso no es suficiente. Con un TDP de 300 W, hay que elegir un disipador adecuado, proporcionar un flujo de aire dirigido y comprobar las temperaturas bajo carga prolongada.
En los montajes domésticos se utilizan ventiladores independientes con carenados, incluidos algunos fabricados mediante impresión 3D. Reducir el límite de potencia mediante nvidia-smi ayuda a disminuir la temperatura y el ruido, pero puede limitar el rendimiento.
Sistema operativo. Para un banco de pruebas doméstico, Linux es preferible: es más fácil encontrar instrucciones, controladores y compilaciones especializadas. Windows también es compatible, incluidas algunas configuraciones experimentales con varias V100, pero la compatibilidad debe comprobarse por separado.
En Linux es importante instalar el módulo propietario del controlador de NVIDIA. A partir de la rama 560, se ofrece por defecto un módulo de código abierto para el kernel que solo es compatible con las arquitecturas Turing y posteriores. No es adecuado para Volta.
Rendimiento en modelos de lenguaje
Un módulo con 32 GB de memoria
Durante la generación de tokens, la velocidad suele estar limitada por el ancho de banda de la memoria de vídeo. La SXM2 y la PCIe tienen el mismo ancho de banda -900 GB/s-, por lo que la ventaja de la SXM2 en estas tareas suele ser reducida.
En una prueba realizada por un usuario, un modelo Qwen3.6-27B se ejecutó en llama.cpp sobre una V100 SXM2 32 GB con distintas variantes de cuantización.
| Cuantización | Generación, tokens/s |
|---|---|
| Q4_K_M | 32,2 |
| Q5_K_M | 29,1 |
| Q6_K | 25,1 |
| Q8_0 | 22,8 |
La prueba se realizó en un solo hilo, con generaciones de entre 128 y 2048 tokens. Son resultados de una configuración concreta, no una velocidad garantizada para cualquier V100.
La principal ventaja de la versión de 32 GB es la posibilidad de cargar por completo Qwen3.6-27B en Q8_0. En una tarjeta gráfica con 24 GB, no hay memoria suficiente para esa cuantización.
Sin embargo, los pesos de Q8_0 ocupan casi toda la memoria de vídeo disponible. Para diálogos largos, es mejor elegir Q4_K_M o Q5_K_M y dejar más espacio para la caché KV.
Contexto largo y compilaciones optimizadas
Con contextos largos, el rendimiento cae notablemente. Los entusiastas intentan reducir estas pérdidas mediante cambios en llama.cpp y la decodificación especulativa MTP.
En una prueba publicada con Qwen3.8-27B Q4_K_M en una V100 SXM2 32 GB se obtuvieron los siguientes resultados:
| Compilación de llama.cpp | Contexto de 1 mil, tokens/s | Contexto de 128 mil, tokens/s |
|---|---|---|
| Estándar | 36,0 | 16,5 |
| Con parches para Volta, sin MTP | 35,2 | 23,8 |
| Con parches y MTP | 65,1 | 42,2 |
Con un contexto de 128 mil tokens, la compilación optimizada con MTP resultó ser 2,6 veces más rápida que la estándar. Sin embargo, es el resultado de una configuración especial que depende del modelo, las consultas y la eficiencia de la decodificación especulativa.
La caché de prompts también acelera las sesiones agénticas de varios pasos. En el mismo experimento, el tiempo de procesamiento de un turno se redujo de 22,94 a 3,08 segundos gracias a la reutilización del historial ya procesado.
Varios módulos y NVLink
En los sistemas con varias GPU, las ventajas de la SXM2 son más evidentes. NVLink acelera el intercambio de datos entre los aceleradores y permite utilizar el paralelismo tensorial de forma más eficiente.
El paralelismo tensorial también es posible mediante PCIe, pero el intercambio intensivo entre las GPU puede limitar la velocidad.
| Configuración | Tarea | Resultado |
|---|---|---|
| 2× V100 SXM2 32 GB, NVLink, vLLM 0.6.4 | Qwen2.5-32B, 32 solicitudes simultáneas | 206 tokens/s en total |
| 4× V100 SXM2 32 GB, fork de llama.cpp | Qwen3.8-Flash-Next 125B, contexto de 16 mil | 42,2 tokens/s |
| 4× V100 SXM2 32 GB, el mismo fork | El mismo modelo, contexto de 256 mil | 21,8 tokens/s |
En la primera prueba se midió la velocidad total de servicio de 32 solicitudes, no el rendimiento de un solo diálogo.
En la configuración con cuatro V100 se utilizó el modelo MoE Qwen3.8-Flash-Next, con 125.000 millones de parámetros principales y aproximadamente 6.000 millones de parámetros activos por token. Su versión cuantizada, de unos 156 GiB, no cabía por completo en los 128 GiB de memoria de vídeo. Parte de los datos se encontraba en la memoria RAM del servidor.
Este experimento se realizó con Windows Server 2022, CUDA 12.8 y una versión modificada de llama.cpp. Muestra las posibilidades del hardware, pero requiere una configuración considerablemente más compleja que la ejecución estándar de un modelo en una sola tarjeta gráfica.
En una comparativa de Level1Techs, un par de Radeon AI PRO R9700 32 GB en llama.cpp mostró un rendimiento máximo total un 32 % superior al de un par de V100. Sin embargo, al utilizar vLLM con paralelismo tensorial, dos V100 alcanzaron 206 tokens/s, superando en un 58 % el mejor resultado de las R9700 en ese experimento.
La comparación se refiere a versiones concretas del software, al modelo Qwen2.5-32B y al procesamiento por lotes de solicitudes cortas. Estos porcentajes no se pueden extrapolar a otros modelos ni a contextos largos.
Juegos y cálculos FP64
Aunque la Tesla V100 está destinada al cómputo, los entusiastas también han ejecutado juegos en la versión SXM2. En una prueba realizada por un usuario, la V100 SXM2 16 GB ofreció unos 78 FPS en Cyberpunk 2077 con una resolución de 2560×1080 y ajustes altos, sin escalado ni generación de fotogramas.
Sin embargo, el módulo no tiene salidas de vídeo, trazado de rayos por hardware ni compatibilidad con DLSS. Para jugar se necesita una configuración adicional del sistema, y los 32 GB de HBM2 no ofrecen una ventaja práctica frente a las tarjetas gráficas para juegos de rendimiento comparable.
En cálculos de doble precisión, la V100 alcanza 7,8 TFLOPS en FP64, aproximadamente seis veces más que la RTX 4090. Por eso, el antiguo acelerador sigue siendo interesante para los cálculos científicos que requieren un alto rendimiento en FP64.
Soporte de software
NVIDIA limitó el soporte de la arquitectura Volta a la rama de controladores R580. Su mantenimiento está previsto hasta junio de 2028, pero las ramas posteriores ya no están diseñadas para V100.
CUDA 13 eliminó la compilación y el soporte de bibliotecas para Volta. La última línea compatible de CUDA Toolkit es la 12.x. Al mismo tiempo, el controlador R580 mantiene la compatibilidad con las aplicaciones compiladas para versiones anteriores de CUDA.
El problema también afecta poco a poco al software para redes neuronales. Las nuevas compilaciones ya preparadas pueden no incluir el código para la arquitectura sm_70, por lo que los usuarios tienen que mantener versiones compatibles o compilar los programas por su cuenta.
Actualmente, la V100 se puede utilizar con llama.cpp, ciertas compilaciones de PyTorch, versiones adaptadas de vLLM y proyectos experimentales para Volta. Sin embargo, las optimizaciones para las GPU modernas no siempre están disponibles en esta generación.
La ausencia de compatibilidad por hardware con BF16 y FP8 también limita la elección de modelos y formatos de cálculo.
Cuánto cuesta la V100 SXM2 32 GB
En 2018, Microway indicaba un precio de $11 458 para la V100 SXM2 32 GB. Actualmente ya no se fabrican módulos nuevos, y el mercado de segunda mano depende en gran medida de la oferta de equipos de servidores retirados.
En octubre de 2026 se encuentran en eBay las siguientes ofertas:
| Equipo | Precio |
|---|---|
| Tesla V100 SXM2 32 GB, módulo suelto | $658-839 |
| Tesla V100 SXM2 16 GB, módulo suelto | $150-200 |
| Tesla V100 PCIe 32 GB | $650-900 |
| Adaptador SXM2-PCIe | $60-100 |
| Placa para dos SXM2 con NVLink | aproximadamente $300-500 |
| Disipador y ventilador para SXM2 | aproximadamente $45-100 |
Son precios de anuncios individuales, no precios medios de venta. Los gastos de envío, los impuestos y la compatibilidad de los componentes pueden modificar notablemente el coste final.
Si se compra una SXM2 32 GB por $658 y se añaden un adaptador de $60 y un sistema de refrigeración de $60, el total será de unos $778, sin contar el envío. A ese precio, el ahorro frente a una V100 PCIe 32 GB lista para usar ya no está garantizado.
La situación es distinta si se encuentra un módulo por $350-400. En ese caso, el montaje completo puede costar aproximadamente $470-560 y conservar una ventaja notable frente a la versión PCIe.
Para un sistema con dos módulos, el cálculo es aún más complejo. La placa con NVLink, los cables adicionales, la refrigeración y la fuente de alimentación pueden aumentar considerablemente el presupuesto.
Competidores y alternativas
Tesla V100 PCIe 32 GB. Es la alternativa más cercana, con la misma cantidad y el mismo ancho de banda de memoria. La tarjeta se instala directamente en PCIe, aunque la refrigeración pasiva sigue requiriendo un flujo de aire dirigido. Con un coste total comparable, la versión PCIe es preferible para un acelerador único.
Tesla V100 SXM2 16 GB. Es considerablemente más barata que la variante de 32 GB. Con adaptador y refrigeración, el montaje puede costar unos $260-350. Es adecuada para modelos cuantizados pequeños y medianos, pero los 16 GB limitan la elección de modelos y la longitud del contexto. Dos módulos con NVLink ofrecen 32 GB de memoria total, pero no se convierten en un espacio de direcciones unificado para cualquier aplicación.
GeForce RTX 3090 24 GB. Es una tarjeta gráfica más versátil, con compatibilidad por hardware con BF16, bibliotecas CUDA modernas y un funcionamiento normal en Windows. En varias tareas de procesamiento de prompts es notablemente más rápida que la V100. En eBay hay ofertas desde aproximadamente $1200, mientras que el límite inferior de la mayoría de los anuncios a finales de octubre se sitúa en torno a $1600. Su principal desventaja para los modelos grandes son los 24 GB de memoria, frente a los 32 GB.
AMD Instinct MI50 32 GB. Es una alternativa con 32 GB de HBM2 y un ancho de banda de aproximadamente 1 TB/s. En eBay, las ofertas empiezan aproximadamente en $650, aunque los precios de otras plataformas pueden ser diferentes. El principal problema es el soporte obsoleto de ROCm y una configuración más compleja del software de cómputo. Para llama.cpp se pueden utilizar compilaciones compatibles, incluidas variantes con Vulkan, pero los programas CUDA no funcionarán sin adaptación.
¿Vale la pena comprarla?
La Tesla V100 SXM2 32 GB resulta interesante para quienes quieren ejecutar modelos de lenguaje localmente que requieren más de 24 GB de memoria de vídeo y están dispuestos a montar por su cuenta el sistema de refrigeración.
Con un precio del módulo de hasta $350-400, la compra puede ser más ventajosa que una V100 PCIe 32 GB incluso teniendo en cuenta los componentes adicionales. Si el coste del montaje completo se aproxima al de una tarjeta PCIe, la ventaja de la SXM2 prácticamente desaparece.
Para varios aceleradores, resultan más atractivas las placas con NVLink. Aceleran el intercambio entre las GPU y son adecuadas para experimentar con el paralelismo tensorial, pero requieren un mayor presupuesto y una configuración compleja.
Las principales limitaciones de la V100 SXM2 son la refrigeración, un consumo de hasta 300 W, la ausencia de formatos de cálculo modernos y un soporte de software que se reduce gradualmente. El módulo todavía sirve para LLM locales, cálculos científicos y experimentos con CUDA.
Si se necesita una sola tarjeta gráfica sin un montaje complicado, es mejor elegir la V100 PCIe 32 GB. La SXM2 solo está justificada cuando se consigue un ahorro importante o se necesita utilizar NVLink.
Comparación de GPU
Comparar Tesla V100 SXM2 32 GB con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Comparaciones de GPU relacionadas


Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/es/gpu/nvidia-tesla-v100-sxm2-32-gb" target="_blank">NVIDIA Tesla V100 SXM2 32 GB</a>