NVIDIA CMP 50HX

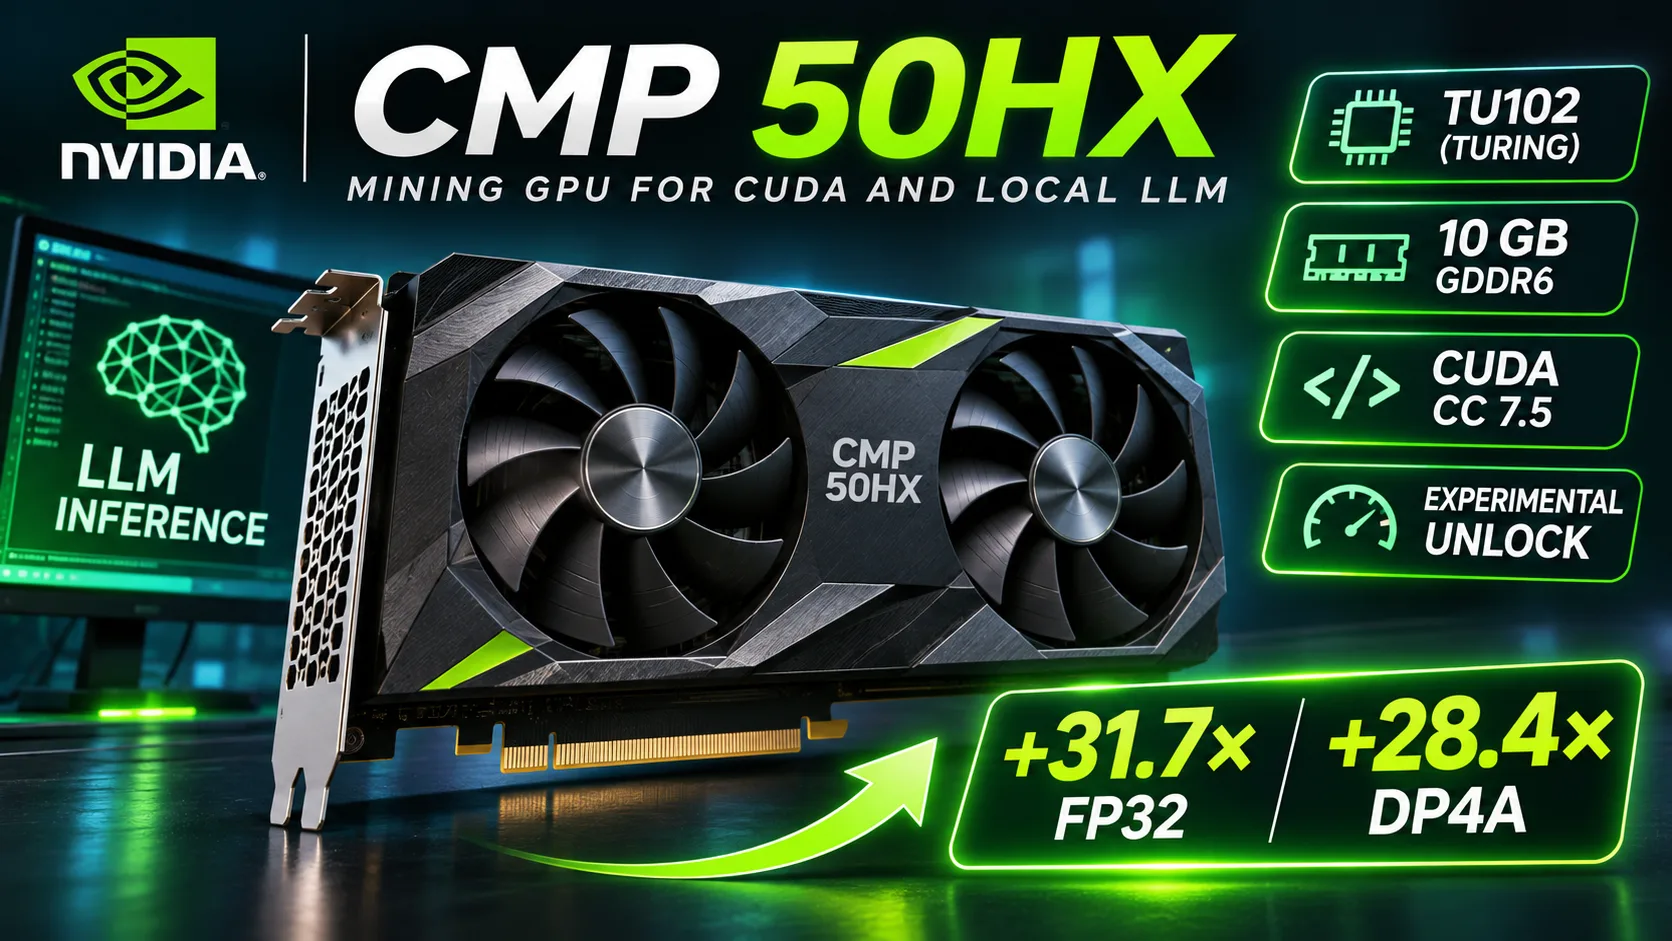
NVIDIA CMP 50HX: 10 GB Speicher für CUDA und lokale LLMs
NVIDIA CMP 50HX ist eine spezialisierte Mining-Grafikkarte, die 2021 auf den Markt kam. Sie verwendet den Grafikprozessor TU102 aus der Turing-Architektur, der mit der GPU der GeForce RTX 2080 Ti verwandt ist. Die Karte verfügt über 3584 CUDA-Kerne und 10 GB GDDR6-Speicher, besitzt jedoch keine Videoausgänge und weist Einschränkungen bei der Rechenleistung auf.
Nach dem Wechsel von Ethereum zu Proof of Stake wurde die CMP 50HX für Experimente mit CUDA und lokalen neuronalen Netzen eingesetzt. Bei einigen LLMs erreicht sie etwa 30 Tokens/s, wobei die Geschwindigkeit von der Art der Berechnungen und der Softwarekonfiguration abhängt. Im Jahr 2026 wurden experimentelle Methoden entwickelt, um einen Teil der Einschränkungen aufzuheben.
Architektur und technische Daten
Die CMP 50HX basiert auf der 12-nm-GPU TU102 mit 56 Streaming-Multiprozessoren. Im Vergleich zur RTX 2080 Ti verfügt sie über weniger aktive Recheneinheiten und einen schmaleren Speicherbus.
| Merkmal | CMP 50HX | RTX 2080 Ti |
|---|---|---|
| CUDA-Kerne | 3584 | 4352 |
| Streaming-Multiprozessoren | 56 | 68 |
| GDDR6-Speicher | 10 GB | 11 GB |
| Speicherbus | 320 Bit | 352 Bit |
| Speicherbandbreite | 560 GB/s | 616 GB/s |
| Boost-Takt | 1545 MHz | 1545 MHz |
| PCIe | 1.0 x4 | 3.0 x16 |
| Leistungsaufnahme | 225 W | 250 W |
| Videoausgänge | Nein | Ja |
Technische Daten der MSI CMP 50HX MINER und der Standardversion der RTX 2080 Ti.
Die CMP 50HX arbeitet mit Taktraten von 1350-1545 MHz. Der GDDR6-Speicher mit einer Geschwindigkeit von 14 Gb/s bietet eine Speicherbandbreite von 560 GB/s. Die theoretische FP32-Leistung beträgt beim Boost-Takt etwa 11,07 TFLOPS.
In der Standardkonfiguration liegt die verfügbare Rechenleistung jedoch deutlich niedriger.
Besonderheiten der CMP 50HX:
- Unterstützung für CUDA Compute Capability 7.5.
- 10 GB GDDR6 für Berechnungen und zum Speichern von Modellen.
- Keine HDMI- und DisplayPort-Anschlüsse.
- Beschränkte PCIe-1.0-x4-Schnittstelle.
- Zwei zusätzliche 8-Pin-Stromanschlüsse.
- Abhängigkeit der verfügbaren Funktionen von den Treibern.
Die MSI-Version hat eine Leistungsaufnahme von 225 W, während die Referenzspezifikation von NVIDIA 250 W vorsieht. Für den Dauerbetrieb ist ein ausreichender Luftstrom im Gehäuse erforderlich.
Leistung bei FP32, FP16 und INT8
Die wichtigste Besonderheit der CMP 50HX sind softwareseitige Einschränkungen bei einzelnen Rechenoperationen. In der Standardkonfiguration sinkt insbesondere die Geschwindigkeit bei FP32 und DP4A stark, während FP16 deutlich schneller arbeitet.
Im September 2026 verglichen die Entwickler der experimentellen Freischaltung die Leistung einer Karte mit einem normalen Treiber und mit demselben Treiber nach Anwendung der Modifikation.
| Berechnungen | Vor der Freischaltung | Nach der Freischaltung | Zuwachs |
|---|---|---|---|
| FP32, TFLOPS | 0.427 | 13.512 | 31.7× |
| FP16 half2, TFLOPS | 26.923 | 26.698 | ≈1× |
| DP4A / INT8, TIOPS | 1.689 | 47.984 | 28.4× |
Ergebnisse eines einzelnen Vergleichsexperiments mit identischer Softwarebasis. Die Messwerte nach der Freischaltung sind keine Werksspezifikationen.
Die FP32-Leistung stieg um fast das 32-Fache, während DP4A um mehr als das 28-Fache zulegte. Die Geschwindigkeit gewöhnlicher FP16-Operationen änderte sich dagegen praktisch nicht.
Dies bestätigt, dass die Einschränkungen bestimmte Recheneinheiten und Instruktionen betreffen und nicht die gesamte GPU.
Nach der Freischaltung erreichte FP32 13,51 TFLOPS und lag damit über den theoretischen 11,07 TFLOPS beim werkseitigen Boost-Takt. Der Grund war die während des Experiments höhere Arbeitsfrequenz. Ein Vergleich dieser Ergebnisse ohne Berücksichtigung der Taktraten ist nicht korrekt.
In einem separaten Test erreichte FP16 Tensor WMMA nach der Freischaltung 106,8 TFLOPS. Dieses Ergebnis bezieht sich auf Tensoroperationen und ist nicht direkt mit dem gewöhnlichen FP16-Wert aus der Tabelle vergleichbar.
Experimentelle Freischaltung im Jahr 2026
Den Entwicklern gelang es, die Rechenleistung der CMP 50HX mithilfe einer UEFI-Modifikation und Änderungen an der Softwarekonfiguration wiederherzustellen.
Für die getestete Version wird der NVIDIA-Treiber 610.43.03 verwendet. Die Freischaltung erfordert das Laden eines UEFI und aktiviertes Above 4G Decoding. Secure Boot kann bei korrekter Signierung der UEFI-Anwendung und Registrierung des Schlüssels beibehalten werden.
Zusätzliche Modifikationen ermöglichen den Betrieb der PCIe-Schnittstelle mit PCIe Gen2 sowie eine experimentelle ReBAR-Unterstützung. Für diese Funktionen können jedoch separate Treiberänderungen erforderlich sein.
Die Ergebnisse wurden auf bestimmten Testkonfigurationen bestätigt. Die Kompatibilität mit anderen Mainboards und Systemen muss separat überprüft werden.
Leistung bei lokalen LLMs
Der 10 GB große Videospeicher ermöglicht es, viele quantisierte Sprachmodelle mit 7-9 Milliarden Parametern auf der CMP 50HX unterzubringen.
Bei Tests mit Ollama und modifizierten Treibern wurden folgende Generationsraten erzielt:
| Modell | CMP 50HX, Tokens/s |
|---|---|
| Qwen3 8B Q4_K_M | etwa 28 |
| Llama 3.1 8B Instruct Q6_K | 32 |
| Dolphin3 8B | 28 |
| Gemma 2 9B | 33 |
| Gemma 3 4B Q8_0 | 57 |
Generationsgeschwindigkeit vor der experimentellen Freischaltung der Berechnungen im Jahr 2026.
Diese Werte erklären, warum die CMP 50HX auch bei äußerst niedriger FP32-Leistung für Inferenz geeignet blieb.
Allerdings ist auch die Einschränkung bei DP4A von Bedeutung. Bei der Verarbeitung quantisierter Modelle kann CUDA Ganzzahloperationen einschließlich DP4A verwenden. Eine geringere Geschwindigkeit dieser Operationen kann sowohl die Token-Generierung als auch die Verarbeitung des Eingangskontexts begrenzen.
Besonders empfindlich kann die Verarbeitung langer Prompts (Prefill) reagieren, bei der die Rechenlast höher ist. Bestätigte Vergleichsmessungen des Prefill-Verhaltens vor und nach der Freischaltung reichen jedoch bislang nicht für quantitative Schlussfolgerungen aus.
Die CMP 50HX bietet eine Speicherbandbreite von 560 GB/s gegenüber 360 GB/s bei der RTX 3060 12 GB. Eine hohe Speicherbandbreite allein garantiert jedoch keine schnellere Generierung: Auch Einschränkungen bei den Berechnungen, die Besonderheiten der CUDA-Kerne und die Quantisierung beeinflussen das Ergebnis.
Die Freischaltung von DP4A schafft Voraussetzungen für eine Beschleunigung von LLMs, doch der 28-fache Zuwachs in einem synthetischen Test lässt sich nicht auf die Geschwindigkeit der Token-Generierung übertragen.
Bei geeigneter Quantisierung und einem kleinen Kontext können auch einzelne Modelle mit 12-14 Milliarden Parametern in 10 GB VRAM untergebracht werden. Dies hängt von der Größe der Gewichte, dem KV-Cache und dem Overhead der Anwendung ab. Wenn ein Teil der Layer auf die CPU ausgelagert wird, sinkt die Geschwindigkeit deutlich.
PCIe-Einschränkungen
Für die MSI CMP 50HX ist eine PCIe-1.0-x4-Schnittstelle angegeben, deren theoretische Bandbreite bei etwa 1 GB/s in jede Richtung liegt.
Für das Mining war dies nicht kritisch, da der Datenaustausch mit der CPU vergleichsweise gering ist. Beim Laden von LLMs und bei der Übertragung großer Datenmengen verlängert das langsame PCIe jedoch die Wartezeit.
Experimentelle Modifikationen ermöglichen den Betrieb der Schnittstelle im Modus PCIe Gen2 x4. Seine theoretische Bandbreite beträgt etwa 2 GB/s in jede Richtung. Im Testsystem erreichte die gemessene Übertragungsgeschwindigkeit nach der Modifikation etwa 1,7 GB/s.
Wenn das Modell vollständig in den VRAM passt, kann die Geschwindigkeit der Token-Generierung vergleichsweise wenig vom PCIe abhängen. Beim Auslagern von Layern zwischen RAM und GPU wird der Einfluss der Schnittstelle deutlich größer.
Mining-Leistung
Die CMP 50HX war ursprünglich für das Mining von Ethereum mit dem Ethash-Algorithmus vorgesehen. NVIDIA nannte für die CMP-Familie folgende Werte:
| Grafikkarte | Ethash | Leistungsaufnahme |
|---|---|---|
| CMP 30HX | 26 MH/s | 125 W |
| CMP 40HX | 36 MH/s | 185 W |
| CMP 50HX | 45 MH/s | 250 W |
| CMP 90HX | 86 MH/s | 320 W |
Angegebene Spezifikationen der NVIDIA-Referenzlösungen unter den Bedingungen des Jahres 2021.
Die CMP 50HX bot eine um 25 % höhere Hashrate als die CMP 40HX. Nach dem Wechsel von Ethereum zu Proof of Stake im September 2022 kam das Mining von ETH mit Grafikkarten jedoch zum Erliegen.
Die Verwendung der CMP 50HX für andere Algorithmen ist möglich, ihre Wirtschaftlichkeit hängt jedoch von der Netzwerkschwierigkeit und den Stromkosten ab.
Eignet sich die CMP 50HX zum Spielen?
Trotz ihrer Verwandtschaft mit der RTX 2080 Ti ist die CMP 50HX nicht für Spiele vorgesehen.
Die Karte besitzt keine Videoausgänge, und die Standardkonfiguration schränkt die Grafikfunktionen ein. Modifizierte Treiber ermöglichen zwar die Ausführung einzelner Anwendungen, garantieren jedoch keine Kompatibilität mit Spielen.
Auch nach der Freischaltung der Rechenoperationen bleiben Einschränkungen der Grafikpipeline bestehen. Daher lässt sich die Leistung der RTX 2080 Ti nicht automatisch auf die CMP 50HX übertragen.
Lohnt sich der Kauf einer NVIDIA CMP 50HX im Jahr 2026?
Die CMP 50HX ist für Experimente mit CUDA, lokalen LLMs und GPU-Modifikationen interessant. Zu ihren wichtigsten Vorteilen zählen 10 GB GDDR6, ein breiter Speicherbus und die Möglichkeit, die Rechenleistung wiederherzustellen.
Für ein gewöhnliches Arbeitssystem bleiben jedoch Einschränkungen bestehen: nicht standardmäßige Treiber, langsames PCIe und fehlende Videoausgänge.
Für lokale neuronale Netze bleibt die GeForce RTX 3060 12 GB eine vielseitigere Alternative. Sie bietet mehr Videospeicher, vollständige CUDA-Unterstützung und eine standardmäßige PCIe-Schnittstelle.
Die CMP 50HX ist dann eine Überlegung wert, wenn sie deutlich günstiger als eine RTX 3060 ist und man bereit ist, die Software selbst einzurichten. Für einen stabilen Betrieb ohne Modifikationen ist eine gewöhnliche GeForce vorzuziehen.
Fazit: Die NVIDIA CMP 50HX ist ein spezialisierter Beschleuniger auf Basis der TU102 mit 10 GB GDDR6. Die experimentelle Freischaltung im Jahr 2026 zeigte einen Anstieg der FP32-Leistung um das 31,7-Fache und der DP4A-Leistung um das 28,4-Fache, ihr Einfluss auf reale LLMs erfordert jedoch noch separate Messungen. Die Karte ist für Rechenexperimente interessant, stellt aber keinen vollwertigen Ersatz für eine GeForce dar.
GPU-Vergleich
CMP 50HX mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs


In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/de/gpu/nvidia-cmp-50hx" target="_blank">NVIDIA CMP 50HX</a>