NVIDIA T1000

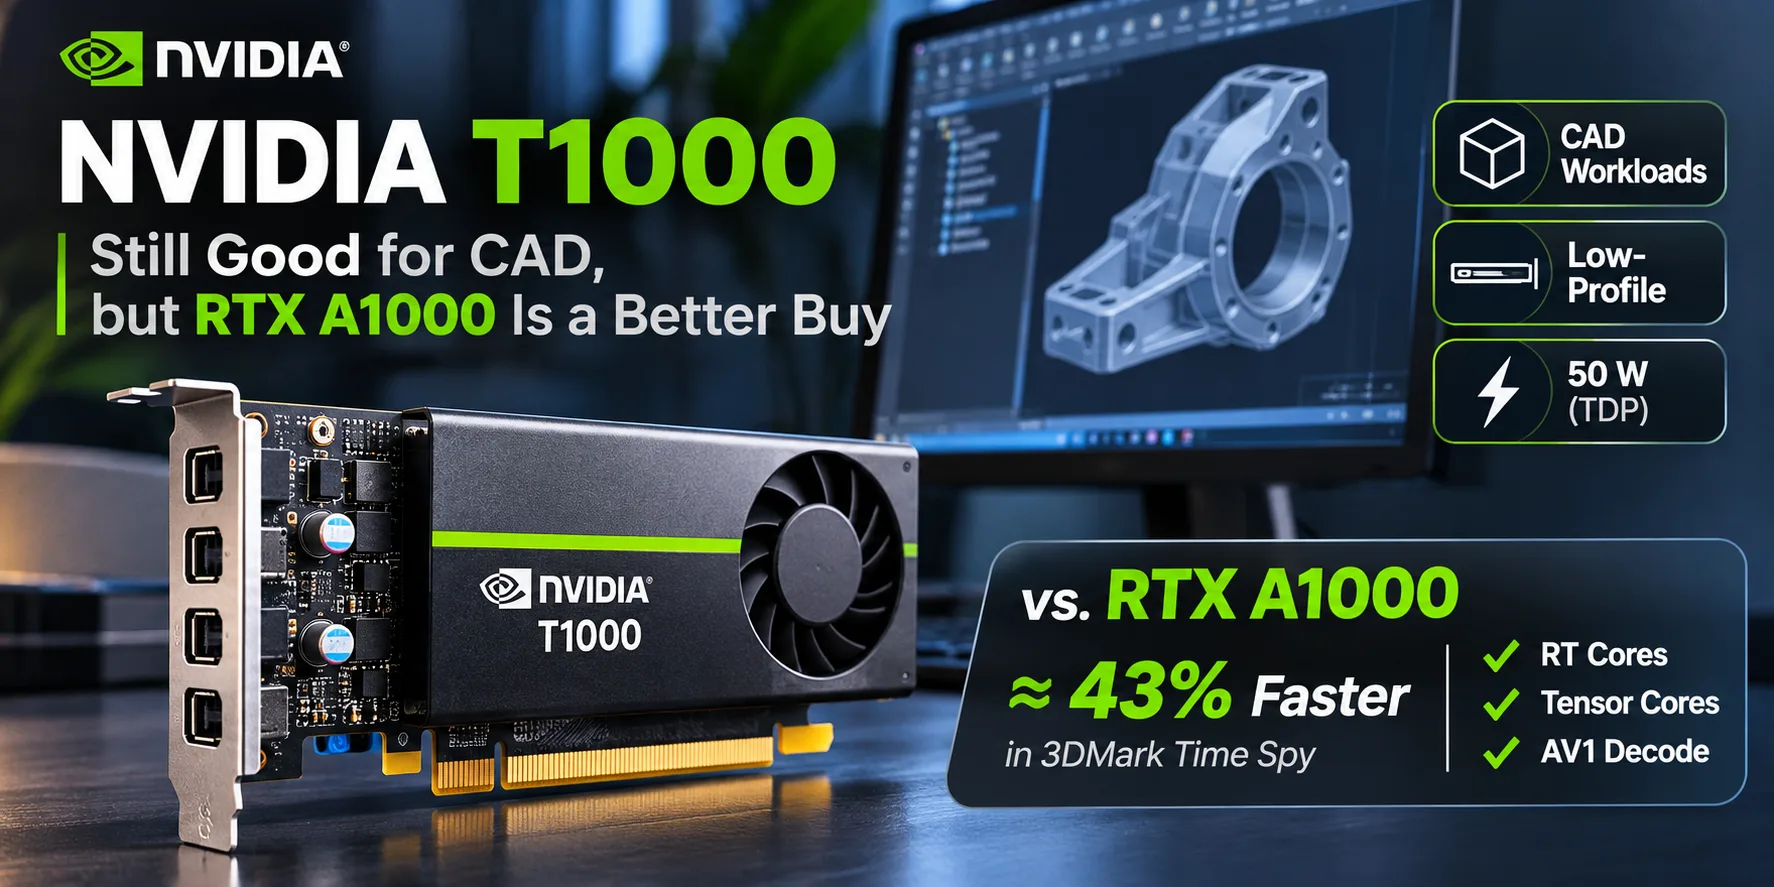
NVIDIA T1000: todavía sirve para CAD, pero la RTX A1000 es más rentable
La NVIDIA T1000 es una tarjeta gráfica profesional de 2021 para estaciones de trabajo compactas. Está basada en el mismo chip TU117 que la GeForce GTX 1650. Sin embargo, la T1000 no está pensada para jugar, sino para trabajar con aplicaciones CAD: dispone de controladores profesionales y certificación para determinadas versiones de software de ingeniería. La tarjeta ocupa una sola ranura, consume hasta 50 W y no necesita alimentación adicional. La principal duda hoy es si merece la pena comprarla nueva cuando existe la RTX A1000.
| Modelo | Núcleos CUDA | Ancho de banda | Núcleos RT / Tensor | Decodificación AV1 |
|---|---|---|---|---|
| NVIDIA T1000 8 GB | 896 | 160 GB/s | No / no | No |
| NVIDIA RTX A1000 8 GB | 2304 | 192 GB/s | 18 / 72 | Sí |
Para qué tareas sirve la T1000
La T1000 se comercializa con 4 y 8 GB de GDDR6 en un bus de 128 bits. Ambas versiones cuentan con los mismos 896 núcleos CUDA, un rendimiento FP32 de hasta 2,5 TFLOPS y una interfaz PCIe 3.0 x16. La tarjeta de perfil bajo y una sola ranura incorpora cuatro Mini DisplayPort 1.4, por lo que permite conectar cuatro monitores 5K a 60 Hz.
En AutoCAD, Inventor y SolidWorks, la tarjeta es adecuada para planos 2D, piezas individuales y ensamblajes 3D pequeños. En modelos complejos son importantes el tamaño del proyecto, las capacidades del procesador y la cantidad de memoria de vídeo. Por eso, entre las dos versiones de la T1000, resulta más razonable elegir la de 8 GB: la versión de 4 GB ofrece menos margen de memoria. Sin embargo, con la misma carga de GPU, esos 4 GB adicionales no aceleran por sí solos los cálculos.
La T1000 es compatible con CUDA y puede renderizar escenas en Blender. Sin embargo, el chip TU117 no tiene núcleos RT ni Tensor por hardware. En tareas de trazado de rayos queda claramente por detrás de las RTX más nuevas, y no ofrece DLSS ni decodificación AV1 por hardware.
Rendimiento: T1000 frente a RTX A1000
En 3DMark Time Spy Graphics, la RTX A1000 de sobremesa supera a la T1000 aproximadamente en un 43 %. Para la comparación se utilizaron resultados medianos de una única base de datos recopilatoria, no pruebas de las dos tarjetas instaladas en el mismo PC.
| Tarjeta gráfica | 3DMark Time Spy Graphics |
|---|---|
| NVIDIA T1000 | 3084 |
| NVIDIA RTX A1000 | 4396 |
Una prueba independiente de la T1000 en una Lenovo ThinkStation P3 Tiny con Core i9-14900 y 64 GB de RAM obtuvo unos resultados similares: 3088 puntos. En este benchmark, el nivel de rendimiento es comparable al de la Radeon 890M integrada, pero para aplicaciones CAD esta cifra no sustituye a las pruebas especializadas.
En Blender 3.3, en la misma ThinkStation, la escena Classroom se renderizó en 159 segundos, tanto al utilizar CUDA como mediante OptiX. Sin núcleos RT, la T1000 no obtiene la aceleración en trazado de rayos disponible en las tarjetas gráficas RTX.
En juegos, la T1000 se acerca a la GeForce GTX 1650. A 1920 × 1080, en la ThinkStation de prueba se obtuvieron 45,1 FPS en Cyberpunk 2077 (Low, FSR desactivado) y 82,6 FPS en F1 24 (Medium, TAA). Es un nivel suficiente para juegos poco exigentes, pero no un motivo para comprar una tarjeta profesional en lugar de una orientada a juegos.
Resultados en estaciones de trabajo
StorageReview probó la T1000 en dos equipos preensamblados. En SPECviewperf 2020, los resultados varían en función de la aplicación:
| Estación de trabajo | CPU | GPU | SolidWorks | Siemens NX | Creo |
|---|---|---|---|---|---|
| Lenovo ThinkStation P3 Tiny | Core i7-14700 | T1000 8 GB | 39,28 | 165,51 | 42,71 |
| HP Z2 G8 Tower | Core i7-11700 | T1000 4 GB | 16,92 | 97,8 | 41,62 |
SPECviewperf 2020, puntos; cuanto más alto, mejor. En el análisis de Lenovo se indica una resolución del sistema de 3840 × 2160; para las pruebas de HP, 3800 × 2120. No se ha confirmado que la configuración de SPECviewperf y los controladores sean idénticos, por lo que no es una comparación directa de las dos variantes de la T1000.
En Creo, los valores son casi idénticos, mientras que en SolidWorks y Siemens NX las diferencias son mucho mayores. También son distintos el CPU, la cantidad de memoria de vídeo y, posiblemente, la configuración de la prueba y los controladores. Estos resultados no demuestran que pasar de 4 a 8 GB proporcione un aumento equivalente. Antes de comprar una estación de trabajo, es más útil comprobar el rendimiento en el paquete CAD utilizado y la certificación para su versión.
Precios y alternativas
En las ofertas comprobadas el 11 de noviembre de 2026, la PNY T1000 8 GB nueva aparece por $449, mientras que la PNY RTX A1000 8 GB cuesta $550. Con esos precios, la diferencia es de unos $100. A cambio, el comprador obtiene una GPU más rápida, núcleos RT y Tensor por hardware y compatibilidad con la decodificación AV1. Además, la RTX A1000 también consume hasta 50 W, ocupa una sola ranura de perfil bajo y dispone de cuatro Mini DisplayPort.
Para otras tareas, existen las siguientes alternativas:
- Intel Arc Pro B50 16 GB: ofrece el doble de memoria de vídeo, un consumo de 70 W y un formato de perfil bajo, pero es una tarjeta de doble ranura. En la oferta consultada de Newegg cuesta alrededor de $700, por lo que no es más barata que la RTX A1000. Tiene sentido elegirla por sus 16 GB y siempre que se haya confirmado la compatibilidad con el software necesario.
- GeForce RTX 3050 6 GB: una opción para gráficos generales, juegos y CUDA cuando no se necesitan controladores profesionales certificados. Algunas variantes de perfil bajo ocupan dos ranuras.
- Radeon 890M: gráficos integrados de un nivel similar en Time Spy. Para trabajo ofimático y gráficos poco exigentes, puede que no haga falta una T1000 dedicada, pero los resultados en aplicaciones CAD y la compatibilidad de los controladores serán diferentes.
Conclusión
La T1000 sigue siendo adecuada para estaciones de trabajo compactas que necesitan una sola ranura, cuatro salidas de vídeo y controladores profesionales. En diseño 2D y ensamblajes 3D pequeños continúa siendo una solución viable; entre las dos versiones, es preferible la de 8 GB.
Es difícil recomendar una T1000 nueva por $449 cuando existe una RTX A1000 por $550. En los resultados de Time Spy indicados, esta última es aproximadamente un 43 % más rápida y se adapta mejor al renderizado por GPU, sin requerir espacio ni potencia adicionales. Comprar la T1000 está justificado si una configuración concreta de estación de trabajo es notablemente más barata o si ya se ha comprobado su compatibilidad y esta tiene prioridad sobre el rendimiento.
Comparación de GPU
Comparar T1000 con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Comparaciones de GPU relacionadas

Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/index.php/es/gpu/nvidia-t1000" target="_blank">NVIDIA T1000</a>