NVIDIA Tesla P100 SXM2

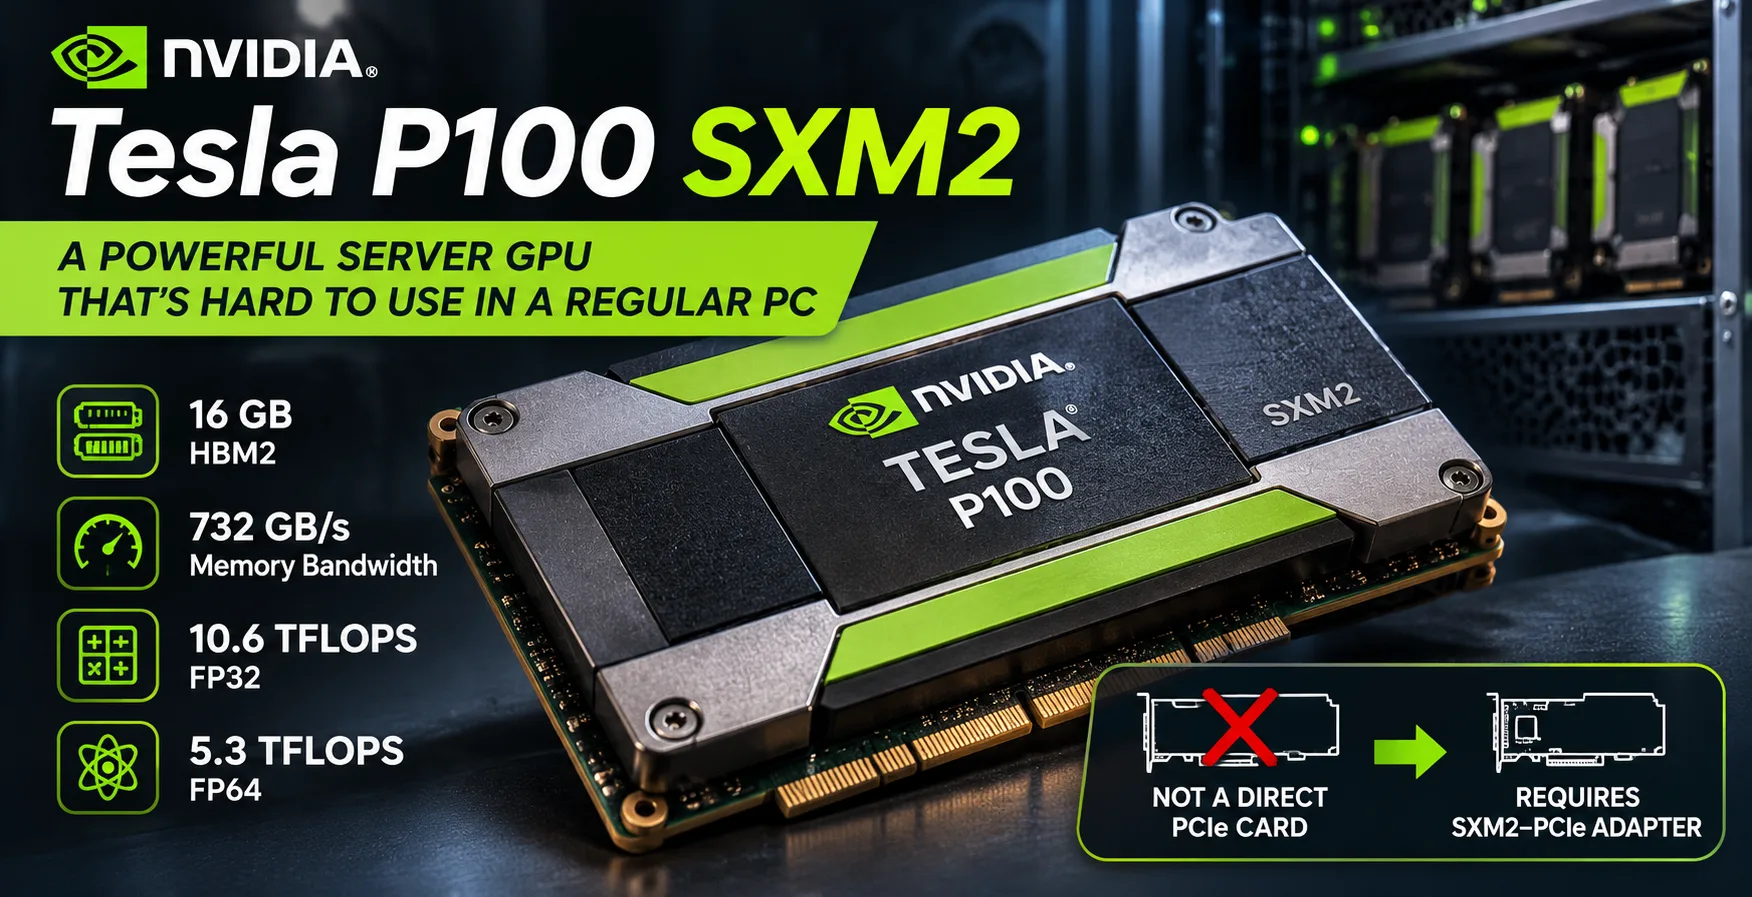
NVIDIA Tesla P100 SXM2: una GPU de servidor barata y difícil de instalar en un PC convencional
La NVIDIA Tesla P100 SXM2 atrae a los entusiastas por combinar 16 GB de memoria HBM2, un alto rendimiento en FP64 y un precio bajo en el mercado de segunda mano. Sin embargo, este acelerador de 2016 tiene un inconveniente importante: en lugar de un PCIe estándar, utiliza el conector de servidor SXM2. Para instalarlo en un ordenador convencional se necesitan un adaptador, un sistema de refrigeración independiente y una comprobación de compatibilidad. Como resultado, el módulo barato puede acabar costando más que la versión PCIe, que es más fácil de utilizar.
Por qué es difícil conectar SXM2 a un PC convencional
La Tesla P100 SXM2 se diseñó para servidores especializados, incluidos los sistemas NVIDIA DGX. No tiene un conector PCIe estándar y no se puede instalar directamente en la ranura de la placa base.
En el mercado de segunda mano hay adaptadores SXM2-PCIe, pero disponer de un conector adecuado no garantiza que el sistema funcione. Antes de comprar es necesario resolver varias cuestiones:
- Alimentación. El acelerador consume hasta 300 W. El adaptador debe proporcionar la alimentación necesaria al módulo.
- Refrigeración. SXM2 está diseñado para un sistema de refrigeración de servidor. En una caja convencional se necesita un disipador compatible con un flujo de aire suficientemente potente.
- Compatibilidad. Hay que comprobar la compatibilidad del módulo concreto con el adaptador, la placa base y el controlador.
- Ausencia de salidas de vídeo. La Tesla P100 no está diseñada para conectar directamente un monitor.
Los gastos adicionales pueden eliminar por completo la ventaja de la compra. Según una estimación del mercado estadounidense de segunda mano correspondiente a agosto de 2026, los módulos P100 SXM2 funcionales se vendían por aproximadamente $47-60. Mientras tanto, uno de los adaptadores SXM2-PCIe que anunciaba compatibilidad con P100 se ofrecía en septiembre por aproximadamente $109, sin contar los gastos adicionales de refrigeración y envío.
En un ejemplo así, el precio del adaptador casi duplica el del propio acelerador. Por eso, no tiene sentido valorar la compra de una SXM2 basándose únicamente en el precio del módulo.
Diferencias entre Tesla P100 SXM2 y P100 PCIe
Ambas versiones están basadas en la misma GPU GP100 de arquitectura Pascal. Las dos tienen 3584 núcleos CUDA, mientras que las variantes con 16 GB de HBM2 ofrecen el mismo ancho de banda de memoria: 732 GB/s.
Las principales diferencias están relacionadas con las frecuencias, la alimentación y la conexión.
| Característica | Tesla P100 SXM2 | Tesla P100 PCIe 16 GB |
|---|---|---|
| Conexión | SXM2 | PCIe 3.0 x16 |
| Frecuencia base | 1328 MHz | 1126 MHz |
| Frecuencia Boost | 1480 MHz | 1303 MHz |
| Interconexión de la GPU | NVLink, hasta 160 GB/s | PCIe 3.0 |
| Potencia máxima | 300 W | 250 W |
Las frecuencias más altas proporcionan a la SXM2 una ventaja de aproximadamente el 14 % en rendimiento computacional teórico FP32. Sin embargo, su potencia máxima es 50 W superior.
Otra ventaja de la SXM2 es NVLink, que permite a los aceleradores intercambiar datos entre sí. Esta función resulta útil en servidores multiprocesador compatibles. Al instalarla mediante un adaptador PCIe convencional, se pierde la ventaja de NVLink.
Para un acelerador individual en un PC de sobremesa, las ventajas de la SXM2 frente a la PCIe son relativamente pequeñas.
Rendimiento y benchmarks
La GP100 se diferencia de la mayoría de las GPU de consumo por su alta velocidad de cálculo en doble precisión FP64. En la Tesla P100 SXM2 alcanza 5,3 TFLOPS, lo que hace que el acelerador sea adecuado para cálculos científicos y modelado numérico.
Para la comparación se han utilizado resultados de Geekbench 7 OpenCL y el rendimiento computacional teórico de varias tarjetas gráficas concretas.
| Tarjeta gráfica | Geekbench 7 OpenCL | FP32, TFLOPS | FP64, TFLOPS |
|---|---|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 | 15,7 | 7,8 |
| NVIDIA GeForce RTX 3060 | 88 251 | 12,7 | 0,20 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 | 10,6 | 5,3 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 | 9,3 | 4,7 |
| NVIDIA Tesla T4 16 GB | 61 276 | 8,1 | ~0,25 |
Geekbench 7 OpenCL: resultados de la clasificación pública de Geekbench de octubre de 2026; una puntuación más alta es mejor. FP32 y FP64 son indicadores teóricos, no resultados de Geekbench. Se incluyen para comparar las capacidades de cálculo de las arquitecturas.
En Geekbench, la P100 SXM2 obtiene aproximadamente un 22 % más de puntos que la versión PCIe de 16 GB. La diferencia es más notable de lo que sugieren las especificaciones oficiales, pero los resultados se obtuvieron en sistemas diferentes y no permiten considerar garantizado ese aumento.
La situación con la GeForce RTX 3060 es más interesante. Sus puntuaciones de Geekbench son prácticamente idénticas, pero en FP64 la Tesla de servidor supera teóricamente a la RTX 3060 en más de 26 veces. La razón es la configuración especializada de las unidades de cálculo de la GP100, diseñada también para tareas científicas.
No obstante, unos resultados similares en OpenCL no significan que el rendimiento sea equivalente en juegos, renderizado o redes neuronales.
La Tesla V100 SXM2 es notablemente más rápida que la P100 gracias a la arquitectura Volta, al mayor número de unidades de cálculo y al mayor ancho de banda de memoria. Además, la V100 incorpora Tensor Cores, que no están presentes en Pascal.
Para qué tareas sigue siendo adecuada la P100 SXM2
A pesar de su antigüedad, la GP100 no puede considerarse inútil. Todavía ofrece ventajas en tareas capaces de aprovechar las características de la arquitectura:
- Cálculos científicos y modelado con un uso intensivo de FP64.
- Cálculos CUDA con software compatible.
- Procesamiento de conjuntos de datos para el que resulta útil el alto ancho de banda de la HBM2.
- Experimentos con GPU de servidor y configuraciones multiprocesador NVLink.
En operaciones FP16, la P100 SXM2 alcanza 21,2 TFLOPS teóricos. Sin embargo, esta cifra no debe compararse directamente con el rendimiento de los Tensor Cores de aceleradores más modernos. Las diferencias de arquitectura y del conjunto de operaciones compatibles son demasiado grandes.
Modelos de lenguaje locales y limitaciones de CUDA en 2026
La presencia de 16 GB de memoria de vídeo hace que la P100 resulte atractiva para ejecutar modelos de lenguaje localmente. Por ejemplo, los modelos cuantizados de 7-8 mil millones de parámetros pueden alojarse por completo en la memoria del acelerador con la configuración adecuada.
Pero la cantidad de memoria es solo una de las características que determinan la comodidad de uso de los LLM.
La GP100 pertenece a la arquitectura Pascal, con una capacidad de cómputo CUDA de 6.0. La última versión de CUDA Toolkit compatible con la compilación de programas para Pascal es la 12.9. En CUDA 13 se dejó de admitir esta arquitectura al compilar nuevas aplicaciones. La última rama de controladores de NVIDIA compatible con Pascal es la R580.
Esto no significa que los programas antiguos hayan dejado de funcionar de repente. Sin embargo, las nuevas versiones de las bibliotecas de aprendizaje automático pueden exigir una arquitectura más moderna. Para ejecutar algunos modelos es necesario instalar versiones antiguas del software o compilar por cuenta propia componentes compatibles.
La ausencia de Tensor Cores limita la velocidad de los cálculos modernos de redes neuronales. Por eso, la P100 SXM2, pese a sus 16 GB de HBM2, no tiene por qué ser más rápida que una RTX de consumo con menos memoria.
Para los LLM locales, es más importante comprobar la compatibilidad con el modelo concreto y el entorno de software que fijarse en las cifras de FP16 o en el ancho de banda de memoria.
¿Vale la pena comprar una Tesla P100 SXM2 en 2026?
Si ya se dispone de un servidor con conectores SXM2 compatibles, la Tesla P100 sigue siendo adecuada para cálculos FP64 y para trabajar con software CUDA antiguo. Su bajo precio en el mercado de segunda mano la hace atractiva para este tipo de sistemas.
En un ordenador de sobremesa convencional, la situación es distinta. El aumento de rendimiento frente a la P100 PCIe es pequeño, mientras que los gastos del adaptador, la refrigeración y la alimentación pueden superar el precio del propio acelerador.
Para experimentar con LLM locales, resulta más cómodo utilizar una GeForce RTX más moderna, con Tensor Cores y compatibilidad con el software actual. Si se necesita específicamente la arquitectura GP100, la versión PCIe de 16 GB evita tener que buscar un adaptador SXM2, aunque también requiere un flujo de aire potente y dirigido.
Conclusión: la Tesla P100 SXM2 sigue siendo un acelerador FP64 de buen rendimiento, pero es una mala candidata para montar un PC convencional económico. Su compra está justificada si se dispone de hardware compatible o si se quiere realizar un experimento técnico. Ahorrar en la compra del módulo para después pagar de más por conectarlo normalmente no resulta rentable.
Comparación de GPU
Comparar Tesla P100 SXM2 con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Comparaciones de GPU relacionadas

Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/es/gpu/nvidia-tesla-p100-sxm2" target="_blank">NVIDIA Tesla P100 SXM2</a>