AMD Instinct MI455X
AMD Instinct MI455X - 432 GB HBM4 и первые результаты в DeepSeek-R1
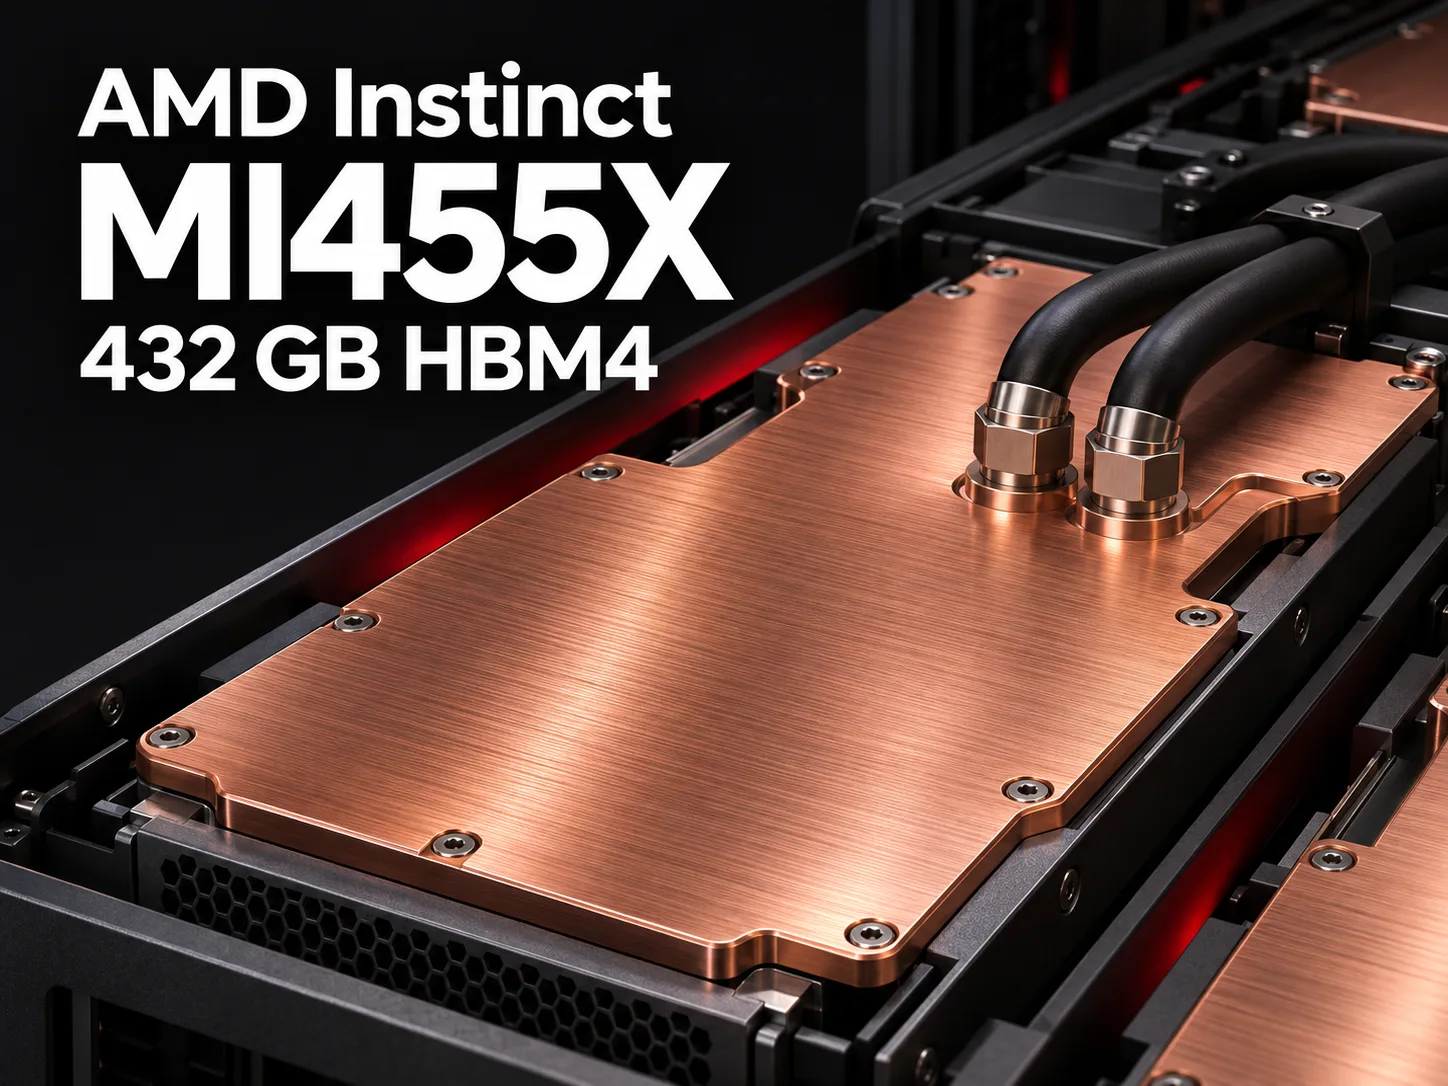
23 июля 2026 года AMD представила Instinct MI455X в составе Helios - серверной стойки для обучения и запуска нейросетей. MI455X выполнен в виде модуля с прямым жидкостным охлаждением. На одном таком ускорителе установлено 432 GB памяти HBM4, а в полной стойке из 72 GPU её суммарная ёмкость достигает примерно 31 TB.
В ноябре AMD сообщила, что система Helios на DeepSeek-R1 выдала 21 333 токена/с в пересчёте на MI455X. 12 ноября компания сравнила этот показатель с результатом NVIDIA Vera Rubin и объявила о преимуществе до 30%. Четыре дня спустя Nebius опубликовала новый результат Vera Rubin на той же модели - уже более 22 000 токенов/с в среднем на GPU.
Чем MI455X отличается от MI450X
Оба ускорителя для Helios построены на архитектуре CDNA 5. AMD указывает одинаковую пиковую пропускную способность памяти - 23,3 TB/s. Совпадают и пиковые показатели вычислений, в том числе 40,3 PFLOPS в формате MXFP4. Главное различие между моделями - сколько данных помещается в локальной памяти каждого GPU.
| Ускоритель | Память HBM4 на GPU | Число стеков HBM4 |
|---|---|---|
| AMD Instinct MI455X | 432 GB | 12 |
| AMD Instinct MI450X | 288 GB | 8 |
Дополнительные 144 GB особенно полезны, когда весам модели немного не хватает памяти одного ускорителя. Если удаётся разместить всю копию на MI455X, сервер может выполнять запросы к ней без обмена промежуточными результатами между GPU. Другой способ использовать запас памяти - выделить больше места под кеш для длинных диалогов.
Поместится ли DeepSeek-R1 в 432 GB
Основная модель DeepSeek-R1 содержит около 671 млрд параметров без дополнительного модуля предсказания токенов. При генерации одного токена модель задействует около 37 млрд параметров, но для следующего токена может выбрать других экспертов. При загрузке модели целиком нужны веса всех экспертов.
- При идеальной упаковке по четыре бита на параметр веса занимают около 335,5 GB (312,5 GiB). Это теоретический минимум без служебных данных.
- В формате MXFP4 у каждой группы из 32 значений есть байт общего масштаба. Если в этом формате хранить все параметры, расчётный объём возрастёт до 356,5 GB (332 GiB).
- Для одного запроса с контекстом 131 072 токена компактный MLA-кеш DeepSeek-R1 в формате BF16 занимает ещё около 9,2 GB. Это оценка по конфигурации модели без учёта рабочих буферов и накладных расходов программы.
По этим расчётам четырёхбитные веса помещаются в номинальную память одного MI455X и превышают ёмкость одного MI450X. Сколько длинных запросов сможет обслужить MI455X одновременно, зависит от фактического формата весов и кеша. AMD не раскрыла конфигурацию своего запуска достаточно подробно, чтобы связать результат 21 333 токена/с с размещением модели на одном GPU.
DeepSeek-R1 на MI455X, MI355X и NVIDIA Vera Rubin
В сценарии MLPerf Inference Offline система получает все запросы сразу. Тест измеряет суммарную скорость генерации по всем запросам. В последнем столбце для публичных результатов MLPerf приведена скорость системы, делённая на число ускорителей. Для MI455X показатель на GPU сообщила сама AMD.
| Система | Источник результата Offline | Число GPU | Токенов/с на систему | Токенов/с на GPU |
|---|---|---|---|---|
| AMD Helios, Instinct MI455X | Лаборатория AMD, ноябрь | Не указано | - | 21 333 |
| NVIDIA Vera Rubin NVL72 | MLPerf v6.1, сентябрь, Preview | 72 | 1 183 327 | 16 435 |
| Nebius, NVIDIA Vera Rubin NVL72 | MLPerf v6.1, ноябрь, Available | 72 | 1 586 667 | 22 037 |
| Crusoe, AMD Instinct MI355X | MLPerf v6.1, сентябрь | 512 | 2 901 950 | 5 668 |
Для своего сравнения AMD взяла сентябрьский результат Vera Rubin. Относительно него показатель MI455X действительно выше примерно на 30%. В ноябрьской публикации Nebius среднее на один Rubin уже на 3,3% выше цифры AMD. Обе разницы относятся к конкретным системам. Результат MI455X получен во внутреннем тесте, который не проходил проверку MLCommons. AMD не указала число ускорителей и точность вычислений.
Для интерактивного сервиса остаётся ещё один вопрос - сколько запросов система выдерживает при ограничении времени ответа. В сценарии Server ноябрьская стойка Nebius показала 1 752 403 токена/с. Для MI455X в ноябрьском сообщении AMD есть только Offline, поэтому сравнить задержку ответа двух систем по этим публикациям нельзя.
Для каких задач нужен MI455X
Наиболее понятный случай для MI455X - модель, которой тесно в 288 GB на GPU. Дополнительная память может сократить число ускорителей на одну копию или позволить серверу одновременно вести больше длинных диалогов. Если та же нагрузка помещается на MI450X, у старшей модели нет паспортного преимущества в пропускной способности HBM4. Тогда выбор зависит от измеренной скорости и стоимости всей конфигурации при нужной длине контекста и допустимом времени до первого токена.
Сравнение GPU
Сравнить Instinct MI455X с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Функции ИИ
Межсоединения и масштабируемость
Другое
Бенчмарки
По сравнению с другими GPU
Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/ru/gpu/amd-instinct-mi455x" target="_blank">AMD Instinct MI455X</a>