NVIDIA Tesla V100 SXM3 32 GB
Tesla V100 SXM3 32 GB: más potente que la SXM2, pero mucho más difícil de utilizar
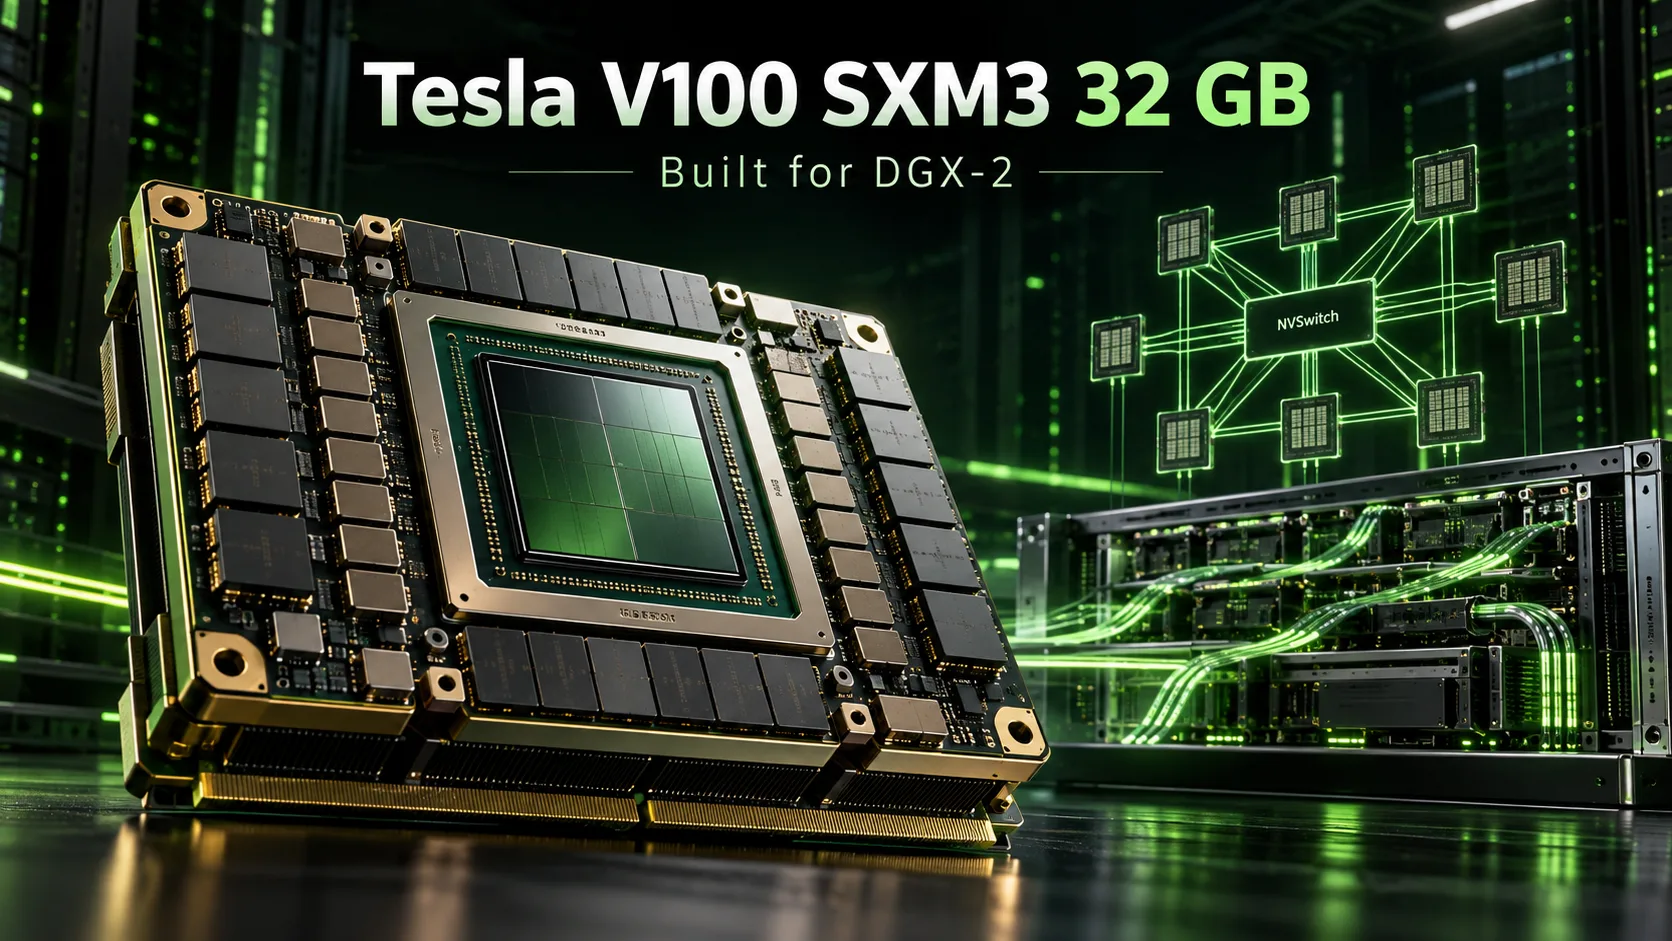
La Tesla V100 SXM3 32 GB es un módulo de cómputo de NVIDIA para el supercomputador DGX-2 y los servidores basados en la plataforma HGX-2. NVIDIA presentó el DGX-2 en marzo de 2018. El sistema se basaba en 16 aceleradores con arquitectura Volta, conectados mediante conmutadores NVSwitch. Frente a la V100 SXM2 convencional, la nueva versión se distinguía por sus frecuencias más altas, un mayor ancho de banda de memoria y un límite de potencia de 350 W.
La SXM3 supera a la SXM2 en especificaciones, pero resulta mucho menos adecuada para montajes independientes. El módulo utiliza un conector especial y requiere una fuente de alimentación y un sistema de refrigeración compatibles, mientras que su funcionamiento fuera de una plataforma de servidor prácticamente no se ha comprobado. Incluso si fuera posible conectar una SXM3 a un ordenador convencional, la pequeña ventaja de rendimiento difícilmente justificaría el coste.
Posición en la gama
| Modelo | Memoria | Ancho de banda | Boost | Potencia |
|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W |
| Tesla V100 SXM3 32 GB | 32 GB HBM2 | 981 GB/s | 1597 MHz | 350 W |
| Tesla V100 SXM3 32 GB H | 32 GB HBM2 | 1134 GB/s | 1702 MHz | 450 W |
Las cuatro versiones utilizan el mismo chip GV100, con 5120 núcleos CUDA y 640 núcleos tensoriales. La diferencia está en las frecuencias, la configuración de alimentación y el método de conexión.
La SXM3 estándar alcanza aproximadamente 16,4 TFLOPS en FP32 y 8,2 TFLOPS en FP64. Su ancho de banda de memoria es un 9 % superior al de la SXM2, mientras que la frecuencia de la GPU aumenta aproximadamente un 4 %. Estas diferencias dan ventaja a la SXM3 en los cálculos y las tareas limitadas por el ancho de banda de memoria, aunque la mejora real depende de la carga de trabajo.
Para el DGX-2H, NVIDIA preparó una variante SXM3-H más potente. Su límite de potencia aumenta hasta 450 W y el ancho de banda de memoria alcanza 1134 GB/s. Es la versión más rápida de la V100 en formato SXM.
DGX-2 y NVSwitch
La principal novedad del DGX-2 no fue el aumento de la frecuencia de la GPU, sino la forma de interconectarlas.
En el DGX-1, ocho aceleradores SXM2 se conectaban directamente mediante NVLink. La topología limitaba el intercambio de datos entre determinados pares de GPU. En el DGX-2, dieciséis módulos SXM3 se conectaban a doce conmutadores NVSwitch, lo que proporcionaba comunicación de alta velocidad entre todos los aceleradores.
El sistema tenía un total de 512 GB de memoria HBM2. Cada GPU podía acceder a la memoria de las demás, pero esto no convertía los dieciséis aceleradores en una sola GPU con un búfer local compartido. La latencia de acceso a la memoria remota seguía siendo mayor y las aplicaciones necesitaban admitir computación distribuida.
El ancho de banda de la interconexión entre las dos mitades del sistema alcanzaba 2,4 TB/s. Para entrenar redes neuronales grandes, esto era más importante que el pequeño aumento de frecuencia de cada módulo.
El DGX-2 ofrecía alrededor de 2 PFLOPS en los núcleos tensoriales, consumía hasta 10 kW y costaba $399 000 en su lanzamiento. NVIDIA siguió desarrollando la arquitectura con NVSwitch en las generaciones posteriores de DGX, incluido el DGX A100.
Rendimiento en tareas actuales
Prácticamente no existen pruebas independientes de la V100 SXM3 en modelos de lenguaje actuales. La mayoría de los resultados disponibles se han obtenido con las versiones SXM2 y PCIe, por lo que todavía no es posible determinar con precisión la ventaja de la SXM3 en la generación de texto.
Como referencia, una Tesla V100 SXM2 32 GB alcanza alrededor de 32 tokens/s al generar con Qwen3.6-27B en formato Q4_K_M mediante llama.cpp. Se trata del resultado de una sola tarjeta gráfica, no de un sistema con varias GPU.
La SXM3 dispone de un 9 % más de ancho de banda de memoria, por lo que en teoría podría ser más rápida durante la generación. Sin embargo, no sería correcto trasladar directamente ese porcentaje a la velocidad de generación de tokens. El resultado depende de la cuantización, el tamaño del contexto, el motor de software y las características del modelo.
En las tareas FP32 y FP64, las frecuencias más altas también ofrecen una ventaja. No obstante, la arquitectura Volta queda por detrás de los aceleradores más recientes en cuanto al conjunto de formatos de cálculo compatibles.
Principales limitaciones de software:
- CUDA: la arquitectura de cómputo sm_70 es compatible hasta CUDA 12.9. A partir de CUDA 13, ya no se pueden compilar nuevos kernels de GPU para Volta.
- Controladores: R580 es la última rama de NVIDIA con compatibilidad para Volta.
- BF16: no existe compatibilidad de hardware, lo que limita la compatibilidad con las herramientas modernas para entrenar redes neuronales.
- FlashAttention 2: la implementación oficial no es compatible con Volta. Es necesario utilizar otros mecanismos de atención.
La V100 todavía puede trabajar con LLM locales, pero para ejecutar modelos y bibliotecas nuevos a veces se necesitan compilaciones especiales.
¿Se puede utilizar una SXM3 en un ordenador convencional?
A diferencia de una tarjeta PCIe, el módulo SXM3 no se instala directamente en una ranura de la placa base. Está diseñado para placas de servidor especializadas con el conector, el sistema de alimentación y la refrigeración correspondientes.
En el mercado de segunda mano aparecen anuncios de adaptadores de SXM3 a PCIe por unos $200-300. Sin embargo, algunos incluyen números de pieza correspondientes a la SXM2. No hay suficientes confirmaciones independientes de que los módulos SXM3 auténticos funcionen de forma estable con esos adaptadores.
Antes de comprar, es necesario comprobar lo siguiente:
- Si la placa es compatible específicamente con SXM3 y no con SXM2.
- Si el sistema de alimentación soporta una carga de hasta 350 W.
- Cómo está organizada la refrigeración del módulo.
- Si el controlador de NVIDIA detecta la GPU y si esta supera una prueba de carga prolongada.
Una simple fotografía de la placa o la afirmación del vendedor sobre la compatibilidad no son suficientes. Es recomendable obtener resultados de nvidia-smi, una prueba de CUDA y una confirmación del funcionamiento estable específicamente con una V100 SXM3.
En un DGX-2 o un HGX-2 estos problemas no existen. Sin embargo, resulta difícil justificar la compra de un servidor completo por varios aceleradores obsoletos. El DGX-2 está diseñado para una infraestructura potente de alimentación y refrigeración, y su eficiencia energética es inferior a la de los sistemas modernos basados en A100 y GPU más recientes.
Alternativas
Tesla V100 SXM2 32 GB. Es la alternativa más cercana, con la misma cantidad de memoria. En el mercado de segunda mano se han visto unidades por unos $450-700, aunque las ofertas actuales pueden ser bastante más caras. Para la SXM2 existen adaptadores a PCIe y tarjetas modificadas ya preparadas con refrigeración. Aun así, hay que tener en cuenta el coste del adaptador y la calidad de la modificación.
Tesla V100 PCIe 32 GB. Es una opción más sencilla para un servidor compatible con PCIe. Como referencia, las transacciones completadas se sitúan aproximadamente en $650-850, aunque en otoño de 2026 muchos anuncios parten de $850. La tarjeta es inferior a la SXM3 en frecuencia y ancho de banda de memoria, pero no requiere placas SXM especiales. Aun así, necesita una alimentación adecuada y refrigeración activa.
Conclusión
La Tesla V100 SXM3 32 GB supera a la SXM2 en frecuencia y ancho de banda de memoria, pero sus ventajas se pierden casi por completo debido a las dificultades de conexión.
Para el propietario de un DGX-2 o un servidor HGX-2, el módulo sigue siendo una pieza de repuesto útil. Para un montaje independiente, solo resulta interesante como experimento que requiere comprobar la compatibilidad del adaptador, la alimentación y la refrigeración.
Si se necesita una V100 con 32 GB de memoria para ejecutar redes neuronales localmente, es más razonable elegir una SXM2 con un adaptador probado o una versión PCIe ya preparada. La SXM3 solo merece la pena si se dispone de una plataforma de servidor compatible o de un conjunto de conexión funcional y verificado.
Comparación de GPU
Comparar Tesla V100 SXM3 32 GB con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/es/gpu/nvidia-tesla-v100-sxm3-32-gb" target="_blank">NVIDIA Tesla V100 SXM3 32 GB</a>