AMD Instinct MI455X
AMD Instinct MI455X - 432 GB HBM4 und erste Ergebnisse mit DeepSeek-R1
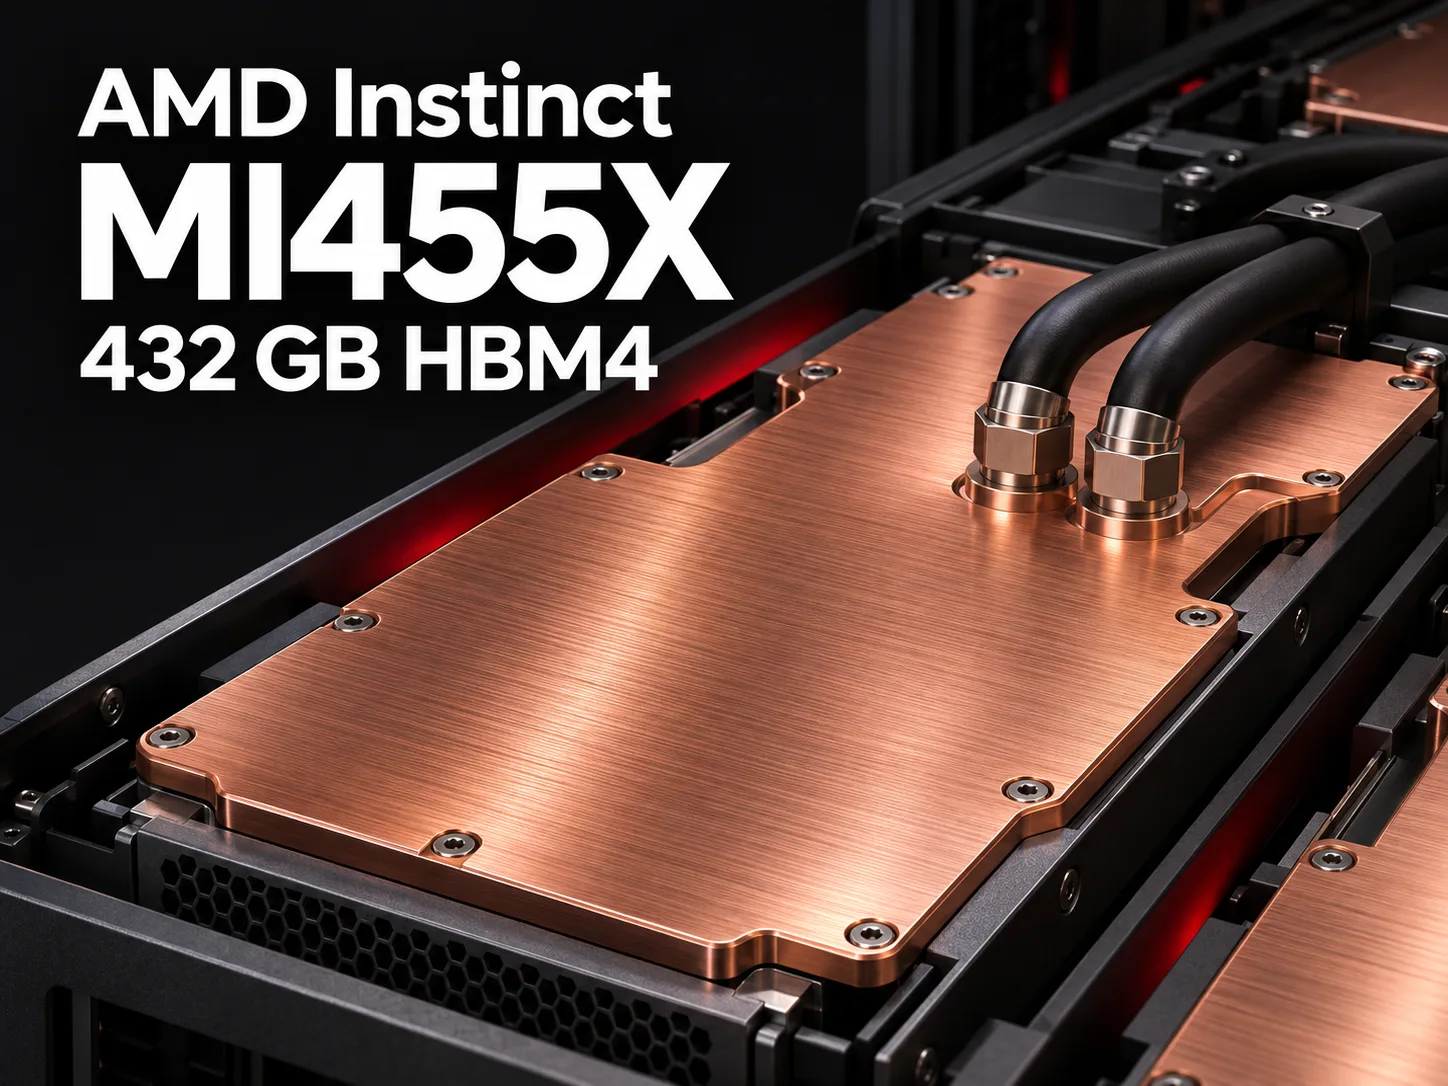
Am 23. Juli 2026 stellte AMD den Instinct MI455X als Teil von Helios vor - einem Server-Rack für das Training und den Betrieb neuronaler Netze. Der MI455X ist als Modul mit direkter Flüssigkühlung ausgeführt. Auf einem solchen Beschleuniger sind 432 GB HBM4 verbaut, und im vollständigen Rack mit 72 GPUs erreicht die Gesamtkapazität etwa 31 TB.
Im November teilte AMD mit, dass das Helios-System mit DeepSeek-R1 eine Leistung von 21 333 Token/s, umgerechnet auf einen MI455X, erreicht habe. Am 12. November verglich das Unternehmen diesen Wert mit dem Ergebnis von NVIDIA Vera Rubin und gab einen Vorsprung von bis zu 30 % an. Vier Tage später veröffentlichte Nebius ein neues Ergebnis für Vera Rubin mit demselben Modell - bereits mehr als 22 000 Token/s im Durchschnitt pro GPU.
Worin sich der MI455X vom MI450X unterscheidet
Beide Beschleuniger für Helios basieren auf der CDNA-5-Architektur. AMD gibt für beide dieselbe maximale Speicherbandbreite von 23,3 TB/s an. Auch die Spitzenwerte bei der Rechenleistung stimmen überein, darunter 40,3 PFLOPS im MXFP4-Format. Der wichtigste Unterschied zwischen den Modellen besteht darin, wie viele Daten in den lokalen Speicher der jeweiligen GPU passen.
| Beschleuniger | HBM4-Speicher pro GPU | Anzahl der HBM4-Stacks |
|---|---|---|
| AMD Instinct MI455X | 432 GB | 12 |
| AMD Instinct MI450X | 288 GB | 8 |
Die zusätzlichen 144 GB sind besonders nützlich, wenn die Modellgewichte nur knapp nicht in den Speicher eines einzelnen Beschleunigers passen. Wenn sich die vollständige Kopie auf einem MI455X unterbringen lässt, kann der Server Anfragen an sie ohne den Austausch von Zwischenergebnissen zwischen den GPUs bearbeiten. Eine andere Möglichkeit, den zusätzlichen Speicher zu nutzen, besteht darin, mehr Platz für den Cache langer Dialoge bereitzustellen.
Passt DeepSeek-R1 in 432 GB?
Das Basismodell DeepSeek-R1 enthält ohne zusätzliches Modul zur Token-Vorhersage rund 671 Milliarden Parameter. Bei der Generierung eines Tokens verwendet das Modell etwa 37 Milliarden Parameter, kann für das nächste Token jedoch andere Experten auswählen. Für das vollständige Laden des Modells werden die Gewichte aller Experten benötigt.
- Bei einer idealen Packung mit vier Bits pro Parameter belegen die Gewichte etwa 335,5 GB (312,5 GiB). Das ist der theoretische Mindestwert ohne Verwaltungsdaten.
- Im MXFP4-Format verfügt jede Gruppe aus 32 Werten über ein gemeinsames Skalierungsbyte. Wenn alle Parameter in diesem Format gespeichert werden, steigt der berechnete Umfang auf 356,5 GB (332 GiB).
- Für eine einzelne Anfrage mit einem Kontext von 131 072 Token belegt der kompakte MLA-Cache von DeepSeek-R1 im BF16-Format zusätzlich etwa 9,2 GB. Dabei handelt es sich um eine Schätzung auf Grundlage der Modellkonfiguration, ohne Arbeits-Puffer und den Overhead des Programms.
Nach diesen Berechnungen passen die Vier-Bit-Gewichte in den nominellen Speicher eines einzelnen MI455X, überschreiten jedoch die Kapazität eines einzelnen MI450X. Wie viele lange Anfragen ein MI455X gleichzeitig bedienen kann, hängt vom tatsächlichen Format der Gewichte und des Caches ab. AMD hat die Konfiguration seines Laufs nicht detailliert genug offengelegt, um das Ergebnis von 21 333 Token/s mit der Platzierung des Modells auf einer einzelnen GPU in Verbindung zu bringen.
DeepSeek-R1 auf MI455X, MI355X und NVIDIA Vera Rubin
Im Szenario MLPerf Inference Offline erhält das System alle Anfragen gleichzeitig. Der Test misst die gesamte Generierungsgeschwindigkeit über alle Anfragen hinweg. In der letzten Spalte sind bei den öffentlichen MLPerf-Ergebnissen die Systemleistung geteilt durch die Anzahl der Beschleuniger angegeben. Den Wert pro GPU für den MI455X hat AMD selbst mitgeteilt.
| System | Quelle des Offline-Ergebnisses | Anzahl der GPUs | Token/s pro System | Token/s pro GPU |
|---|---|---|---|---|
| AMD Helios, Instinct MI455X | AMD-Labor, November | Nicht angegeben | - | 21 333 |
| NVIDIA Vera Rubin NVL72 | MLPerf v6.1, September, Preview | 72 | 1 183 327 | 16 435 |
| Nebius, NVIDIA Vera Rubin NVL72 | MLPerf v6.1, November, Available | 72 | 1 586 667 | 22 037 |
| Crusoe, AMD Instinct MI355X | MLPerf v6.1, September | 512 | 2 901 950 | 5 668 |
Für den eigenen Vergleich verwendete AMD das September-Ergebnis von Vera Rubin. Gegenüber diesem Wert liegt der MI455X tatsächlich um etwa 30 % höher. In der November-Veröffentlichung von Nebius liegt der Durchschnitt pro Rubin bereits um 3,3 % über dem von AMD angegebenen Wert. Beide Unterschiede beziehen sich auf konkrete Systeme. Das Ergebnis des MI455X stammt aus einem internen Test, der nicht von MLCommons überprüft wurde. AMD nannte weder die Zahl der Beschleuniger noch die Rechengenauigkeit.
Für einen interaktiven Dienst stellt sich außerdem die Frage, wie viele Anfragen das System bei einer Begrenzung der Antwortzeit bewältigen kann. Im Szenario Server erreichte das Nebius-Rack im November 1 752 403 Token/s. Für den MI455X enthält die November-Mitteilung von AMD nur Angaben zum Offline-Szenario. Daher lässt sich die Antwortlatenz der beiden Systeme anhand dieser Veröffentlichungen nicht vergleichen.
Für welche Aufgaben wird der MI455X benötigt?
Der naheliegendste Einsatzfall für den MI455X ist ein Modell, das mit 288 GB pro GPU nur knapp nicht auskommt. Der zusätzliche Speicher kann die Zahl der Beschleuniger pro Modellkopie verringern oder es dem Server ermöglichen, gleichzeitig mehr lange Dialoge zu verarbeiten. Wenn dieselbe Last auf einen MI450X passt, hat das größere Modell bei der HBM4-Bandbreite keinen Vorteil laut Datenblatt. Dann hängt die Wahl von der gemessenen Geschwindigkeit und den Kosten der gesamten Konfiguration bei der benötigten Kontextlänge und der zulässigen Zeit bis zum ersten Token ab.
GPU-Vergleich
Instinct MI455X mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
KI-Funktionen
Verbindungen und Skalierbarkeit
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/de/gpu/amd-instinct-mi455x" target="_blank">AMD Instinct MI455X</a>