AMD Instinct MI455X
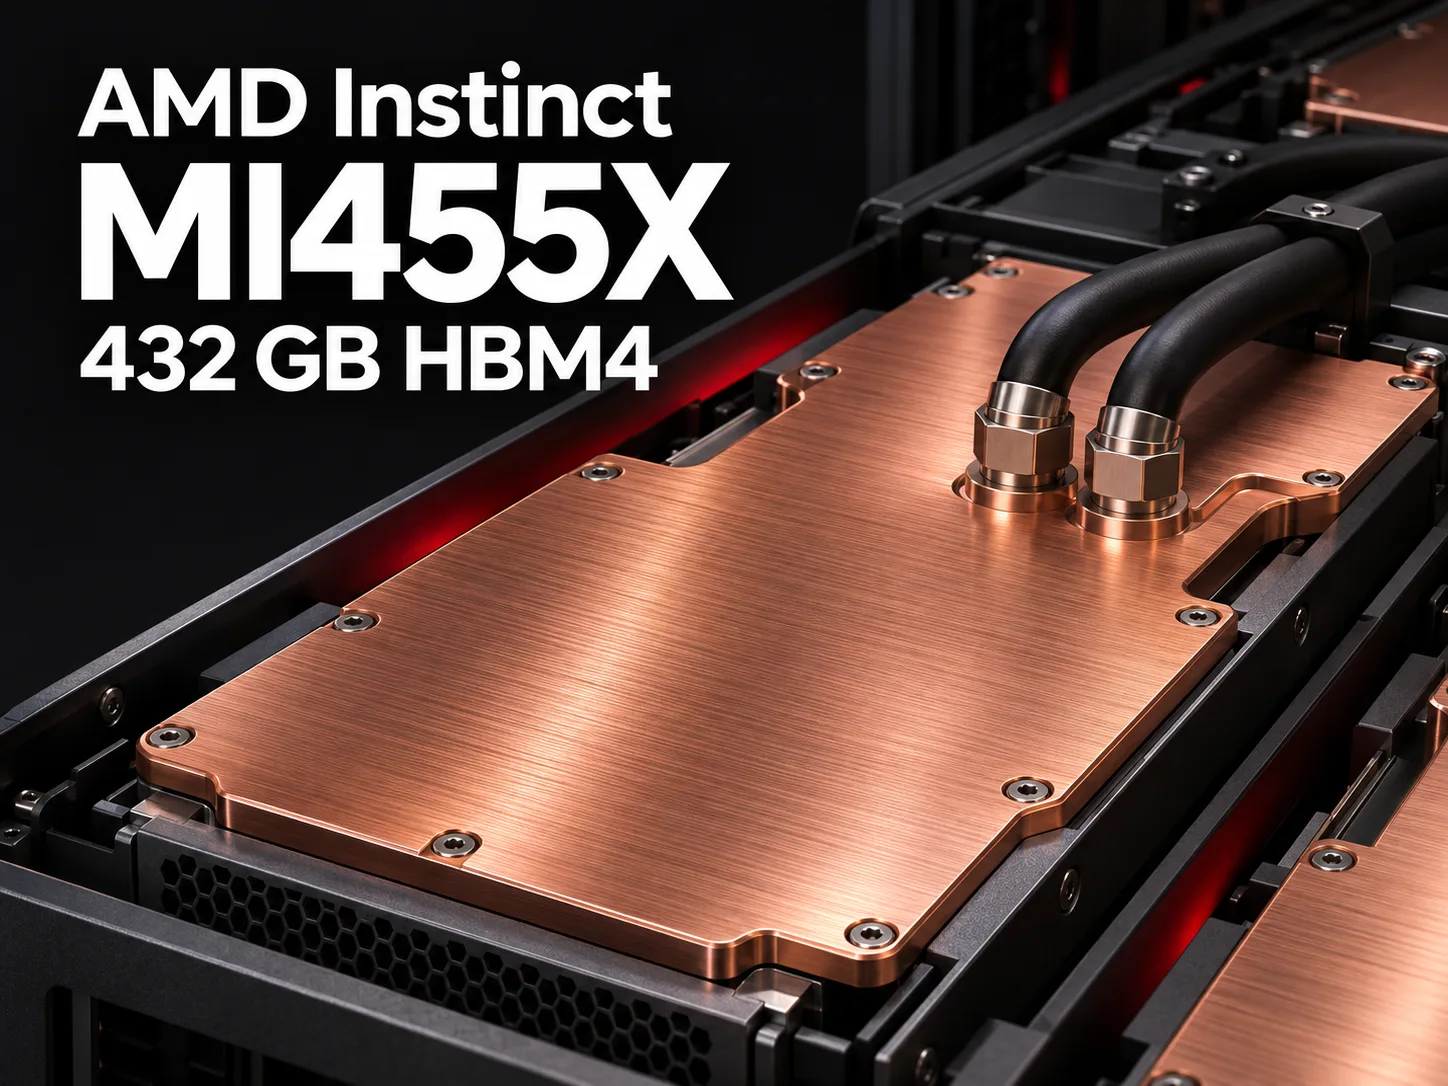
AMD Instinct MI455X - 432GB HBM4와 DeepSeek-R1 첫 결과
2026년 7월 23일, AMD는 신경망 학습 및 실행을 위한 서버 랙인 Helios의 구성 요소로 Instinct MI455X를 공개했다. MI455X는 직접 액체 냉각 방식의 모듈로 설계됐다. 가속기 하나에 432GB의 HBM4 메모리가 탑재되며, GPU 72개로 구성된 전체 랙에서는 총 용량이 약 31TB에 달한다.
11월 AMD는 Helios 시스템이 DeepSeek-R1에서 MI455X 기준 환산 21,333토큰/초를 기록했다고 밝혔다. 11월 12일 AMD는 이 수치를 NVIDIA Vera Rubin의 결과와 비교하며 최대 30%의 우위를 주장했다. 나흘 뒤 Nebius는 동일한 모델에서 Vera Rubin의 새로운 결과를 공개했으며, GPU당 평균 22,000토큰/초를 넘어섰다.
MI455X와 MI450X의 차이
Helios용 두 가속기는 모두 CDNA 5 아키텍처를 기반으로 한다. AMD가 제시한 피크 메모리 대역폭은 23.3TB/s로 동일하다. MXFP4 형식에서 40.3PFLOPS를 비롯한 피크 연산 성능도 같다. 두 모델의 가장 큰 차이는 각 GPU의 로컬 메모리에 저장할 수 있는 데이터의 양이다.
| 가속기 | GPU당 HBM4 메모리 | HBM4 스택 수 |
|---|---|---|
| AMD Instinct MI455X | 432GB | 12 |
| AMD Instinct MI450X | 288GB | 8 |
추가된 144GB는 모델 가중치가 가속기 하나의 메모리에 조금 모자랄 때 특히 유용하다. MI455X에 모델 전체 복사본을 배치할 수 있다면 서버는 GPU 간에 중간 결과를 주고받지 않고 해당 모델에 대한 요청을 처리할 수 있다. 여유 메모리를 활용하는 또 다른 방법은 긴 대화를 위한 캐시 공간을 늘리는 것이다.
DeepSeek-R1은 432GB에 들어가는가
DeepSeek-R1 기본 모델은 추가 토큰 예측 모듈을 제외하고 약 6710억 개의 파라미터를 포함한다. 토큰 하나를 생성할 때는 약 370억 개의 파라미터가 사용되지만, 다음 토큰에서는 다른 전문가를 선택할 수 있다. 모델 전체를 로드하려면 모든 전문가의 가중치가 필요하다.
- 파라미터당 4비트로 이상적으로 패킹하면 가중치에는 약 **335.5GB(312.5GiB)**가 필요하다. 이는 부가 데이터가 포함되지 않은 이론적 최솟값이다.
- MXFP4 형식에서는 32개 값으로 구성된 각 그룹에 공통 스케일을 나타내는 1바이트가 추가된다. 모든 파라미터를 이 형식으로 저장하면 계산상 용량은 **356.5GB(332GiB)**로 늘어난다.
- 컨텍스트가 131,072토큰인 요청 하나의 경우, BF16 형식의 압축 MLA 캐시에 약 9.2GB가 추가로 필요하다. 이는 작업 버퍼와 프로그램 오버헤드를 고려하지 않고 모델 구성만을 기준으로 추산한 값이다.
이 계산에 따르면 4비트 가중치는 MI455X 한 대의 명목 메모리에 들어가지만, MI450X 한 대의 용량은 초과한다. MI455X가 동시에 처리할 수 있는 긴 요청의 수는 실제 가중치 및 캐시 형식에 따라 달라진다. AMD는 자체 실행 구성에 대해 충분히 자세한 정보를 공개하지 않았기 때문에, 21,333토큰/초라는 결과가 모델을 GPU 하나에 배치한 상태에서 나온 것인지 연결해 판단할 수 없다.
MI455X, MI355X 및 NVIDIA Vera Rubin에서의 DeepSeek-R1
MLPerf Inference Offline 시나리오에서는 시스템이 모든 요청을 한꺼번에 받는다. 테스트는 모든 요청에 대한 총 생성 속도를 측정한다. 공개된 MLPerf 결과의 마지막 열에는 시스템 속도를 가속기 수로 나눈 값이 표시돼 있다. MI455X의 GPU당 수치는 AMD가 직접 공개한 값이다.
| 시스템 | Offline 결과 출처 | GPU 수 | 시스템 토큰/초 | GPU당 토큰/초 |
|---|---|---|---|---|
| AMD Helios, Instinct MI455X | AMD 연구소, 11월 | 미공개 | - | 21,333 |
| NVIDIA Vera Rubin NVL72 | MLPerf v6.1, 9월, Preview | 72 | 1,183,327 | 16,435 |
| Nebius, NVIDIA Vera Rubin NVL72 | MLPerf v6.1, 11월, Available | 72 | 1,586,667 | 22,037 |
| Crusoe, AMD Instinct MI355X | MLPerf v6.1, 9월 | 512 | 2,901,950 | 5,668 |
AMD는 자체 비교에서 Vera Rubin의 9월 결과를 사용했다. 이를 기준으로 하면 MI455X의 수치가 실제로 약 30% 높다. Nebius가 11월에 공개한 결과에서는 Rubin 한 대당 평균 수치가 이미 AMD가 제시한 수치보다 3.3% 높았다. 두 차이는 모두 특정 시스템을 기준으로 한 것이다. MI455X의 결과는 MLCommons의 검증을 거치지 않은 내부 테스트에서 얻어졌다. AMD는 가속기 수와 연산 정밀도를 공개하지 않았다.
대화형 서비스에서는 응답 시간 제한을 두었을 때 시스템이 얼마나 많은 요청을 처리할 수 있는지도 중요하다. Server 시나리오에서 Nebius의 11월 랙은 1,752,403토큰/초를 기록했다. AMD가 11월에 발표한 MI455X 결과에는 Offline 수치만 있으므로, 두 시스템의 응답 지연을 이 자료만으로 비교할 수는 없다.
MI455X가 필요한 작업
MI455X의 가장 분명한 용도는 GPU당 288GB로는 부족한 모델이다. 추가 메모리는 모델 복제본 하나에 필요한 가속기 수를 줄이거나, 서버가 동시에 더 많은 긴 대화를 처리하도록 할 수 있다. 동일한 워크로드가 MI450X에 들어간다면, 상위 모델인 MI455X는 HBM4 대역폭에서 사양상 우위를 갖지 않는다. 따라서 선택은 필요한 컨텍스트 길이와 허용 가능한 첫 토큰 생성 시간에서 측정된 속도 및 전체 구성 비용에 따라 달라진다.
GPU 비교
Instinct MI455X을 다른 GPUs와 비교
기초적인
메모리 사양
디스플레이 및 미디어
이론적 성능
AI 기능
상호 연결 및 확장성
여러 가지 잡다한
벤치마크
다른 GPU와 비교
소셜 미디어에서 공유하기
또는 링크로 소개하기
<a href="https://cputronic.com/ko/gpu/amd-instinct-mi455x" target="_blank">AMD Instinct MI455X</a>