NVIDIA GeForce RTX 5080
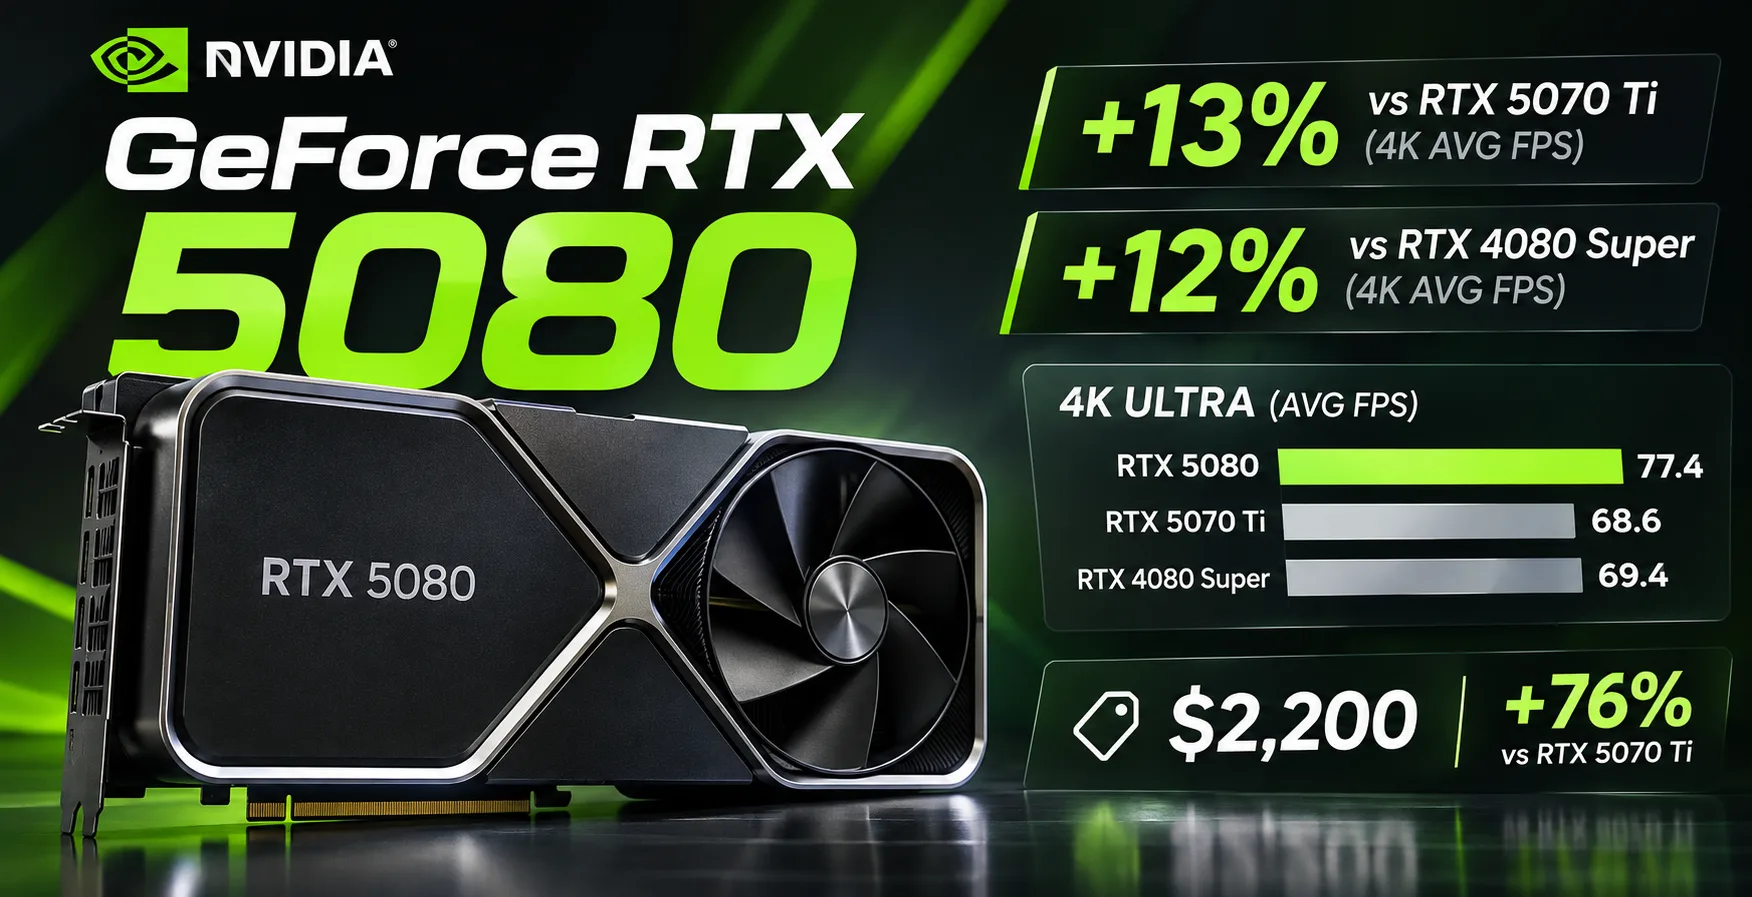
GeForce RTX 5080: 13 % schneller als die RTX 5070 Ti in 4K, aber 76 % teurer
Die GeForce RTX 5080 kam im Januar 2025 für 999 US-Dollar auf den Markt, doch bis Oktober 2026 stieg der niedrigste Preis verfügbarer Angebote in den USA auf 2200 US-Dollar. Die RTX 5070 Ti für 1250 US-Dollar liegt bei der Bildrate in 4K im Durchschnitt nur 13 % dahinter. Der Preisunterschied beträgt 950 US-Dollar, obwohl beide Karten über 16 GB Videospeicher verfügen und DLSS Multi Frame Generation unterstützen.
Auch das Upgrade gegenüber der RTX 4080 Super fiel bescheiden aus. Nach den Testergebnissen von Tom's Hardware ist die RTX 5080 ohne Raytracing in 4K etwa 12 % schneller als ihre Vorgängerin. Den größten Vorsprung gegenüber der RTX 5070 Ti zeigt sie in Spielen mit anspruchsvollem Raytracing - doch auch dort entspricht der Leistungszuwachs nicht dem Preisunterschied.
Blackwell und GDDR7: Was sich geändert hat
Die RTX 5080 basiert auf der GPU GB203 mit 10 752 CUDA-Kernen. Sie verwendet GDDR7-Speicher mit einer Speicherbandbreite von 960 GB/s statt GDDR6X wie bei der RTX 4080 Super. Die Bandbreite ist damit um 30 % gestiegen, die Speicherkapazität bleibt jedoch unverändert.
| Merkmal | RTX 5080 | RTX 4080 Super | RTX 5070 Ti |
|---|---|---|---|
| Architektur | Blackwell | Ada Lovelace | Blackwell |
| CUDA-Kerne | 10 752 | 10 240 | 8 960 |
| Speicher | 16 GB GDDR7 | 16 GB GDDR6X | 16 GB GDDR7 |
| Speicherbandbreite | 960 GB/s | 736 GB/s | 896 GB/s |
| Boost-Takt | 2617 MHz | 2550 MHz | 2452 MHz |
| TGP | 360 W | 320 W | 300 W |
Die RTX 5080 verfügt über RT-Kerne der vierten Generation, Tensor-Kerne der fünften Generation, PCIe 5.0 und DisplayPort 2.1b.
Das nominelle TGP ist von 320 auf 360 W gestiegen, wobei der tatsächliche Stromverbrauch von der Auslastung abhängt. NVIDIA empfiehlt ein Netzteil mit einer Leistung von 850 W. Für den Anschluss wird ein 16-poliges Stromkabel oder der mitgelieferte Adapter auf drei 8-polige Anschlüsse verwendet.
3DMark Time Spy
| Grafikkarte | Graphics Score |
|---|---|
| GeForce RTX 4090 | 36 676 |
| GeForce RTX 5080 | 31 987 |
| Radeon RX 9070 XT | 29 464 |
| GeForce RTX 4080 Super | 27 920 |
| GeForce RTX 5070 Ti | 27 727 |
Ergebnisse von ComputerBase.
Die RTX 5080 liegt etwa 15 % vor der RTX 4080 Super und der RTX 5070 Ti, bleibt aber hinter der RTX 4090 der vorherigen Generation zurück.
Spieletests: 1440p und 4K ohne Upscaling
Die zusammengefassten Ergebnisse von Tom's Hardware aus dem Juni 2026 ermöglichen einen Vergleich der Grafikkarten ohne DLSS, FSR und Frame Generation.
| Grafikkarte | 1440p Ultra | 4K Ultra | 4K mit RT |
|---|---|---|---|
| RTX 4090 | 143,4 | 89,1 | 52,2 |
| RTX 5080 | 128,3 | 77,4 | 42,1 |
| RTX 4080 Super | 118,6 | 69,4 | 38,5 |
| RTX 5070 Ti | 116,8 | 68,6 | 36,7 |
| Radeon RX 9070 XT | 116,5 | 65,8 | 30,1 |
Durchschnittliche FPS. Rasterisierung und Raytracing wurden in separaten Spielepaketen gemessen.
Bei 1440p ist die RTX 5080 10 % schneller als die RTX 5070 Ti, bei 4K wächst der Vorsprung auf 13 %. Die RTX 4080 Super liegt in 4K etwa 12 % hinter der neuen Karte, während die RTX 4090 ihre Spitzenposition behauptet.
Mit Raytracing erreicht der Vorsprung der RTX 5080 gegenüber der RTX 5070 Ti 15 % und gegenüber der Radeon RX 9070 XT 40 %. Allerdings bedeuten durchschnittlich 42 FPS in 4K mit RT, dass für eine höhere Bildrate Upscaling oder eine Reduzierung der Einstellungen erforderlich ist.
Death Stranding 2: Vergleich mit DLSS und FSR
In den Tests von ComputerBase aus dem März 2026 kamen sehr hohe Grafikeinstellungen, DLSS 4 Quality für NVIDIA und FSR 4.1 Quality für die Radeon RX 9000 zum Einsatz. Die Frame-Generierung war deaktiviert.
| Grafikkarte | 1440p | 4K | 4K mit RT |
|---|---|---|---|
| RTX 4090 | 124,8 | 105,5 | 65,5 |
| RTX 5080 | 125,8 | 96,4 | 57,0 |
| RTX 4080 Super | 104,1 | 82,3 | 49,2 |
| RTX 5070 Ti | 110,4 | 84,6 | 49,2 |
| Radeon RX 9070 XT | 106,9 | 79,0 | 41,2 |
Durchschnittliche FPS. Im RT-Modus kommt maximales Raytracing zum Einsatz. Die Bildqualität kann sich bei DLSS und FSR unterscheiden.
Die RTX 5080 ist in 4K 14 % und mit Raytracing 16 % schneller als die RTX 5070 Ti. Die RTX 4090 behauptet in 4K ihre Führungsposition, liegt bei 1440p jedoch knapp hinter der neuen Karte.
Preis: Wie viel kostet die zusätzliche Leistung?
Laut einer am 2. November 2026 veröffentlichten Untersuchung von TechSpot lagen die niedrigsten Preise verfügbarer Grafikkarten in US-amerikanischen Geschäften im Oktober bei 2200 US-Dollar für die RTX 5080, 1250 US-Dollar für die RTX 5070 Ti und 870 US-Dollar für die Radeon RX 9070 XT.
| Grafikkarte | Preis in den USA | FPS in 4K | Preis pro FPS |
|---|---|---|---|
| RTX 5080 | 2200 US-Dollar | 77,4 | 28,42 US-Dollar |
| RTX 5070 Ti | 1250 US-Dollar | 68,6 | 18,22 US-Dollar |
| Radeon RX 9070 XT | 870 US-Dollar | 65,8 | 13,22 US-Dollar |
Der Preis pro FPS wurde anhand der durchschnittlichen Ergebnisse in 4K Ultra ohne Raytracing berechnet. Der Wert dient ausschließlich zum Vergleich der Kosten pro Leistung.
Umgerechnet auf ein FPS kostet die RTX 5080 56 % mehr als die RTX 5070 Ti. Die Radeon RX 9070 XT bietet etwa 85 % der Leistung der RTX 5080 und kostet dabei 2,5-mal weniger.
Auch die RTX 5070 Ti ist gegenüber der unverbindlichen Preisempfehlung von 749 US-Dollar deutlich teurer geworden. Im Vergleich zur RTX 5080 bleibt sie jedoch der bessere Kauf.
DLSS und Raytracing
Die RTX 5080 unterstützt DLSS Multi Frame Generation, das zusätzliche Frames zwischen den von der Game-Engine berechneten Frames erzeugt. Die Technologie sorgt für eine flüssigere Darstellung, verbessert jedoch nicht proportional die Reaktionsfähigkeit der Steuerung.
Die RTX 5070 Ti unterstützt dieselbe Technologie. Der Vorteil der RTX 5080 liegt in der höheren Ausgangsbildrate, insbesondere in Spielen mit Pathtracing. Für Besitzer von 4K-Monitoren mit hoher Bildwiederholrate kann dieser Unterschied wichtig sein, auch wenn selbst die RTX 5080 in anspruchsvollen Spielen nicht immer ohne Upscaling auskommt.
Blender, Videoschnitt und neuronale Netze
Die RTX 5080 unterstützt CUDA, OptiX und die Hardwarekodierung von AV1. Zwei NVENC-Videokodierer der neunten Generation beschleunigen die Verarbeitung kompatibler Videoformate, darunter 10-Bit-HEVC 4:2:2.
In den Tests von Puget Systems sehen die Ergebnisse des Blender Benchmark folgendermaßen aus:
| Grafikkarte | Blender Benchmark |
|---|---|
| RTX 5090 | 15 872 |
| RTX 5080 | 9 035 |
| RTX 5070 Ti | 7 882 |
| Radeon RX 9070 XT | 3 722 |
Die RTX 5080 ist 15 % schneller als die RTX 5070 Ti. Die Radeon RX 9070 XT liegt beim Rendern über HIP deutlich zurück, weshalb sich NVIDIA-Beschleuniger für die regelmäßige Arbeit mit Blender besser eignen.
Für lokale neuronale Netze ist die RTX 5080 auf 16 GB Videospeicher beschränkt. Ein Sprachmodell mit 32 Milliarden Parametern und 4-Bit-Quantisierung passt beispielsweise unter Berücksichtigung von Verwaltungsdaten und KV-Cache in der Regel nicht vollständig in diese Speichermenge. Der genaue Bedarf hängt vom Quantisierungsformat und der Kontextgröße ab.
Passt das Modell in den VRAM, bietet die RTX 5080 eine hohe Rechenleistung. Bei größeren Modellen ist zusätzlicher Videospeicher häufig nützlicher als eine leistungsfähigere GPU.
Lohnt sich der Kauf der GeForce RTX 5080 im Jahr 2026?
Bei einem Preis von 2200 US-Dollar ist die RTX 5080 für gewöhnliches Gaming nur schwer zu empfehlen. Die RTX 5070 Ti kostet 950 US-Dollar weniger, verfügt über dieselben 16 GB Speicher und liegt bei den FPS in 4K im Durchschnitt nur 13 % zurück. Die Radeon RX 9070 XT ist noch attraktiver, sofern keine hohe Raytracing-Leistung erforderlich ist.
Die RTX 5080 ist für 4K mit anspruchsvollen Grafikeffekten, Blender und CUDA-Aufgaben sinnvoll, sofern 16 GB Videospeicher ausreichen. Besitzer einer RTX 4080 Super sollten nicht aufrüsten: Ein Zuwachs von etwa 12 % in 4K ist für einen derart teuren Wechsel zu gering.
GPU-Vergleich
GeForce RTX 5080 mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
3x DisplayPort 2.1b
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
Verwandte GPU-Vergleiche


In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/index.php/de/gpu/nvidia-geforce-rtx-5080" target="_blank">NVIDIA GeForce RTX 5080</a>