NVIDIA Tesla V100 PCIe 32 GB

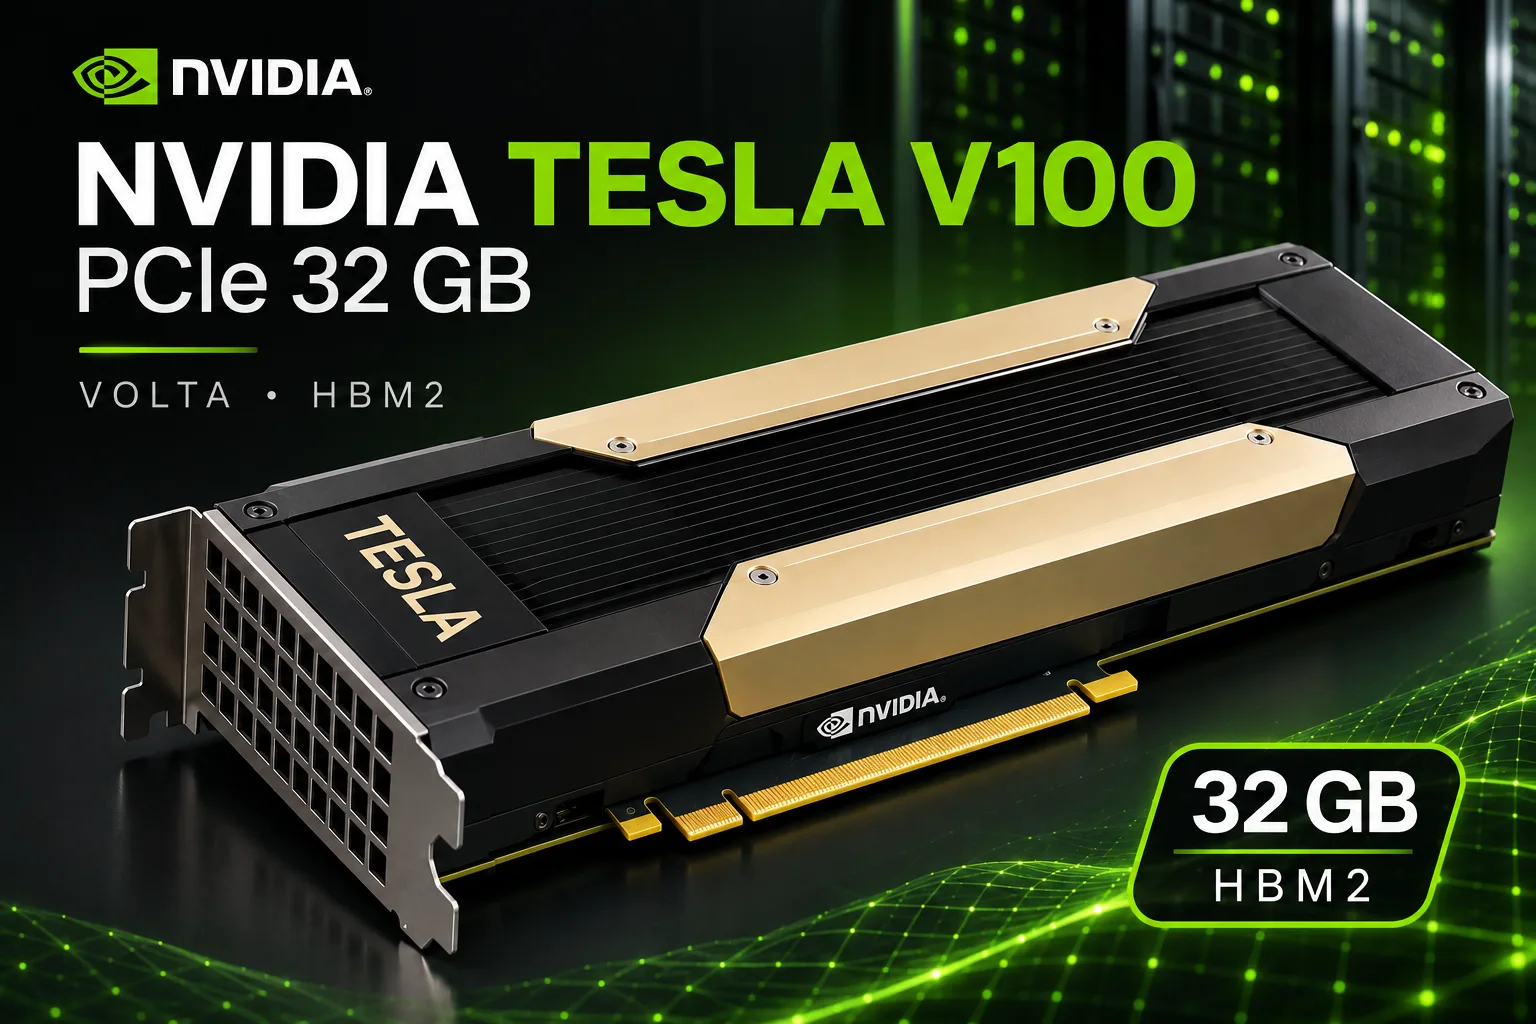
Tesla V100 PCIe 32 GB: память под модели на 27 млрд параметров, но с наценкой за разъем PCIe
Tesla V100 PCIe 32 GB - версия серверного ускорителя V100 с удвоенной памятью. NVIDIA выпустила ее в марте 2018 года по цене около $11 500. Сейчас списанные карты продаются на eBay примерно за $700.
Кристалл, частоты и пропускная способность 900 ГБ/с у нее те же, что у 16-гигабайтной версии. Но в 2026 году решает именно объем. В 32 ГБ помещаются плотные модели на 27-32 млрд параметров в 4-битном квантовании с длинным контекстом, и V100 выдает на них около 30 токенов в секунду.
Минусов два. Volta осталась без новых драйверов и без CUDA 13. А PCIe-версия стоит почти втрое дороже 16-гигабайтной и заметно дороже SXM2-модуля того же объема.
Положение в линейке
Все V100 собраны на кристалле GV100: техпроцесс TSMC 12 нм, 5120 CUDA-ядер и 640 тензорных ядер первого поколения, четыре стека HBM2 на 4096-битной шине. Версии с 32 ГБ и ближайшая родня:
| Модель | Память | Пропускная способность | Boost | TDP | Особенности |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 ГБ HBM2 | 900 ГБ/с | 1380 МГц | 250 Вт | та же карта с половиной памяти |
| Tesla V100 PCIe 32 GB | 32 ГБ HBM2 | 900 ГБ/с | 1380 МГц | 250 Вт | пассивный радиатор, без NVLink и видеовыходов |
| Tesla V100 SXM2 32 GB | 32 ГБ HBM2 | 900 ГБ/с | 1530 МГц | 300 Вт | серверный разъем SXM2, NVLink |
| Tesla V100S PCIe 32 GB | 32 ГБ HBM2 | 1134 ГБ/с | 1601 МГц | 250 Вт | обновление 2019 года |
| Quadro GV100 | 32 ГБ HBM2 | 870 ГБ/с | 1627 МГц | 250 Вт | видеовыходы, профессиональный драйвер |
Паспортная производительность PCIe-версии - 14 TFLOPS в FP32, 7 TFLOPS в FP64 и 112 TFLOPS на тензорных ядрах. Тензорные ядра работают только с FP16. RT-ядер, BF16 и TF32 у Volta нет.
В объявлениях одна и та же референсная плата встречается под разными партномерами: PNY TCSV100M-32GB-PB, Dell 490-BENZ и 0HR5WD, HPE Q9U36A, Lenovo 4X67A12088, Cisco UCSC-GPU-V100-32=.
Производительность
Языковые модели
Скорость генерации токенов упирается в пропускную способность памяти. Поэтому на небольших моделях 32-гигабайтная V100 работает так же, как 16-гигабайтная. Замеры разработчиков llama.cpp на одной версии кода:
| Карта | Память | gpt-oss 20B, промпт (pp2048), ток/с | gpt-oss 20B, генерация (tg128), ток/с | Llama 8B Q4_0, генерация, ток/с |
|---|---|---|---|---|
| Tesla P40 | 24 ГБ GDDR5 | 1362 | 65 | 52 |
| Instinct MI50/MI60 | 32 ГБ HBM2 | 1066 | 144 | - |
| Tesla V100 PCIe 32 GB | 32 ГБ HBM2 | 2436 | 151 | 128 |
| GeForce RTX 3090 | 24 ГБ GDDR6X | 5824 | 210 | 155 |
| GeForce RTX 4090 | 24 ГБ GDDR6X | 13 127 | 264 | 179 |
| GeForce RTX 5090 | 32 ГБ GDDR7 | 21 011 | 412 | 282 |
На gpt-oss 20B V100 генерирует на 28% медленнее RTX 3090 и наравне с картой AMD. В тесте не уточнено, участвовала MI50 или MI60. Промпт V100 обрабатывает в 2,3 раза быстрее AMD, но в 2,4 раза медленнее 3090.
Ради 32 ГБ эту карту берут под плотные модели на 27 млрд параметров. Ниже отчеты владельцев: llama.cpp, один запрос, без ускорений. Строки с SXM2 подходят и для PCIe-версии: память у них одинаковая, а генерация упирается именно в нее. Напрямую сравнимы строки с Qwen3.6 27B Q4_K_M.
| Конфигурация | Модель и квантование | Генерация, ток/с | Промпт, ток/с |
|---|---|---|---|
| V100 PCIe 32 GB | Qwen3.8 27B, UD-Q4_K_XL | 33,4 | 826 |
| V100 SXM2 32 GB | Qwen3.6 27B, Q4_K_M | 32,2 | - |
| V100 SXM2 32 GB | Qwen3.6 27B, Q8_0 | 22,8 | - |
| RTX 5090 | Qwen3.6 27B, Q4_K_M | 77 | - |
32-33 токена в секунду на 27B в 4 битах хватает для чата и агентских задач. RTX 5090 быстрее в 2,4 раза, но и стоит почти в 9 раз дороже.
Программные приемы дают больше, чем выбор между PCIe и SXM2. С MTP (предсказанием нескольких токенов за шаг) Qwen3.8 27B разгоняется с 33 до 57 токенов в секунду. Сильнее всего прирост на коде, слабее на прозе. Форк vLLM в одном потоке на 10% медленнее llama.cpp. Зато на четырех одновременных запросах он выдает 110 токенов в секунду суммарно против 75,7.
С ростом контекста скорость падает: с 33,4 токена в секунду на пустом контексте до 28 на 32 тыс. токенов и 15,8 на 131 тыс. Стоит следить и за охлаждением. У одного владельца карта проседала до 15,7 токена в секунду, пока он не выкрутил вентиляторы сервера на максимум.
В одном из тестов V100 оказалась экономичнее RTX 4070. На Qwen3.5 4B она выдала 107 токенов в секунду при 154 Вт, а 4070 - 91 токен при 173 Вт, то есть на 30% меньше токенов на джоуль. Промпт 4070 обрабатывает быстрее: 5860 токенов в секунду против 4445.
Обучение, расчеты и игры
32 ГБ позволяют дообучать в FP16 модели крупнее, но без BF16 и FlashAttention 2 современные цепочки обучения приходится переделывать. По замерам Lambda на SXM2-версиях, A100 обучает в 1,6-3,4 раза быстрее.
В FP64 V100 по-прежнему сильна. 7 TFLOPS примерно в пять раз больше, чем у RTX 4090, а в 32 ГБ помещаются крупные сетки для CFD и молекулярной динамики.
Для игр карта не годится. Видеовыходов, DLSS и трассировки лучей нет, а по уровню она чуть ниже RTX 4060 Ti.
Поддержка софта
Ветка драйверов R580 - последняя с поддержкой Volta. CUDA 13 под эту архитектуру не компилирует, так что остаются CUDA 12.x. Готовые сборки llama.cpp и LM Studio постепенно теряют поддержку V100. У одного владельца квантование KV-кэша молча ушло на процессор как раз из-за отсутствия Volta в CUDA 13.
Платформу держат энтузиасты: форки vLLM под sm_70, порт ExLlamaV3, сборки llama.cpp с MTP. Для домашних экспериментов этого хватает. В рабочей системе вы будете зависеть от того, сколько еще авторы станут их поддерживать.
Цены и где ее брать
Новые V100 давно не выпускаются, сейчас карту продают только б/у.
| Предложение | Конфигурация | Цена |
|---|---|---|
| eBay США, нижняя граница (октябрь 2026) | V100 PCIe 32 GB | ~$685-695 |
| eBay США, средняя по активным объявлениям | V100 PCIe 32 GB | ~$920 |
| Amazon / Newegg (октябрь 2026) | V100 PCIe 32 GB | $799 / $839 |
| Отдельные зарубежные продавцы | V100 PCIe 32 GB | $400-500 |
| SXM2-модуль + переходник | V100 SXM2 32 GB | ~$250-600 |
| IT Creations | V100S PCIe 32 GB | $8937 |
| TechMikeNY, Dell PowerEdge R740 | сервер с одной V100 PCIe 32 GB | $12 156 |
Нижняя граница на eBay с начала года почти не двигается: около $707 в феврале, около $685 сейчас. Дешевле $500 карта встречается только у отдельных зарубежных продавцов. Гарантии у таких лотов, как и у самых дешевых на eBay, обычно нет. К цене стоит добавить вентилятор с кожухом: без серверного обдува пассивный радиатор перегревается.
Реселлеры и сборщики серверов просят на порядок больше. В серверной сборке вы платите в основном за процессоры, память и диски.
Конкуренты и альтернативы
Tesla V100 SXM2 32 GB с переходником. Тот же кристалл и тот же объем, частота на 10% выше, вместе с переходником $250-600. Минусы - самостоятельная сборка, шумный штатный вентилятор и 300 Вт под нагрузкой. Для домашнего ПК это самый дешевый путь к 32 ГБ HBM2.
Две V100 PCIe 16 GB. Около $470 за те же 32 ГБ. llama.cpp разделит модель по слоям, и генерация останется на уровне одной карты. Понадобятся два слота x16 и блок питания с запасом на 500 Вт.
GeForce RTX 3090. В генерации быстрее на 20-40%, промпт обрабатывает в 2,4 раза быстрее, плюс BF16, FlashAttention и драйверы с поддержкой. 27B в 4 битах в ее 24 ГБ помещается, но с меньшим запасом под контекст, а 32B в Q5-Q6 уже нет. Стоит около $1386, вдвое дороже V100.
GeForce RTX 5090. Те же 32 ГБ и намного более высокая скорость. Из-за дефицита памяти она стоит от $6000 при рекомендованных $1999. Это около $190 за гигабайт против $22 у V100.
AMD Instinct MI50 32 GB. Генерация на уровне V100, промпт более чем вдвое медленнее. Стоит $120-210 у поставщиков на Alibaba и $500-650 на eBay. Стабильно на ней работают в основном llama.cpp и базовый PyTorch.
Вывод
По современным меркам V100 PCIe 32 GB - медленный вычислитель с большой и быстрой памятью. Ее хватает, чтобы держать модель на 27-32 млрд параметров с длинным контекстом и работать с ней в комфортном темпе. Ограничения начинаются с длинных промптов, обучения и софта. Для рабочих систем карта не подходит.
Разумная цена PCIe-версии - до $450-500. За нынешние $700 она проигрывает SXM2-модулю на 32 ГБ с переходником. Переплата за PCIe оправдана, только если карта ставится в стоечный сервер вроде Dell R740 или HPE DL380: туда переходник не поставить, а штатный обдув решает вопрос охлаждения.
Если 24 ГБ хватает и нужна скорость с нормальной поддержкой софта, лучше доплатить за RTX 3090. Если нужен максимум памяти за минимум денег, выгоднее V100 SXM2 32 GB или MI50.
Сравнение GPU
Сравнить Tesla V100 PCIe 32 GB с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Похожие сравнения видеокарт


Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/index.php/ru/gpu/nvidia-tesla-v100-pcie-32-gb" target="_blank">NVIDIA Tesla V100 PCIe 32 GB</a>