NVIDIA Tesla P100 SXM2

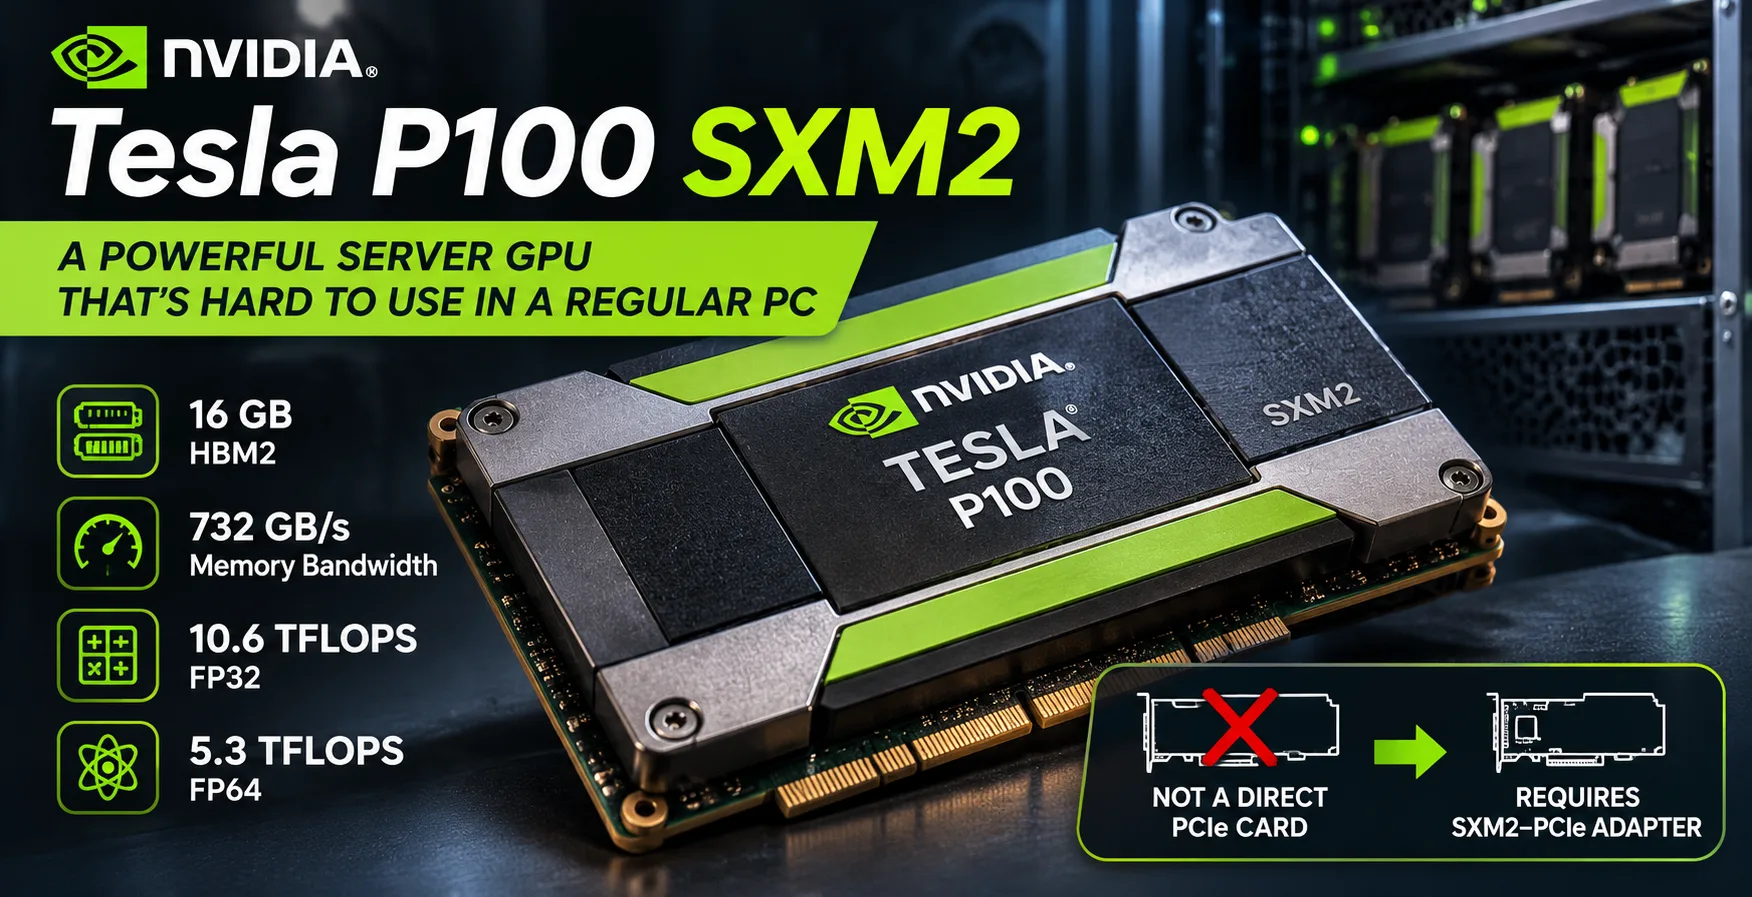
NVIDIA Tesla P100 SXM2: дешёвый серверный GPU, который сложно установить в обычный ПК
NVIDIA Tesla P100 SXM2 привлекает энтузиастов сочетанием 16 ГБ памяти HBM2, высокой производительности FP64 и низкой цены на вторичном рынке. Но у этого ускорителя 2016 года есть серьёзный недостаток: вместо стандартного PCIe он использует серверный разъём SXM2. Для установки в обычный компьютер потребуются переходник, отдельное охлаждение и проверка совместимости. В результате дешёвый модуль может обойтись дороже более удобной PCIe-версии.
Почему SXM2 сложно подключить к обычному ПК
Tesla P100 SXM2 создавалась для специализированных серверов, включая системы NVIDIA DGX. Она не имеет стандартного разъёма PCIe и не устанавливается непосредственно в слот материнской платы.
На вторичном рынке встречаются переходники SXM2-PCIe, но наличие подходящего разъёма ещё не гарантирует работоспособность. Перед покупкой необходимо решить несколько вопросов:
- Питание. Ускоритель потребляет до 300 Вт. Переходник должен обеспечивать необходимое питание модуля.
- Охлаждение. SXM2 рассчитан на серверную систему охлаждения. Для обычного корпуса нужен совместимый радиатор с достаточно мощным обдувом.
- Совместимость. Необходимо проверить поддержку конкретного модуля переходником, материнской платой и драйвером.
- Отсутствие видеовыходов. Tesla P100 не предназначена для прямого подключения монитора.
Дополнительные расходы могут полностью уничтожить выгоду от покупки. По оценке американского вторичного рынка за август 2026 года, рабочие модули P100 SXM2 продавались примерно за $47-60. При этом один из переходников SXM2-PCIe с заявленной поддержкой P100 предлагался в сентябре приблизительно за $109 - без учёта дополнительных расходов на охлаждение и доставку.
Стоимость переходника в таком примере почти вдвое превышает цену самого ускорителя. Поэтому оценивать покупку SXM2 только по стоимости модуля бессмысленно.
Отличия Tesla P100 SXM2 от P100 PCIe
Обе версии построены на одном графическом процессоре GP100 архитектуры Pascal. Они имеют по 3584 ядра CUDA, а варианты с 16 ГБ HBM2 обеспечивают одинаковую пропускную способность памяти - 732 ГБ/с.
Основные различия связаны с частотами, питанием и подключением.
| Характеристика | Tesla P100 SXM2 | Tesla P100 PCIe 16 GB |
|---|---|---|
| Подключение | SXM2 | PCIe 3.0 x16 |
| Базовая частота | 1328 МГц | 1126 МГц |
| Boost-частота | 1480 МГц | 1303 МГц |
| Межсоединение GPU | NVLink, до 160 ГБ/с | PCIe 3.0 |
| Максимальная мощность | 300 Вт | 250 Вт |
Повышенные частоты дают SXM2 примерно 14% преимущества по теоретической вычислительной производительности FP32. Однако максимальная мощность у неё на 50 Вт выше.
Ещё одно преимущество SXM2 - NVLink, позволяющий ускорителям обмениваться данными между собой. Эта возможность полезна в совместимых многопроцессорных серверах. При установке через обычный переходник PCIe преимущество NVLink теряется.
Для одиночного ускорителя в настольном ПК преимущества SXM2 перед PCIe оказываются сравнительно небольшими.
Производительность и бенчмарки
GP100 отличается от большинства потребительских GPU высокой скоростью вычислений двойной точности FP64. У Tesla P100 SXM2 она достигает 5,3 TFLOPS, что делает ускоритель пригодным для научных расчётов и численного моделирования.
Для сравнения использованы результаты Geekbench 7 OpenCL и теоретическая вычислительная производительность нескольких конкретных видеокарт.
| Видеокарта | Geekbench 7 OpenCL | FP32, TFLOPS | FP64, TFLOPS |
|---|---|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 | 15,7 | 7,8 |
| NVIDIA GeForce RTX 3060 | 88 251 | 12,7 | 0,20 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 | 10,6 | 5,3 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 | 9,3 | 4,7 |
| NVIDIA Tesla T4 16 GB | 61 276 | 8,1 | ~0,25 |
Geekbench 7 OpenCL - результаты публичного рейтинга Geekbench за октябрь 2026 года, больше - лучше. FP32 и FP64 - теоретические показатели, а не результаты Geekbench. Они приведены для сравнения вычислительных возможностей архитектур.
В Geekbench P100 SXM2 набирает примерно на 22% больше баллов, чем PCIe-версия с 16 ГБ. Разница заметнее, чем предполагают паспортные характеристики, но результаты получены на разных системах и не позволяют считать такой прирост гарантированным.
С GeForce RTX 3060 ситуация интереснее. Их оценки Geekbench практически совпадают, однако в FP64 серверная Tesla теоретически превосходит RTX 3060 более чем в 26 раз. Причина - специализированная конфигурация вычислительных блоков GP100, рассчитанная в том числе на научные задачи.
При этом близкие результаты OpenCL не означают равную производительность в играх, рендеринге или нейросетях.
Tesla V100 SXM2 заметно быстрее P100 благодаря архитектуре Volta, большему количеству вычислительных блоков и более высокой пропускной способности памяти. Кроме того, V100 получила Tensor Cores, отсутствующие у Pascal.
Для каких задач P100 SXM2 ещё подходит
Несмотря на возраст, GP100 нельзя считать бесполезным. У него остаются преимущества в задачах, способных задействовать особенности архитектуры:
- Научные расчёты и моделирование с интенсивным использованием FP64.
- Вычисления CUDA на совместимом программном обеспечении.
- Обработка массивов данных, для которой полезна высокая пропускная способность HBM2.
- Эксперименты с серверными GPU и многопроцессорными конфигурациями NVLink.
В операциях FP16 P100 SXM2 достигает теоретических 21,2 TFLOPS. Однако этот показатель не следует напрямую сравнивать с производительностью Tensor Cores у более современных ускорителей. Различия в архитектуре и наборе поддерживаемых операций слишком велики.
Локальные нейросети и ограничения CUDA в 2026 году
Наличие 16 ГБ видеопамяти делает P100 привлекательной для запуска локальных языковых моделей. Например, квантованные модели на 7-8 миллиардов параметров могут полностью размещаться в памяти ускорителя при подходящих настройках.
Но объём памяти - только одна из характеристик, определяющих удобство работы с LLM.
GP100 относится к архитектуре Pascal с уровнем вычислительных возможностей CUDA 6.0. Последняя версия CUDA Toolkit, поддерживающая сборку программ под Pascal, - 12.9. В CUDA 13 поддержку этой архитектуры при компиляции новых приложений прекратили. Последняя ветка драйверов NVIDIA с поддержкой Pascal - R580.
Это не означает, что старые программы внезапно перестали работать. Однако новые версии библиотек машинного обучения могут требовать более современной архитектуры. Для запуска некоторых моделей приходится устанавливать старые версии программ или самостоятельно собирать совместимые компоненты.
Отсутствие Tensor Cores ограничивает скорость современных нейросетевых вычислений. Поэтому P100 SXM2 с её 16 ГБ HBM2 не обязательно окажется быстрее потребительской RTX с меньшим объёмом памяти.
Для локальных LLM важнее проверить поддержку конкретной модели и программной среды, чем ориентироваться на показатели FP16 или пропускную способность памяти.
Стоит ли покупать Tesla P100 SXM2 в 2026 году
Если уже имеется сервер с совместимыми разъёмами SXM2, Tesla P100 остаётся пригодной для расчётов FP64 и работы со старым программным обеспечением CUDA. Низкая цена на вторичном рынке делает её привлекательной для таких систем.
В обычном настольном компьютере ситуация другая. Прибавка к производительности относительно P100 PCIe невелика, а расходы на переходник, охлаждение и питание могут превысить стоимость самого ускорителя.
Для экспериментов с локальными LLM удобнее использовать более современную GeForce RTX с Tensor Cores и поддержкой актуального ПО. Если же нужна именно архитектура GP100, версия PCIe 16 GB избавляет от необходимости искать переходник SXM2, хотя для неё тоже требуется мощный направленный обдув.
Итог: Tesla P100 SXM2 - всё ещё производительный ускоритель FP64, но плохой кандидат для бюджетной сборки обычного ПК. Покупка оправдана при наличии совместимого оборудования или ради технического эксперимента. Экономить на покупке самого модуля, чтобы затем переплатить за его подключение, обычно невыгодно.
Сравнение GPU
Сравнить Tesla P100 SXM2 с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Похожие сравнения видеокарт

Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/index.php/ru/gpu/nvidia-tesla-p100-sxm2" target="_blank">NVIDIA Tesla P100 SXM2</a>