NVIDIA Tesla P100 SXM2

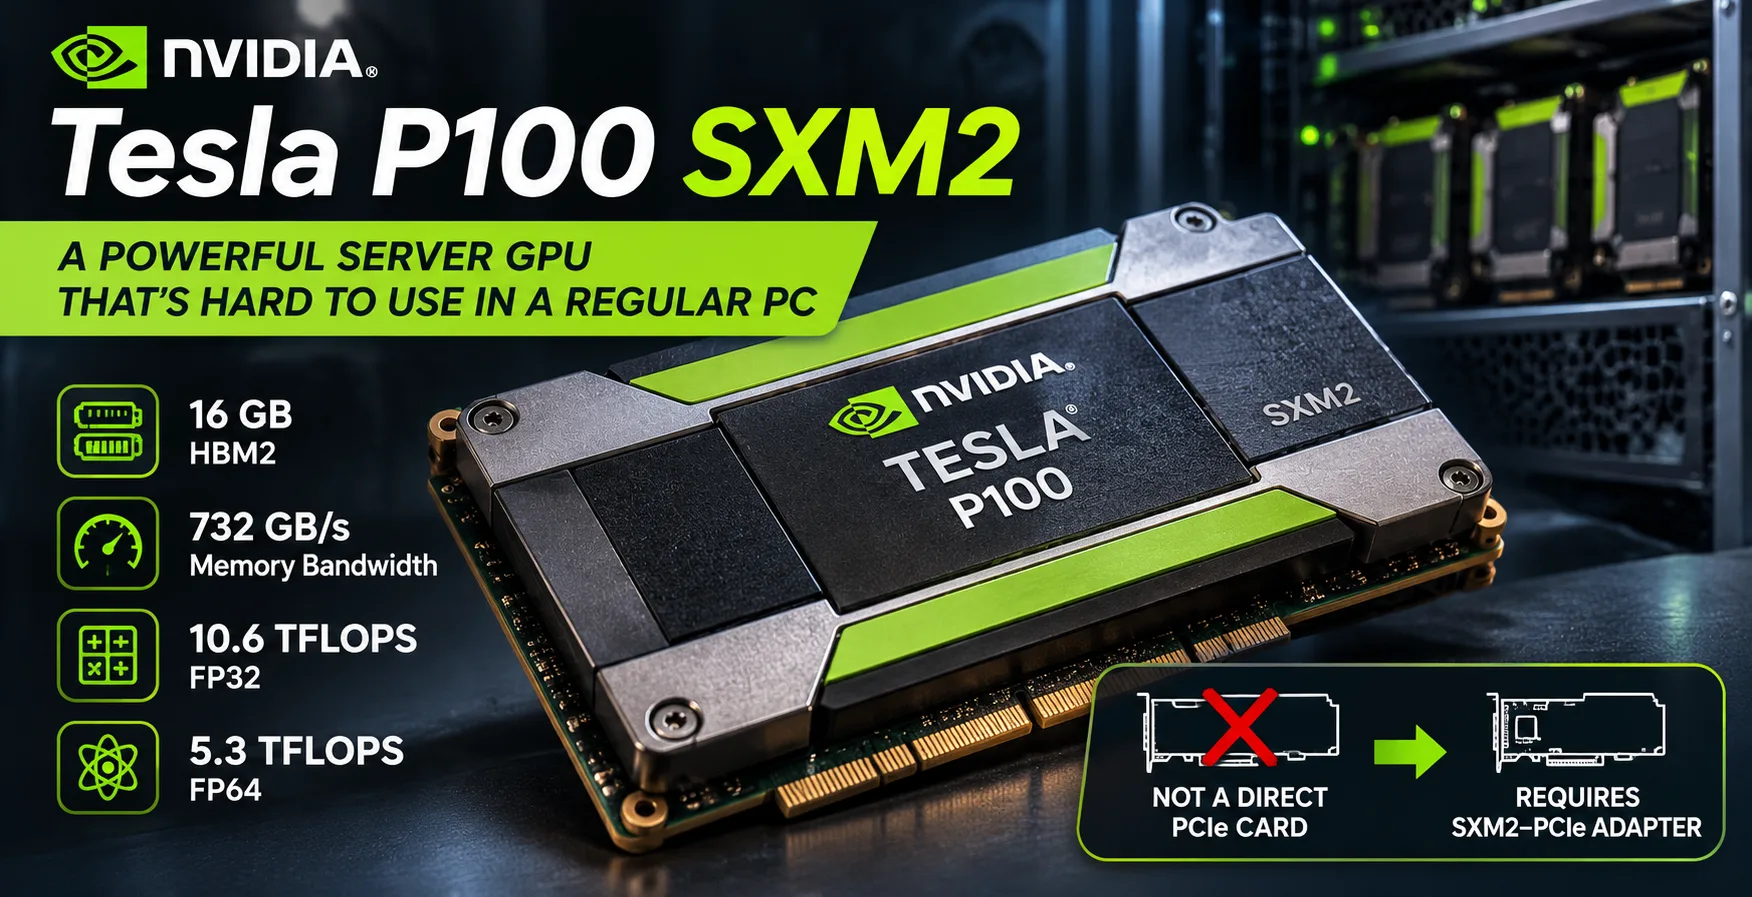
NVIDIA Tesla P100 SXM2: uma GPU de servidor barata e difícil de instalar em um PC comum
A NVIDIA Tesla P100 SXM2 atrai entusiastas pela combinação de 16 GB de memória HBM2, alto desempenho em FP64 e baixo preço no mercado de usados. Mas esse acelerador de 2016 tem uma séria desvantagem: em vez do PCIe padrão, ele usa o conector de servidor SXM2. Para instalá-lo em um computador comum, são necessários um adaptador, um sistema de refrigeração separado e uma verificação de compatibilidade. Como resultado, o módulo barato pode acabar custando mais do que uma versão PCIe mais conveniente.
Por que é difícil conectar a SXM2 a um PC comum
A Tesla P100 SXM2 foi criada para servidores especializados, incluindo os sistemas NVIDIA DGX. Ela não tem um conector PCIe padrão e não pode ser instalada diretamente no slot da placa-mãe.
Adaptadores SXM2-PCIe podem ser encontrados no mercado de usados, mas a existência de um conector adequado ainda não garante o funcionamento. Antes da compra, é preciso resolver várias questões:
- Alimentação. O acelerador consome até 300 W. O adaptador precisa fornecer a alimentação necessária ao módulo.
- Refrigeração. A SXM2 foi projetada para um sistema de refrigeração de servidor. Em um gabinete comum, é necessário um dissipador compatível com fluxo de ar suficientemente potente.
- Compatibilidade. É preciso verificar o suporte ao módulo específico por parte do adaptador, da placa-mãe e do driver.
- Ausência de saídas de vídeo. A Tesla P100 não foi projetada para a conexão direta de um monitor.
Os custos adicionais podem eliminar completamente a vantagem da compra. Segundo uma estimativa do mercado de usados dos Estados Unidos em agosto de 2026, módulos P100 SXM2 funcionais eram vendidos por aproximadamente $47-60. Ao mesmo tempo, um dos adaptadores SXM2-PCIe com suporte declarado à P100 era oferecido em setembro por aproximadamente $109 - sem considerar os custos adicionais de refrigeração e envio.
Nesse exemplo, o preço do adaptador é quase o dobro do custo do próprio acelerador. Portanto, não faz sentido avaliar a compra de uma SXM2 apenas pelo preço do módulo.
Diferenças entre a Tesla P100 SXM2 e a P100 PCIe
As duas versões são baseadas no mesmo processador gráfico GP100 da arquitetura Pascal. Ambas têm 3584 núcleos CUDA, e as variantes com 16 GB de HBM2 oferecem a mesma largura de banda de memória - 732 GB/s.
As principais diferenças estão relacionadas às frequências, à alimentação e à conexão.
| Característica | Tesla P100 SXM2 | Tesla P100 PCIe 16 GB |
|---|---|---|
| Conexão | SXM2 | PCIe 3.0 x16 |
| Frequência base | 1328 MHz | 1126 MHz |
| Frequência Boost | 1480 MHz | 1303 MHz |
| Interconexão da GPU | NVLink, até 160 GB/s | PCIe 3.0 |
| Potência máxima | 300 W | 250 W |
As frequências mais altas dão à SXM2 uma vantagem de aproximadamente 14% no desempenho computacional teórico em FP32. No entanto, sua potência máxima é 50 W maior.
Outra vantagem da SXM2 é o NVLink, que permite aos aceleradores trocar dados entre si. Esse recurso é útil em servidores multiprocessadores compatíveis. Quando instalada por meio de um adaptador PCIe comum, a vantagem do NVLink é perdida.
Para um acelerador único em um PC desktop, as vantagens da SXM2 sobre a PCIe são relativamente pequenas.
Desempenho e benchmarks
A GP100 se diferencia da maioria das GPUs de consumo pela alta velocidade de cálculo em precisão dupla FP64. Na Tesla P100 SXM2, ela chega a 5,3 TFLOPS, o que torna o acelerador adequado para cálculos científicos e modelagem numérica.
Para comparação, foram usados resultados do Geekbench 7 OpenCL e o desempenho computacional teórico de várias placas de vídeo específicas.
| Placa de vídeo | Geekbench 7 OpenCL | FP32, TFLOPS | FP64, TFLOPS |
|---|---|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 | 15,7 | 7,8 |
| NVIDIA GeForce RTX 3060 | 88 251 | 12,7 | 0,20 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 | 10,6 | 5,3 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 | 9,3 | 4,7 |
| NVIDIA Tesla T4 16 GB | 61 276 | 8,1 | ~0,25 |
Geekbench 7 OpenCL - resultados do ranking público do Geekbench em outubro de 2026; quanto maior, melhor. FP32 e FP64 são indicadores teóricos, não resultados do Geekbench. Eles são apresentados para comparar as capacidades computacionais das arquiteturas.
No Geekbench, a P100 SXM2 obtém aproximadamente 22% mais pontos do que a versão PCIe de 16 GB. A diferença é mais perceptível do que o sugerido pelas especificações oficiais, mas os resultados foram obtidos em sistemas diferentes e não permitem considerar esse ganho garantido.
A situação é mais interessante no caso da GeForce RTX 3060. As pontuações são praticamente iguais, mas, em FP64, a Tesla de servidor teoricamente supera a RTX 3060 em mais de 26 vezes. A razão é a configuração especializada das unidades computacionais da GP100, projetada também para tarefas científicas.
Ao mesmo tempo, resultados semelhantes no OpenCL não significam desempenho equivalente em jogos, renderização ou redes neurais.
A Tesla V100 SXM2 é significativamente mais rápida do que a P100 graças à arquitetura Volta, ao maior número de unidades computacionais e à maior largura de banda da memória. Além disso, a V100 recebeu Tensor Cores, ausentes na Pascal.
Para quais tarefas a P100 SXM2 ainda é adequada
Apesar da idade, a GP100 não pode ser considerada inútil. Ela ainda oferece vantagens em tarefas capazes de aproveitar os recursos específicos da arquitetura:
- Cálculos científicos e modelagem com uso intensivo de FP64.
- Cálculos CUDA em softwares compatíveis.
- Processamento de grandes conjuntos de dados, beneficiado pela alta largura de banda da HBM2.
- Experimentos com GPUs de servidor e configurações multiprocessador com NVLink.
Em operações FP16, a P100 SXM2 alcança 21,2 TFLOPS teóricos. No entanto, esse indicador não deve ser comparado diretamente ao desempenho dos Tensor Cores de aceleradores mais modernos. As diferenças na arquitetura e no conjunto de operações suportadas são grandes demais.
Modelos de linguagem locais e as limitações do CUDA em 2026
A presença de 16 GB de memória de vídeo torna a P100 atraente para a execução de modelos de linguagem locais. Por exemplo, modelos quantizados com 7-8 bilhões de parâmetros podem ser armazenados integralmente na memória do acelerador com as configurações adequadas.
Mas a quantidade de memória é apenas uma das características que determinam a praticidade de trabalhar com LLMs.
A GP100 pertence à arquitetura Pascal, com capacidade de computação CUDA 6.0. A última versão do CUDA Toolkit a oferecer suporte à compilação de programas para Pascal é a 12.9. No CUDA 13, o suporte a essa arquitetura foi encerrado na compilação de novos aplicativos. A última linha de drivers da NVIDIA com suporte à Pascal é a R580.
Isso não significa que programas antigos tenham deixado de funcionar repentinamente. No entanto, versões novas de bibliotecas de aprendizado de máquina podem exigir uma arquitetura mais moderna. Para executar alguns modelos, é necessário instalar versões antigas dos programas ou compilar componentes compatíveis por conta própria.
A ausência de Tensor Cores limita a velocidade dos cálculos modernos de redes neurais. Por isso, a P100 SXM2 com seus 16 GB de HBM2 não será necessariamente mais rápida do que uma RTX de consumo com menor quantidade de memória.
Para LLMs locais, é mais importante verificar o suporte ao modelo específico e ao ambiente de software do que se orientar pelos indicadores de FP16 ou pela largura de banda da memória.
Vale a pena comprar uma Tesla P100 SXM2 em 2026?
Se você já tem um servidor com conectores SXM2 compatíveis, a Tesla P100 continua adequada para cálculos em FP64 e para trabalhar com softwares CUDA antigos. O baixo preço no mercado de usados torna-a atraente para esses sistemas.
Em um computador desktop comum, a situação é diferente. O ganho de desempenho em relação à P100 PCIe é pequeno, e os custos do adaptador, da refrigeração e da alimentação podem superar o preço do próprio acelerador.
Para experimentar LLMs locais, é mais conveniente usar uma GeForce RTX mais moderna, com Tensor Cores e suporte a softwares atuais. Se a arquitetura GP100 for exatamente o que você procura, a versão PCIe de 16 GB elimina a necessidade de encontrar um adaptador SXM2, embora ela também exija um fluxo de ar direcionado e potente.
Conclusão: a Tesla P100 SXM2 ainda é um acelerador de FP64 de alto desempenho, mas é uma má escolha para uma montagem econômica de PC comum. A compra faz sentido quando já existe equipamento compatível ou como experimento técnico. Economizar na compra do módulo para depois pagar mais pela sua conexão geralmente não é vantajoso.
Comparação de GPU
Comparar Tesla P100 SXM2 com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Comparações de GPU relacionadas

Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/index.php/pt/gpu/nvidia-tesla-p100-sxm2" target="_blank">NVIDIA Tesla P100 SXM2</a>