NVIDIA Tesla P100 SXM2

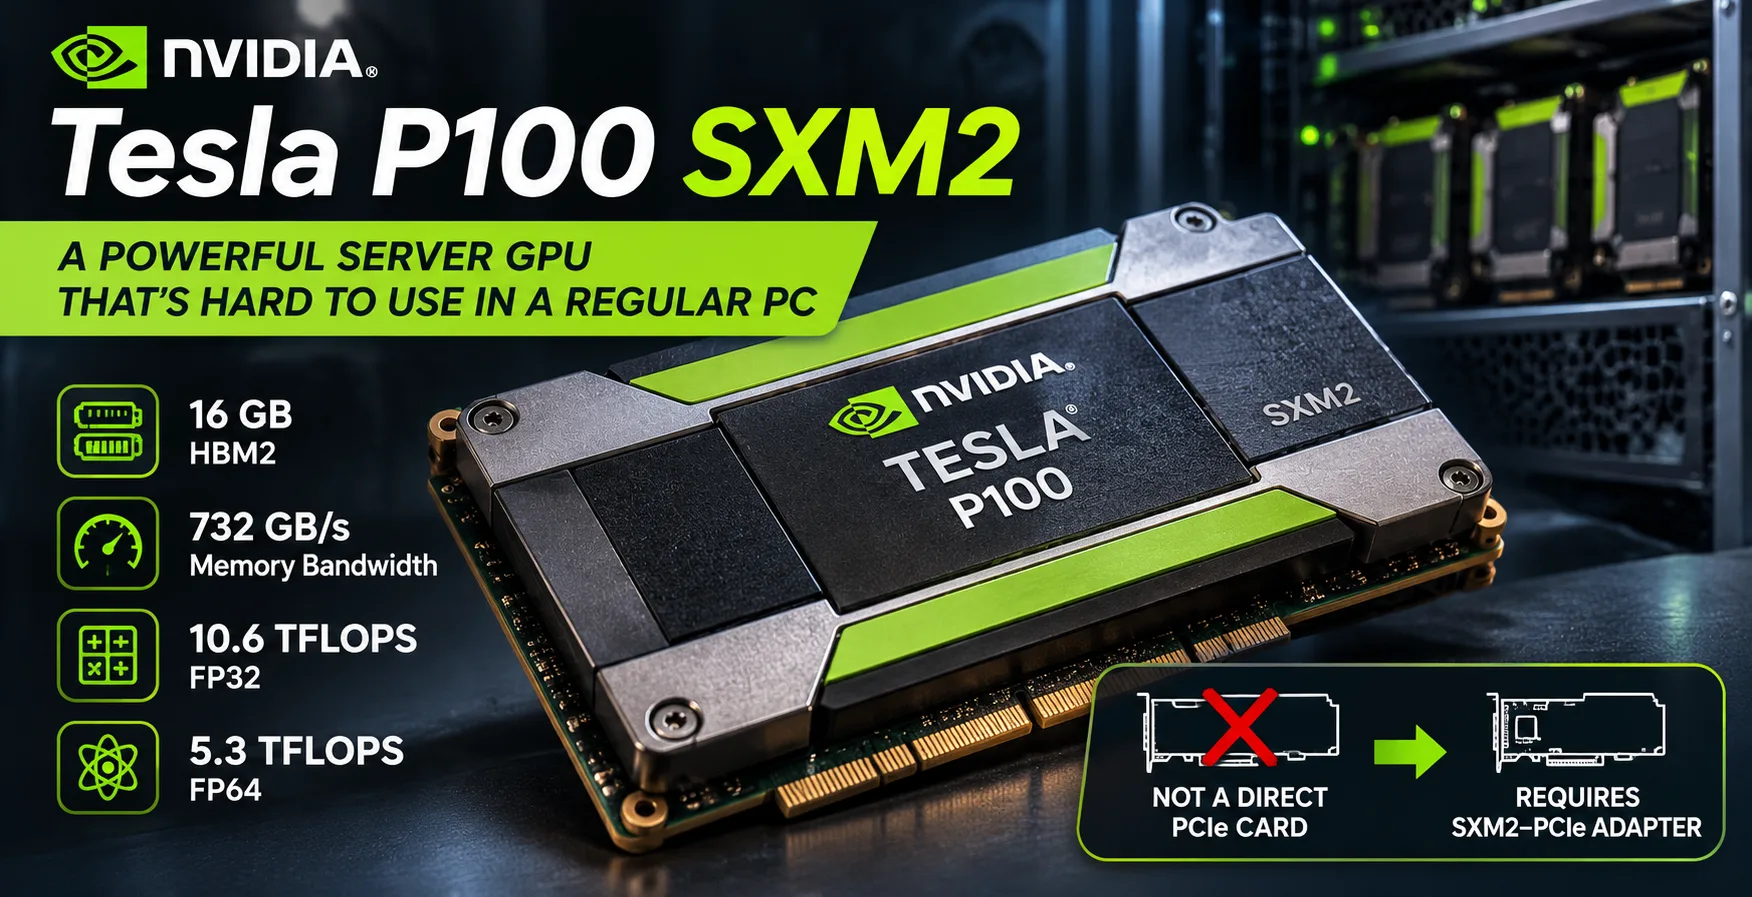
NVIDIA Tesla P100 SXM2:安価なサーバー向けGPUだが、一般的なPCへの取り付けは難しい
NVIDIA Tesla P100 SXM2は、16 GBのHBM2、高いFP64性能、中古市場での安価な価格を組み合わせている点から、愛好家の注目を集めている。しかし、2016年のこのアクセラレーターには重大な欠点がある。標準的なPCIeではなく、サーバー向けのSXM2コネクターを採用しているのだ。一般的なコンピューターに取り付けるには、変換アダプター、別途用意する冷却装置、互換性の確認が必要になる。その結果、安価なモジュールが、より扱いやすいPCIe版よりも高くつく可能性がある。
SXM2を一般的なPCに接続するのが難しい理由
Tesla P100 SXM2は、NVIDIA DGXシステムを含む専用サーバー向けに設計された。標準的なPCIeコネクターを備えていないため、マザーボードのスロットに直接取り付けることはできない。
中古市場ではSXM2-PCIe変換アダプターが見つかることもあるが、適切なコネクターがあるだけで動作が保証されるわけではない。購入前に、いくつかの問題を解決する必要がある。
- 電源。 アクセラレーターの消費電力は最大300 Wに達する。変換アダプターは、モジュールに必要な電力を供給できなければならない。
- 冷却。 SXM2はサーバーの冷却システムを前提としている。一般的なPCケースで使用するには、十分に強力なエアフローを備えた互換ラジエーターが必要になる。
- 互換性。 使用するモジュールが、変換アダプター、マザーボード、ドライバーに対応しているか確認しなければならない。
- 映像出力がない。 Tesla P100は、モニターを直接接続する用途を想定していない。
追加費用によって、購入によるメリットが完全に失われる可能性もある。2026年8月時点の米国中古市場の相場によると、動作するP100 SXM2モジュールはおよそ$47~60で販売されていた。一方、P100への対応をうたうSXM2-PCIe変換アダプターの1製品は、9月に約$109で販売されていた。冷却装置や送料にかかる追加費用は含まれていない。
この例では、変換アダプターの価格がアクセラレーター本体の価格のほぼ2倍に達する。そのため、SXM2の購入をモジュール単体の価格だけで判断するのは意味がない。
Tesla P100 SXM2とP100 PCIeの違い
両モデルは、Pascalアーキテクチャの同じGPU、GP100を搭載している。CUDAコア数はいずれも3584で、16 GBのHBM2を搭載するモデルは、同じ732 GB/sのメモリ帯域幅を備えている。
主な違いは、動作周波数、電源、接続方式にある。
| 仕様 | Tesla P100 SXM2 | Tesla P100 PCIe 16 GB |
|---|---|---|
| 接続 | SXM2 | PCIe 3.0 x16 |
| ベースクロック | 1328 MHz | 1126 MHz |
| Boostクロック | 1480 MHz | 1303 MHz |
| GPU間インターコネクト | NVLink、最大160 GB/s | PCIe 3.0 |
| 最大消費電力 | 300 W | 250 W |
高い動作周波数により、SXM2は理論上のFP32演算性能で約14%上回る。一方、最大消費電力は50 W高い。
もう1つのSXM2のメリットは、アクセラレーター同士のデータ交換を可能にするNVLinkだ。この機能は、対応するマルチプロセッサーサーバーで有用になる。ただし、一般的な変換アダプターを介してPCIeに接続した場合、NVLinkのメリットは失われる。
デスクトップPCでアクセラレーターを1基だけ使用する場合、SXM2がPCIe版を上回るメリットは比較的小さい。
パフォーマンスとベンチマーク
GP100は、FP64倍精度演算の高い処理速度によって、一般的なコンシューマー向けGPUとは異なる。Tesla P100 SXM2では最大5.3 TFLOPSに達し、科学計算や数値シミュレーションに適したアクセラレーターとなっている。
比較には、Geekbench 7 OpenCLの結果と、複数の特定グラフィックスカードの理論演算性能を使用した。
| グラフィックスカード | Geekbench 7 OpenCL | FP32、TFLOPS | FP64、TFLOPS |
|---|---|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 | 15.7 | 7.8 |
| NVIDIA GeForce RTX 3060 | 88 251 | 12.7 | 0.20 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 | 10.6 | 5.3 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 | 9.3 | 4.7 |
| NVIDIA Tesla T4 16 GB | 61 276 | 8.1 | ~0.25 |
Geekbench 7 OpenCLは、2026年10月時点のGeekbench公開ランキングの結果で、数値が大きいほど高性能を示す。FP32とFP64はGeekbenchの結果ではなく、理論値である。アーキテクチャの演算能力を比較するために記載している。
Geekbenchでは、P100 SXM2は16 GBのPCIe版より約22%高いスコアを記録する。仕様上の性能差から予想される以上の違いだが、異なるシステムで得られた結果であり、この伸びが保証されるわけではない。
GeForce RTX 3060との比較は、より興味深い。Geekbenchのスコアはほぼ一致しているものの、FP64ではサーバー向けTeslaが理論上、RTX 3060を26倍以上上回る。その理由は、GP100の演算ブロックが、科学計算を含む用途を想定した専用構成になっているためだ。
ただし、OpenCLで近い結果になったからといって、ゲーム、レンダリング、ニューラルネットワークで同等の性能を発揮するわけではない。
Tesla V100 SXM2は、Voltaアーキテクチャ、より多い演算ブロック、より高いメモリ帯域幅により、P100より明らかに高速だ。さらにV100には、PascalにはないTensor Coreも搭載されている。
P100 SXM2が今も適している用途
登場から時間が経っているとはいえ、GP100を役に立たないGPUとみなすことはできない。アーキテクチャの特性を活用できる用途では、依然としてメリットがある。
- FP64を多用する科学計算やシミュレーション
- 対応ソフトウェアでのCUDA計算
- HBM2の高いメモリ帯域幅が有効な大規模データ処理
- サーバー向けGPUや、NVLinkを用いたマルチプロセッサー構成の実験
FP16演算では、P100 SXM2は理論上21.2 TFLOPSに達する。ただし、この数値を、より新しいアクセラレーターのTensor Core性能と直接比較すべきではない。アーキテクチャと対応する演算の種類には大きな違いがあるためだ。
2026年のローカルニューラルネットワークとCUDAの制限
16 GBのビデオメモリを備えているため、P100はローカルで言語モデルを実行する用途に魅力がある。例えば、量子化された70~80億パラメーターのモデルは、適切な設定であればアクセラレーターのメモリに完全に収められる可能性がある。
しかし、メモリ容量はLLMを快適に動作させる要素の1つにすぎない。
GP100は、CUDA Compute Capability 6.0のPascalアーキテクチャに属している。Pascal向けのプログラムのビルドをサポートする最後のCUDA Toolkitは12.9だ。CUDA 13では、新しいアプリケーションのコンパイル時にこのアーキテクチャのサポートが打ち切られた。PascalをサポートするNVIDIAのドライバーの最新ブランチはR580である。
これは、古いプログラムが突然動作しなくなったという意味ではない。ただし、機械学習ライブラリの新しいバージョンでは、より新しいアーキテクチャが必要になる場合がある。一部のモデルを実行するには、古いバージョンのソフトウェアをインストールするか、互換性のあるコンポーネントを自分でビルドしなければならない。
Tensor Coreがないため、最新のニューラルネットワーク処理の速度には制約がある。そのため、16 GBのHBM2を備えるP100 SXM2が、より少ないメモリ容量のコンシューマー向けRTXより高速になるとは限らない。
ローカルLLMでは、FP16の性能やメモリ帯域幅を基準にするよりも、使用するモデルとソフトウェア環境が対応しているかを確認することが重要だ。
2026年にTesla P100 SXM2を購入すべきか
互換性のあるSXM2コネクターを備えたサーバーをすでに所有しているなら、Tesla P100はFP64計算や、古いCUDAソフトウェアの実行に今でも利用できる。中古市場での価格が安いことも、こうしたシステムにとって魅力となる。
一般的なデスクトップPCでは、事情が異なる。P100 PCIeに対する性能向上は小さく、変換アダプター、冷却装置、電源にかかる費用がアクセラレーター本体の価格を上回る可能性がある。
ローカルLLMを試すなら、Tensor Coreを搭載し、現在のソフトウェアをサポートする、より新しいGeForce RTXのほうが扱いやすい。一方、GP100アーキテクチャそのものが必要なら、16 GBのPCIe版を選べばSXM2変換アダプターを探す必要はない。ただし、こちらも強力な指向性エアフローが必要になる。
まとめ: Tesla P100 SXM2は、FP64に関しては今でも高性能なアクセラレーターだが、一般的なPCを低予算で組む際の候補としては適していない。互換性のある機器をすでに所有している場合や、技術的な実験を目的とする場合には、購入する意味がある。モジュール本体を安く購入しても、接続のためにその後で余計な費用を払うことになれば、通常は得策ではない。
GPUの比較
Tesla P100 SXM2を他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較
関連する GPU の比較

ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-tesla-p100-sxm2" target="_blank">NVIDIA Tesla P100 SXM2</a>