NVIDIA Tesla P100 DGXS

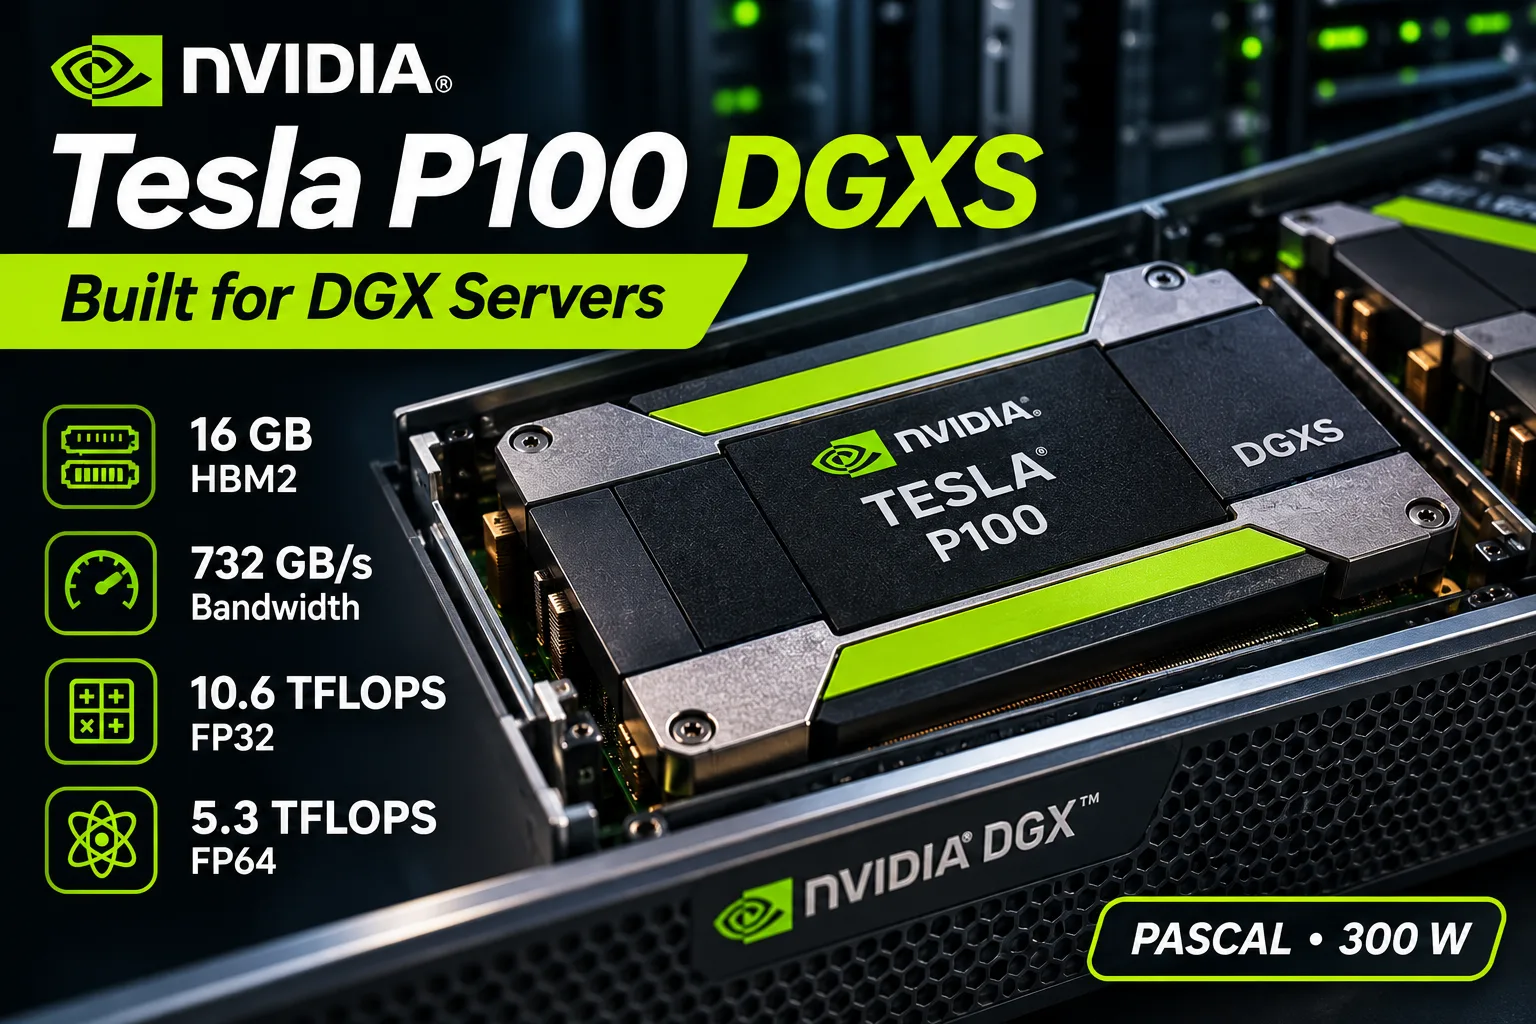
Tesla P100 DGXS:データベースには存在するが、市場にはないアクセラレーター
NVIDIA Tesla P100 DGXSは、16 GBのHBM2、1328~1480 MHzのクロック、300 Wの消費電力を備えた独立モデルとして、ビデオカードのカタログに掲載されている。しかし、これらの仕様を示す公式文書や独立したテスト、このバージョンの販売を裏付ける情報は見つからなかった。一方で、NVIDIAのドライバーにはP100-DGXSという名称が存在し、同社の診断ソフトウェアからは、DGX Stationに関連するGP100の追加構成も見つかっている。
このため、P100 DGXSは特異な存在だ。対応する識別子の存在は確認されているものの、ボード自体が発売された経緯は明らかになっていない。
P100 DGXSは他のTesla P100とどう違うのか
すべてのTesla P100は、Pascalアーキテクチャに基づく16 nmのGP100プロセッサーを採用し、3584基のCUDAコアを搭載している。製品版の各モデルは、HBM2の容量、クロック、消費電力、接続方式が異なる。
| モデル | メモリ | 帯域幅 | クロック | 消費電力 |
|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 GB | 549 GB/s | 1189~1328 MHz | 250 W |
| Tesla P100 PCIe 16 GB | 16 GB | 732 GB/s | 1189~1328 MHz | 250 W |
| Tesla P100 SXM2 16 GB | 16 GB | 732 GB/s | 1328~1480 MHz | 300 W |
| Tesla P100 DGXS | 表記上は16 GB | 未確認 | 1328~1480 MHz(データベース上) | 300 W(データベース上) |
カタログに掲載されているDGXSの仕様は、P100 SXM2の仕様とほぼ一致している。類推によって転記された可能性はあるが、このバージョンに関するNVIDIAの公式仕様は見つかっていない。
DGXSのクロックが本当にSXM2と一致していたかどうかさえ、現時点では確認されていない。そのため、カタログに掲載された数値を使って性能を正確に比較することはできない。
NVIDIAの文書に残るP100 DGXSの痕跡
この構成の存在を示す最も有力な証拠は、PCI\VEN_10DE&DEV_15FCという識別子だ。2017年6月のNVIDIA製Windows向けドライバーのデータベースでは、これがTesla P100-DGXS-16GBとして記載されている。
さらに、サーバー向けアクセラレーターの診断設定を含む公式リポジトリNVIDIA DCGMにも、追加の情報がある。
そこには、今回関係する2つの記録が存在する。
- 15FA - DGX Station。 診断テストの目標電力が249 Wに設定されたGP100構成。
- 15FC - GP100 SKU 201。 テストの目標電力が299 Wに設定された別の構成。
2つ目の識別子は、ドライバーのデータベースにあるTesla P100-DGXS-16GBと一致する。ただし、DCGMにおける電力値は診断試験時の負荷を設定するものであり、定格TDPを示すものではない。
つまり、NVIDIAがDGX Stationという名称のバージョンを含む、複数のGP100構成を実際に用意していたことは確かだ。しかし、ソフトウェア上の記録だけでは、物理的なボードが何枚製造されたのか、また顧客に納入されたのかどうかまでは判断できない。
NVIDIA DGX Stationとの関係
P100 DGXSの経緯を複雑にしているのが、発表時期の問題だ。Tesla P100は2016年4月、DGX-1サーバーとともに発表された。一方、DGX StationをNVIDIAが正式に発表したのは、2017年5月10日になってからだった。
DGX Stationの最初の発表では、16 GBのHBM2を搭載したTesla V100を4基、NVLinkで接続していた。システムには液冷が採用され、価格は69,000ドルとされていた。
しかし2017年10月、ServeTheHomeは、DGX Stationが初期段階ではP100を4基搭載し、その後V100へ移行したと報じた。これは、すでにVoltaアクセラレーターが登場していたNVIDIAの当初の公式発表内容と食い違っている。
プロトタイプや事前構成についての話だった可能性はあるが、そのような出荷を裏付ける公開文書は見つかっていない。
したがって、カタログで見かけるP100 DGXSの発売時期――2016年4月――を確認済みの情報とみなすことはできない。この日付が示しているのはGP100の登場であって、DGXSモデルが実際に発売されたことではない。
性能:確認できること
Tesla P100 DGXSそのものを直接テストした公開結果は見つからなかった。GP100アーキテクチャの性能を評価するには、製品版のP100 PCIe 16 GBで測定された結果を利用できる。
コミュニティが公開したllama.cppの比較には、Llama 7B Q4_0モデルを実行した複数の具体的なGPUの結果が含まれている。
| GPU | プロンプト処理、トークン/秒 | 生成、トークン/秒 |
|---|---|---|
| Tesla V100 32 GB | 2974 | 134,8 |
| GeForce RTX 2080 Ti | 2891 | 107,5 |
| GeForce RTX 3060 12 GB | 2138 | 75,6 |
| GeForce GTX 1080 Ti | 1084 | 62,5 |
| Tesla P100 16 GB | 761 | 58,4 |
数値が大きいほど高性能。データはllama.cppコミュニティの参加者が公開したもの。使用したモデルは1種類だが、テストシステムとプログラムのバージョンは異なる。Tesla P100について示されているのはDGXSではなく、PCIe版の結果。
このテストでは、P100は生成速度でGTX 1080 Tiにほぼ並んでいるが、プロンプト処理では大きく遅れている。その理由の1つが、GP100にDP4A命令がないことだ。DP4Aは量子化データを使った計算を高速化する。
HBM2の高い帯域幅でも、この制限を補うことはできない。SXM2と同じクロックで動作したとしても、正体の明らかでないDGXSが不足している命令を獲得するわけではない。
もっとも、GP100には別の強みがある。それがFP64演算だ。製品版のP100 SXM2は倍精度で5.3 TFLOPS、PCIe版は4.7 TFLOPSに達する。このため、一部の科学技術計算では依然として魅力がある。ただし、DGXSの正確な性能を確定することはできない。
2026年時点のソフトウェアサポート
すべてのGP100アクセラレーターは、CUDAのCompute Capability 6.0に対応している。現行の機械学習ライブラリでは、これが深刻な制限になりつつある。
Pascal向けアプリケーションのコンパイルを可能にする最後のCUDA Toolkitは12.9だ。CUDA 13以降では、このアーキテクチャ向けのコンパイルサポートが削除された。Pascal向けのNVIDIAドライバーの最後の系列はR580で、そのサポート期間は2028年に終了する。
互換性のあるドライバーを使用すれば、古いCUDAプログラムは引き続き動作する。しかし、PyTorchなどのライブラリの新しいビルドでは、GP100がサポートされない可能性がある。Tensor Coreがないことも、ニューラルネットワークの計算性能をさらに制限する。
ローカル言語モデルでは、16 GBのHBM2は依然として有用だ。しかし、メモリ容量と帯域幅だけを基準にアクセラレーターを選ぶのでは、もはや十分とはいえない。
P100 DGXSは購入できるのか、代替製品は何か
公開されている中古市場で、Tesla P100 DGXSの販売を裏付ける出品は見つからなかった。また、その物理構造の詳細も不明だ。デバイス識別子だけでは、コネクターの配置、冷却システム、一般的なマザーボードとの互換性を判断できない。
GP100アーキテクチャのアクセラレーターが必要なら、より確実な選択肢がある。
- Tesla P100 PCIe 16 GB。 標準的なPCIe接続、16 GBのHBM2、最大4.7 TFLOPSのFP64性能を備える。強力な指向性のある冷却風と、適切な電源が必要。
- Tesla P100 SXM2 16 GB。 より高い性能を持ち、対応サーバーではNVLinkを利用できる。一般的なPCで使うには、変換アダプターと別途冷却システムが必要。
- Tesla V100 SXM2 16 GB。 Voltaアーキテクチャ、Tensor Core、最大7.8 TFLOPSのFP64性能を備える。対応する機械学習タスクには大幅に有利だが、こちらも専用の接続方式が必要。
現代のローカルLLMを実行するなら、ビデオメモリ容量が少なくても、Tensor Coreとより新しいアーキテクチャを備えたGeForce RTXのほうが実用的な場合が多い。
結論
Tesla P100 DGXSは、NVIDIAのソフトウェアエコシステムに実在する名称ではあるが、文書で確認された量産モデルではない。ドライバーとDCGMに存在する識別子は、GP100に複数の個別構成があったことを示している。しかし、それらが商用に出荷されたのか、どのような仕様で製造されたのかは明らかになっていない。
追加の証拠なしに、DGXSへP100 SXM2の仕様をそのまま当てはめるのは不適切だ。科学技術計算やCUDAの実験には、仕様が明確で、テスト結果も利用できる製品版のP100 PCIeまたはSXM2を選ぶほうがよい。
P100 DGXSは、2026年に実際に購入する選択肢というより、NVIDIA DGXの知られざる歴史の一部として興味深い存在だ。
GPUの比較
Tesla P100 DGXSを他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較


ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-tesla-p100-dgxs" target="_blank">NVIDIA Tesla P100 DGXS</a>