NVIDIA GeForce RTX 5080
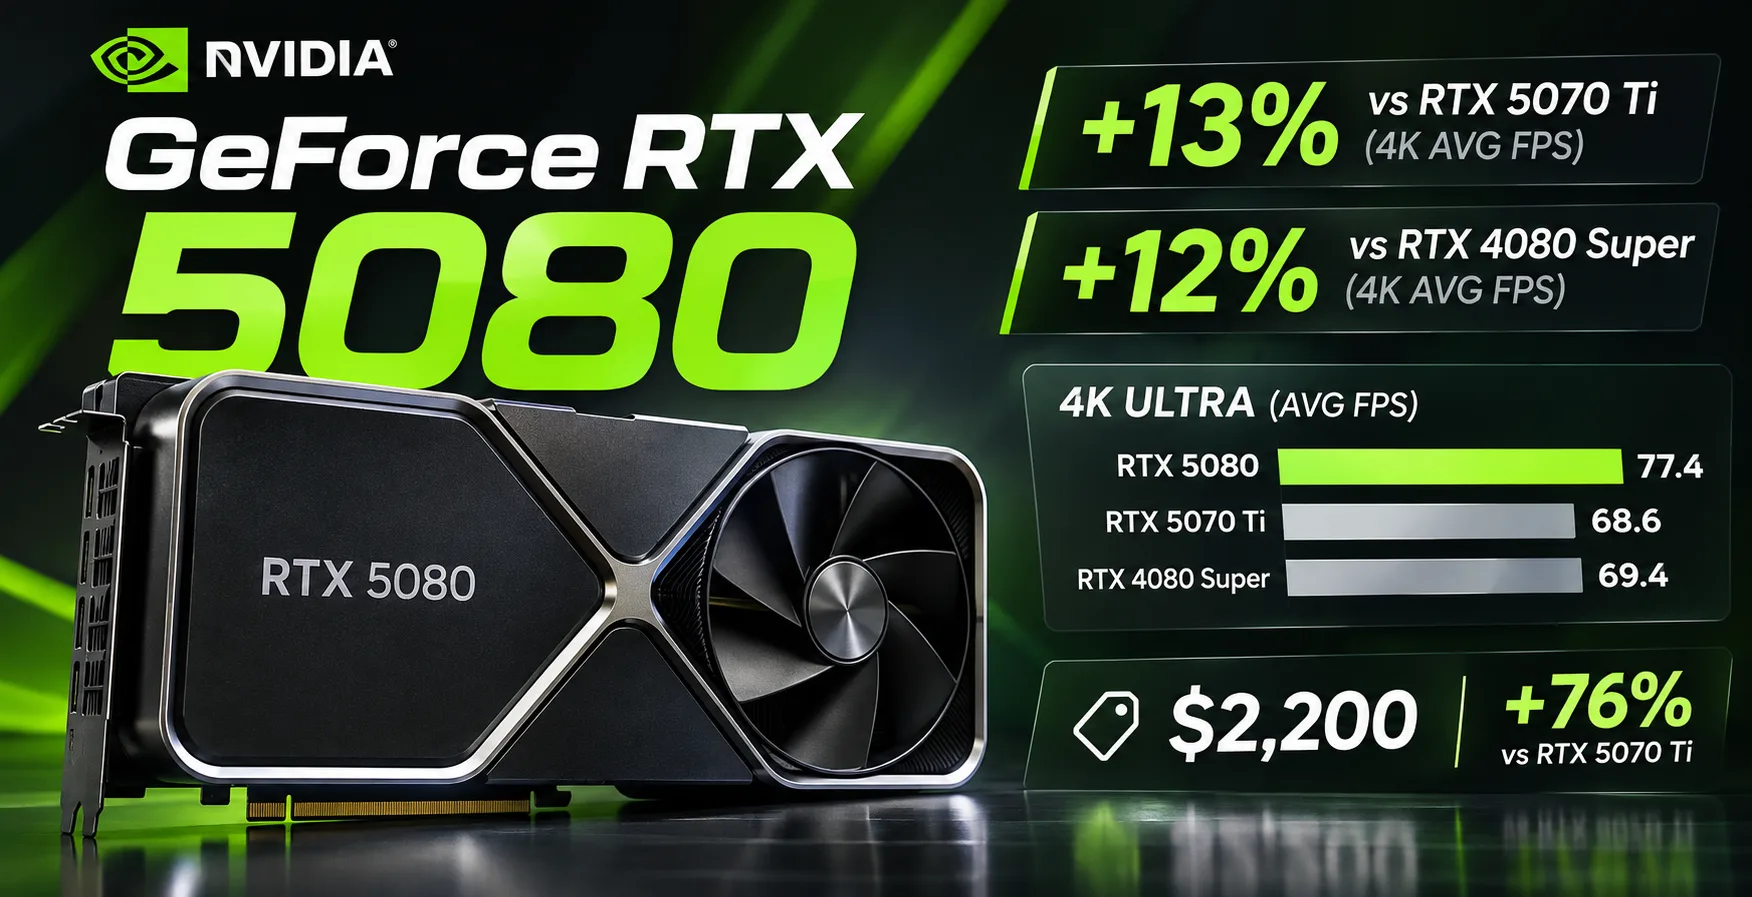
GeForce RTX 5080:4KでRTX 5070 Tiより13%高速、価格は76%高い
GeForce RTX 5080は2025年1月に$999で発売されたが、2026年10月には米国で購入可能な製品の最安価格が$2200に達した。一方、$1250のRTX 5070 Tiは、4Kの平均フレームレートでわずか13%の差にとどまる。価格差は$950に達するが、両カードとも16 GBのビデオメモリを搭載し、DLSS Multi Frame Generationに対応している。
RTX 4080 Superからの更新幅も小さい。Tom's Hardwareのテスト結果では、RTX 5080はレイトレーシングなしの4Kで、前世代モデルより約12%高速だった。RTX 5070 Tiに対する優位性が最も目立つのは、負荷の高いレイトレーシングを使うゲームだが、それでも性能向上は価格差に見合っていない。
BlackwellとGDDR7:何が変わったのか
RTX 5080は、10,752基のCUDAコアを備えるGB203 GPUを採用している。メモリにはGDDR6Xを採用したRTX 4080 Superに代わり、帯域幅960 GB/sのGDDR7を搭載する。メモリ帯域幅は30%増加したが、容量は変わっていない。
| 仕様 | RTX 5080 | RTX 4080 Super | RTX 5070 Ti |
|---|---|---|---|
| アーキテクチャ | Blackwell | Ada Lovelace | Blackwell |
| CUDAコア | 10,752 | 10,240 | 8,960 |
| メモリ | 16 GB GDDR7 | 16 GB GDDR6X | 16 GB GDDR7 |
| 帯域幅 | 960 GB/s | 736 GB/s | 896 GB/s |
| ブーストクロック | 2617 MHz | 2550 MHz | 2452 MHz |
| TGP | 360 W | 320 W | 300 W |
RTX 5080は、第4世代RTコア、第5世代Tensorコア、PCIe 5.0、DisplayPort 2.1bを備えている。
公称TGPは320 Wから360 Wに増加したが、実際の消費電力は負荷によって異なる。NVIDIAは850 Wの電源ユニットを推奨している。接続には16ピン電源ケーブル、または3本の8ピンコネクターに接続する付属アダプターを使用する。
3DMark Time Spy
| グラフィックスカード | Graphics Score |
|---|---|
| GeForce RTX 4090 | 36,676 |
| GeForce RTX 5080 | 31,987 |
| Radeon RX 9070 XT | 29,464 |
| GeForce RTX 4080 Super | 27,920 |
| GeForce RTX 5070 Ti | 27,727 |
ComputerBaseの結果。
RTX 5080はRTX 4080 SuperとRTX 5070 Tiを約15%上回るが、前世代のRTX 4090には及ばない。
ゲームテスト:アップスケーリングなしの1440pと4K
Tom's Hardwareが2026年6月にまとめた結果では、DLSS、FSR、フレーム生成を使わずにグラフィックスカードを比較できる。
| グラフィックスカード | 1440p Ultra | 4K Ultra | 4K(RT) |
|---|---|---|---|
| RTX 4090 | 143.4 | 89.1 | 52.2 |
| RTX 5080 | 128.3 | 77.4 | 42.1 |
| RTX 4080 Super | 118.6 | 69.4 | 38.5 |
| RTX 5070 Ti | 116.8 | 68.6 | 36.7 |
| Radeon RX 9070 XT | 116.5 | 65.8 | 30.1 |
平均FPS。ラスタライズとレイトレーシングは、それぞれ別のゲームセットで測定。
1440pではRTX 5080がRTX 5070 Tiを10%上回り、4Kでは差が13%に広がる。RTX 4080 Superに対する新カードの優位性は4Kで約12%で、RTX 4090は依然として首位を維持している。
レイトレーシングでは、RTX 5080はRTX 5070 Tiを最大15%、Radeon RX 9070 XTを40%上回る。ただし、RTを有効にした4Kで平均42 FPSにとどまるため、より高いフレームレートを得るにはアップスケーリングを使うか、設定を下げる必要がある。
Death Stranding 2:DLSSとFSRで比較
2026年3月に行われたComputerBaseのテストでは、非常に高いグラフィックス設定を使用し、NVIDIAにはDLSS 4 Quality、Radeon RX 9000にはFSR 4.1 Qualityを適用した。フレーム生成は無効にしている。
| グラフィックスカード | 1440p | 4K | 4K(RT) |
|---|---|---|---|
| RTX 4090 | 124.8 | 105.5 | 65.5 |
| RTX 5080 | 125.8 | 96.4 | 57.0 |
| RTX 4080 Super | 104.1 | 82.3 | 49.2 |
| RTX 5070 Ti | 110.4 | 84.6 | 49.2 |
| Radeon RX 9070 XT | 106.9 | 79.0 | 41.2 |
平均FPS。RTモードでは最大レベルのレイトレーシングを使用。DLSSとFSRでは画質が異なる場合がある。
RTX 5080は4KでRTX 5070 Tiを14%、レイトレーシング有効時には16%上回る。RTX 4090は4Kで首位を維持するが、1440pでは新カードにわずかに後れを取る。
価格:追加の性能にいくら払うのか
TechSpotが2026年11月2日に公開した調査によると、10月に米国のショップで販売されていたグラフィックスカードの最安価格は、RTX 5080が$2200、RTX 5070 Tiが$1250、Radeon RX 9070 XTが$870だった。
| グラフィックスカード | 米国価格 | 4K FPS | FPS当たりの価格 |
|---|---|---|---|
| RTX 5080 | $2200 | 77.4 | $28.42 |
| RTX 5070 Ti | $1250 | 68.6 | $18.22 |
| Radeon RX 9070 XT | $870 | 65.8 | $13.22 |
FPS当たりの価格は、レイトレーシングなしの4K Ultraにおける平均結果を基に算出。性能に対する価格を比較するためだけの指標。
1 FPS当たりで見ると、RTX 5080はRTX 5070 Tiより56%高い。Radeon RX 9070 XTは、RTX 5080の約85%の性能を、価格は2.5分の1で提供する。
RTX 5070 Tiも推奨価格の$749から大幅に値上がりしているが、RTX 5080と比較すれば、依然としてよりお買い得な選択肢だ。
DLSSとレイトレーシング
RTX 5080はDLSS Multi Frame Generationに対応している。これは、ゲームエンジンが計算したフレームの間に追加のフレームを生成する機能だ。映像の滑らかさは向上するが、操作の応答性が比例して改善するわけではない。
RTX 5070 Tiも同じ機能に対応している。RTX 5080の優位性は、特にパストレーシングを使うゲームで、元のフレームレートが高いことにある。高リフレッシュレートの4Kモニターを使う場合、この差は重要になる可能性がある。ただし、負荷の高いゲームでは、RTX 5080でもアップスケーリングなしでプレイできるとは限らない。
Blender、動画編集、ニューラルネットワーク
RTX 5080はCUDA、OptiX、ハードウェアAV1エンコードに対応している。第9世代NVENCビデオエンコーダーを2基搭載し、10ビットHEVC 4:2:2を含む、対応する動画フォーマットの処理を高速化できる。
Puget SystemsのテストにおけるBlender Benchmarkの結果は次のとおり。
| グラフィックスカード | Blender Benchmark |
|---|---|
| RTX 5090 | 15,872 |
| RTX 5080 | 9,035 |
| RTX 5070 Ti | 7,882 |
| Radeon RX 9070 XT | 3,722 |
RTX 5080はRTX 5070 Tiを15%上回る。Radeon RX 9070 XTはHIPを使ったレンダリングで大きく後れを取るため、Blenderを定期的に使う場合はNVIDIAのアクセラレーターのほうが適している。
ローカルでニューラルネットワークを実行する場合、RTX 5080は16 GBのビデオメモリが制約になる。たとえば、320億パラメーターの言語モデルを4ビット量子化した場合、補助データとKVキャッシュを含めると、通常はその容量全体に収まらない。正確な要件は、量子化形式とコンテキストサイズによって異なる。
モデルがVRAMに収まる場合、RTX 5080は高い演算速度を発揮する。より大規模なモデルでは、より高性能なGPUよりも、ビデオメモリの容量が大きいことのほうが有用な場合が多い。
2026年にGeForce RTX 5080を買うべきか
$2200という価格では、一般的なゲーム用途にRTX 5080を勧めるのは難しい。RTX 5070 Tiは$950安く、同じ16 GBのメモリを搭載し、4Kの平均FPSで劣るのはわずか13%にすぎない。高いレイトレーシング性能が必要でなければ、Radeon RX 9070 XTはさらに有利だ。
RTX 5080は、負荷の高いグラフィックス効果を使う4K環境や、16 GBのビデオメモリで足りるBlenderおよびCUDAタスクには意味がある。RTX 4080 Superの所有者は買い替えるべきではない。4Kで約12%という性能向上では、これほど高価な交換に見合わない。
GPUの比較
GeForce RTX 5080を他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
3x DisplayPort 2.1b
理論上の性能
その他
ベンチマーク
他のGPUとの比較
関連する GPU の比較


ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-geforce-rtx-5080" target="_blank">NVIDIA GeForce RTX 5080</a>