NVIDIA B300
NVIDIA B300: ブラックウェルウルトラが288GB HBM3Eを搭載した理由
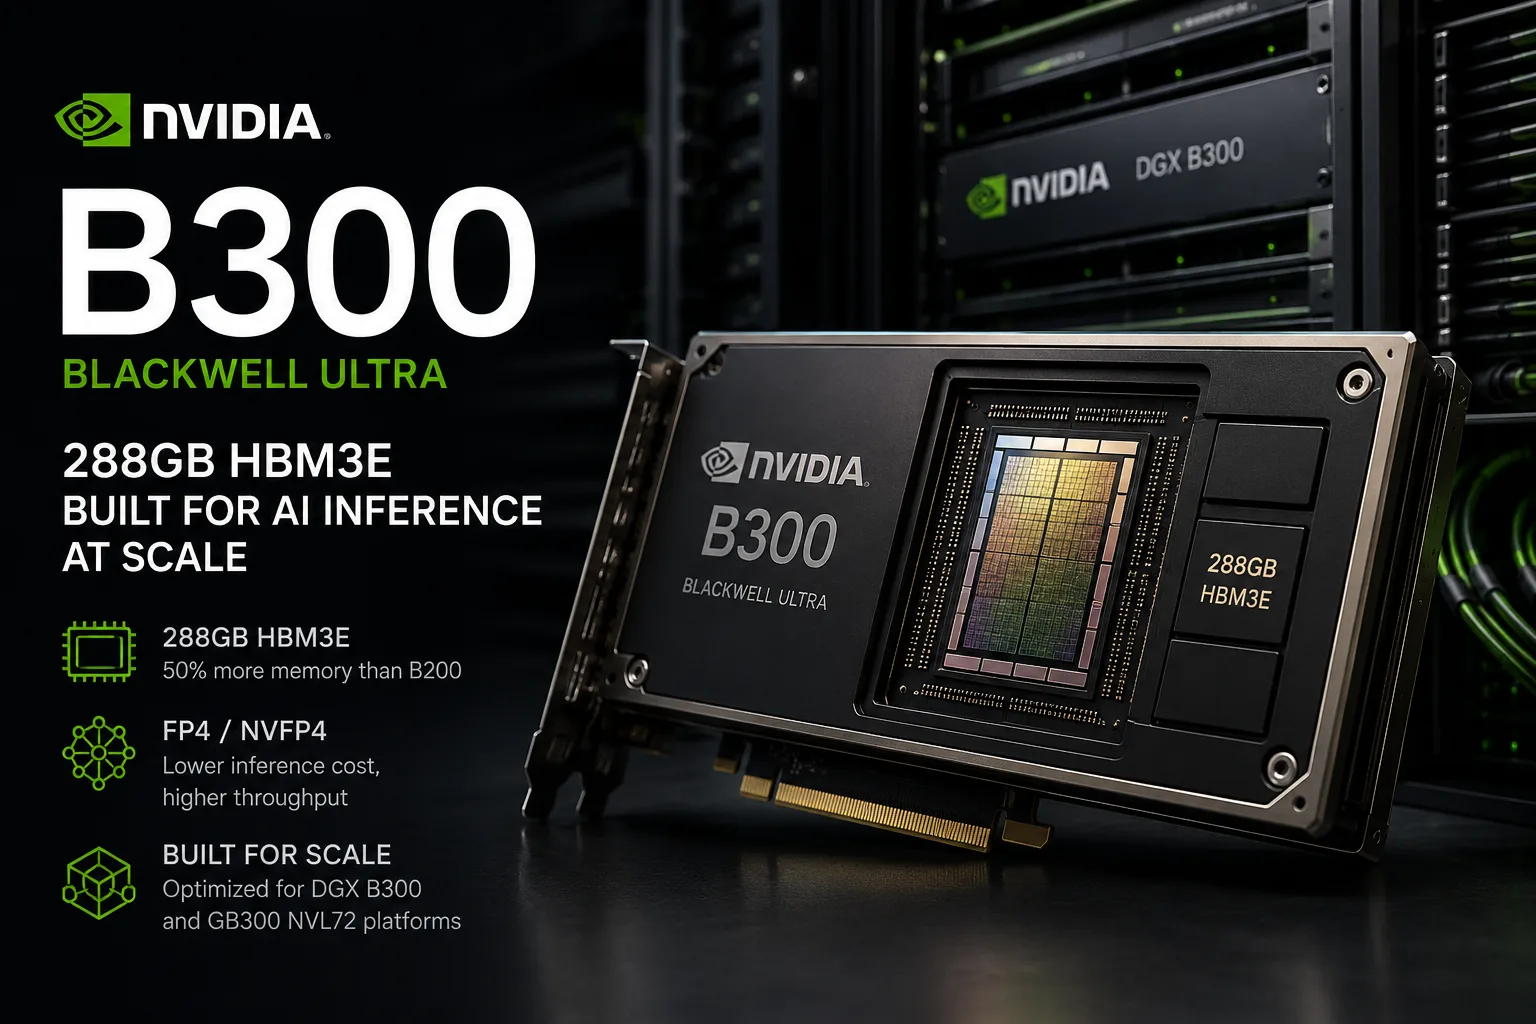
NVIDIA B300はブラックウェルウルトラ世代のデータセンター向けアクセラレーターです。B200との主な違いはメモリの増加です:192GBの代わりに288GBのHBM3E。大規模なAIモデルの場合、この増加はピークパフォーマンスよりも重要な場合があります。なぜなら、長いコンテキストや並列リクエストが迅速にメモリに達してしまうからです。
大規模言語モデルは、重みだけでなく、中間データ、KVキャッシュを保存する必要があります。リクエストが長く、論理的推論のステップが多く、並列負荷が高まるほど、HBMの消費は加速します。B300は大規模なLLM、MoEモデル、長い文書、同時リクエスト数の多いインフェレンスに特化しています。
NVIDIA B300とは
B300はブラックウェルウルトラファミリーに属し、サーバーとAIインフラストラクチャ向けの強化版ブラックウェルです。これは消費者向けのグラフィックカードでも、通常のワークステーション向けのアクセラレーターでもありません。データセンター、DGXシステム、GB300 NVL72レベルのラックプラットフォームがその用途です。
名前を混同しないことが重要です。B300はアクセラレーター本体です。DGX B300は、8つのそのようなGPUを搭載したNVIDIAのサーバーです。GB300 NVL72は、数十のブラックウェルウルトラGPUが迅速なNVLink交換で結合された完全なラックのシステムです。
B300は単独のボードとしてではなく、プラットフォームの一部として考えるべきです。NVIDIAはGPUだけでなく、NVLink、NVSwitch、ネットワークソリューション、CUDA、TensorRT-LLM、そして完成されたサーバー構成のセットを販売しています。
主なアップグレード - 288GB HBM3E
B300は1つのGPUに最大288GBのHBM3Eを搭載しています。これは大規模言語モデルのインフェレンスにおける重要な特性です。B200のメモリ容量は192GBと低く、したがってB300の増加は形式的なものではなく、実際の負荷にとって明確に視認できるものです:モデルに対して、長いコンテキストと並列リクエストにより多くのスペースを提供します。
特に重要なのはKVキャッシュです。これはモデルが生成中に保持するデータであり、前のコンテキストを再計算する必要がないようにします。対話、文書、推論のチェーンが長くなるほど、キャッシュは多くのメモリを消費します。多くのユーザーが同時にサービスを受けている場合、HBMへの負荷はさらに増大します。
B200に対する追加の96GBのメモリは、計算ユニットの増加よりも多くの利点をもたらす可能性があります。これによりより多くのデータをGPUメモリに保持でき、アクセラレーター間でモデルを分割する頻度が減り、データ交換にかかる時間が短縮されます。これによりデータセンターにおいては応答遅延、同時リクエストの数、生成コストに影響を与えます。
なぜB300が長いコンテキストや推論にとって重要なのか
AIインフェレンスはますます困難になっています。以前はモデルへの典型的なリクエストはしばしば短いものでした:質疑応答。今では、モデルは長い文書、コードベース、ツール、複数の論理的推論ステップを実行する必要があるタスクで動作します。こうしたシナリオは、中間データを増加させ、メモリに大きな負荷をかけます。
したがって、B300は単にB200のアクセラレートバージョンとして見るべきではなく、大規模インフェレンスのためのブラックウェルの次のステップとして見るべきです。H200はホッパー世代の強力なアクセラレーターでした。B200はブラックウェルへの初めての大きな移行でした。B300は、より多くのHBMと長いコンテキストへのより良い適応によってこのラインを強化します。
こうしたタスクでは、TFLOPSだけでの比較はあまり意味を持ちません。重要なのはどれだけのユーザーを1つのGPUでサービスできるか、システムがどれだけ長いコンテキストに耐えられるか、そして準備された応答のコストがどれくらいかです。
FP4とNVFP4:インフェレンスのためのパフォーマンス
B300では、従来のFP32メトリックは二次的な意味を持ちます。このアクセラレーターの主な領域は、テンサーコアおよび低精度計算:FP8、FP4、そして独自のフォーマットNVFP4です。ここでNVIDIAはインフェレンスのコストを削減しようとしています。
低精度はデータ量を減らし、計算を加速します。モデルをFP4で効果的に動作させることができれば、データセンターは同じインフラストラクチャでより多くのトークンを毎秒受け取ります。そのため、B300は汎用GPUとして評価するのではなく、こうしたフォーマットに最適化されたモデルのためのアクセラレーターとして評価するべきです。
ハードウェアはソフトウェアスタックと連携して機能します。CUDA、TensorRT-LLM、トランスフォーマーエンジン、およびLLM向けの事前最適化は、実際のパフォーマンスを引き出し、スペックの良い数字だけではない結果をもたらします。
B300がB200やH200と異なる点
B300はB200の後に新しいアーキテクチャを始めるわけではありません。これは、メモリとインフェレンスに対するより強い焦点を持つブラックウェルの進化です。B200との主な違いは、192GBの代わりに288GBのHBM3Eを備えていることです。長いコンテキスト、KVキャッシュ、そして並列リクエストのサービスにおいて、この増加は決定的なものになる可能性があります。
H200との違いはより深いです。H200はホッパー世代に属し、重いAIタスクに対応していましたが、B300はブラックウェルウルトラに移行します:低精度のためのより多くの機能、インフェレンスの密度の向上、NVIDIAの新しいサーバープラットフォーム内でのスケーリングの改善が図られています。
したがって、B300はサーバー内でのアクセラレーターの単なる交換としてではなく、モデルのトレーニングから継続的な運用への移行の一部として理解すべきです。トレーニングはコストが高く、一時的なプロセスです。インフェレンスは常時作動し、コストにより早く影響を与えます。
DGX B300とGB300 NVL72
DGX B300は、NVIDIAがこのアクセラレーターを実際にどのように考えているかを示しています。これは単なる別々のボードのセットではなく、8つのB300、大容量のGPUメモリ、高速な相互接続、およびクラスター用のネットワークインターフェースを備えた完成されたAIサーバーです。
GB300 NVL72は次のレベルです:数十のブラックウェルウルトラGPUとグレースCPUを搭載したラックです。このようなシステムでは、B300は全体の計算プラットフォームの一部として機能します。大規模なモデルにとってこれは重要です:GPUがデータを交換するのが早ければ早いほど、計算ユニットの待機時間が短くなり、高価なハードウェアがより効率的に利用されます。
大規模なAI負荷においては、スペックにおける単一の数字よりも、システム全体の安定したスケーリングが重要です。したがって、NVIDIAはGPUだけでなく、完成されたサーバーやラックをも推進しています。
競合:AMDはハードウェアで近いが、NVIDIAはプラットフォームで強い
B300の主な競合はAMD Instinct MI355Xです。こちらも重いAI負荷に対応しており、大きなHBM3E容量を提供します。特定の特性では、AMDはもはやハードウェアで大きく遅れをとっているとみなすことはできません。
しかしデータセンターでは、メモリだけではありません。大口の顧客にとっては、ソフトウェアスタック、人気モデルのサポート、GPU間のスケーリング、および完成されたサーバーソリューションの入手可能性が重要です。ここでNVIDIAは、CUDA、TensorRT-LLM、トランスフォーマーエンジン、NVLink/NVSwitch、そしてLLMインフェレンス向けの数多くの最適化により強いポジションを持っています。
AMDは、価格、オープン性、NVIDIA依存の減少が重要な場合には魅力的かもしれません。しかし、大規模モデル向けに最大限に予測可能なインフラを必要とする企業には、B300がより明白な選択に見えます。
B300の制限
B300は強力ですが、運用が複雑なアクセラレーターです。電源、冷却、ネットワーク、ラックのコストから切り離して評価することはできません。このレベルでは、インフラストラクチャが最終的な所有コストに直接影響を与えます。
小規模なラボにとって、B300は過剰である可能性があります。その利点は、大規模なモデル、常時増加するインフェレンス負荷、最適化されたスタック、および実際にFP4、HBM、GPU間の高速交換を使用するタスクがある場所で発揮されます。
また、戦略的なニュアンスもあります:B300はブラックウェルの強化版であり、NVIDIAの最新世代ではありません。企業はすでに次のアーキテクチャを準備しているため、B300は次のAIインフラ周期のためのブラックウェルウルトラのトップバージョンとして興味深いものです。
結論
NVIDIA B300は、288GB HBM3E、高いメモリ帯域幅、FP4/NVFP4、そしてNVIDIAプラットフォームを通じたスケーリングの組み合わせにより、単一の記録的な数字以上に重要です。これは、チップの価格だけでなく、応答のコスト、遅延、ラック当たりのリクエスト数が重要な問題となるタスクのためのアクセラレーターです。
B300はすべての人に必要なわけではありません。通常の計算には高価すぎて特化しています。しかし、クラウド、AI企業、大規模なデータセンターにとって、これはブラックウェルウルトラ世代の鍵となるアクセラレーターの一つです。これは、市場のシフトを示しており、もはや単なるGPUではなく、実際の負荷に応じて大規模モデルを安定的に処理する完成されたシステムが重要になってきているのです。
GPUの比較
B300を他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較

ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-b300" target="_blank">NVIDIA B300</a>