NVIDIA Tesla V100 PCIe 32 GB

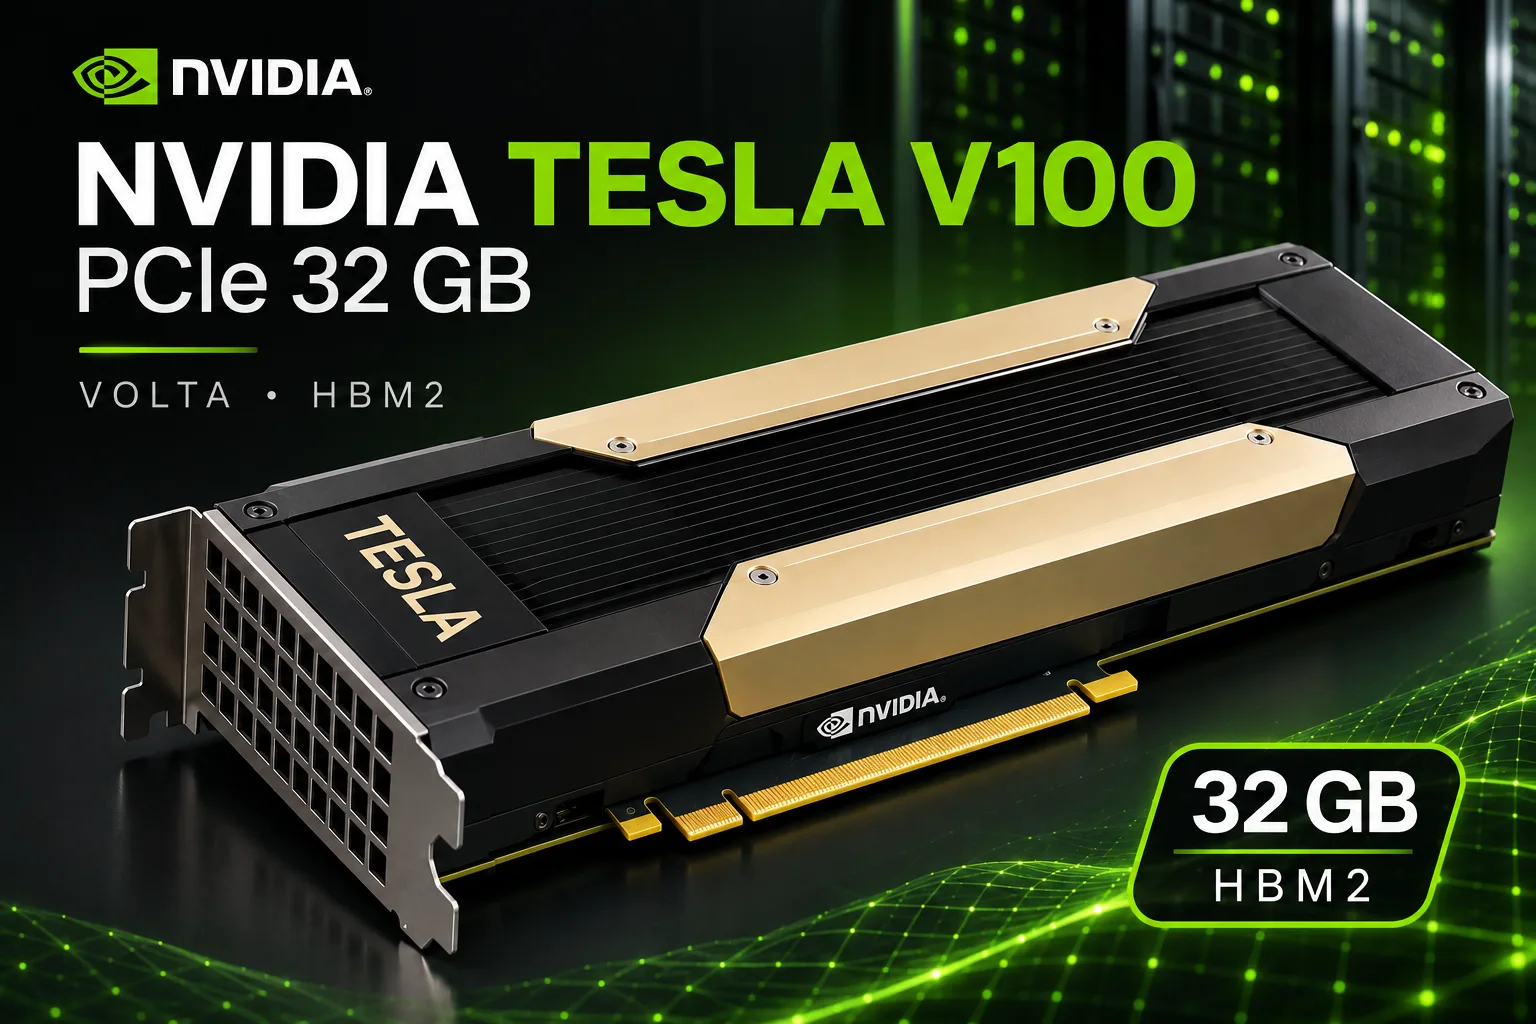
Tesla V100 PCIe 32 GB : de la mémoire pour des modèles de 27 milliards de paramètres, mais une prime pour le connecteur PCIe
La Tesla V100 PCIe 32 GB est une version de l’accélérateur serveur V100 dotée de deux fois plus de mémoire. NVIDIA l’a lancée en mars 2018 au prix d’environ $11 500. Aujourd’hui, les cartes déclassées se vendent autour de $700 sur eBay.
Son die, ses fréquences et sa bande passante de 900 Go/s sont identiques à ceux de la version de 16 Go. Mais en 2026, c’est précisément la capacité qui compte. Les 32 Go permettent de charger des modèles denses de 27 à 32 milliards de paramètres en quantification 4 bits avec un long contexte, et la V100 atteint environ 30 tokens par seconde sur ces modèles.
Elle présente deux inconvénients. Volta n’a plus de nouveaux pilotes ni de prise en charge de CUDA 13. De plus, la version PCIe coûte presque trois fois plus cher que la version de 16 Go et nettement plus cher que le module SXM2 de même capacité.
Positionnement dans la gamme
Toutes les V100 reposent sur le die GV100 : procédé de fabrication TSMC 12 nm, 5120 cœurs CUDA et 640 cœurs Tensor de première génération, ainsi que quatre piles de HBM2 sur un bus de 4096 bits. Les versions de 32 Go et leurs proches parentes sont les suivantes :
| Modèle | Mémoire | Bande passante | Boost | TDP | Particularités |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 Go HBM2 | 900 Go/s | 1380 MHz | 250 W | la même carte avec moitié moins de mémoire |
| Tesla V100 PCIe 32 GB | 32 Go HBM2 | 900 Go/s | 1380 MHz | 250 W | radiateur passif, sans NVLink ni sorties vidéo |
| Tesla V100 SXM2 32 GB | 32 Go HBM2 | 900 Go/s | 1530 MHz | 300 W | connecteur serveur SXM2, NVLink |
| Tesla V100S PCIe 32 GB | 32 Go HBM2 | 1134 Go/s | 1601 MHz | 250 W | mise à jour de 2019 |
| Quadro GV100 | 32 Go HBM2 | 870 Go/s | 1627 MHz | 250 W | sorties vidéo, pilote professionnel |
Les performances annoncées de la version PCIe sont de 14 TFLOPS en FP32, 7 TFLOPS en FP64 et 112 TFLOPS sur les cœurs Tensor. Ces derniers fonctionnent uniquement en FP16. Volta ne dispose ni de cœurs RT, ni de BF16, ni de TF32.
La même carte de référence apparaît dans les annonces sous différents numéros de pièce : PNY TCSV100M-32GB-PB, Dell 490-BENZ et 0HR5WD, HPE Q9U36A, Lenovo 4X67A12088, Cisco UCSC-GPU-V100-32=.
Performances
Modèles de langage
La vitesse de génération des tokens est limitée par la bande passante mémoire. C’est pourquoi, sur les petits modèles, la V100 de 32 Go fonctionne comme celle de 16 Go. Mesures des développeurs de llama.cpp effectuées avec une même version du code :
| Carte | Mémoire | gpt-oss 20B, prompt (pp2048), tok/s | gpt-oss 20B, génération (tg128), tok/s | Llama 8B Q4_0, génération, tok/s |
|---|---|---|---|---|
| Tesla P40 | 24 Go GDDR5 | 1362 | 65 | 52 |
| Instinct MI50/MI60 | 32 Go HBM2 | 1066 | 144 | - |
| Tesla V100 PCIe 32 GB | 32 Go HBM2 | 2436 | 151 | 128 |
| GeForce RTX 3090 | 24 Go GDDR6X | 5824 | 210 | 155 |
| GeForce RTX 4090 | 24 Go GDDR6X | 13 127 | 264 | 179 |
| GeForce RTX 5090 | 32 Go GDDR7 | 21 011 | 412 | 282 |
Sur gpt-oss 20B, la V100 génère 28 % plus lentement que la RTX 3090 et se situe au même niveau que la carte AMD. Le test ne précise pas s’il s’agissait d’une MI50 ou d’une MI60. La V100 traite le prompt 2,3 fois plus vite que la carte AMD, mais 2,4 fois plus lentement que la 3090.
Cette carte est choisie pour ses 32 Go afin d’exécuter des modèles denses de 27 milliards de paramètres. Voici des rapports de propriétaires : llama.cpp, une seule requête, sans accélérations. Les résultats obtenus avec le modèle SXM2 s’appliquent également à la version PCIe : leur mémoire est identique et la génération est précisément limitée par celle-ci. Les lignes avec Qwen3.6 27B Q4_K_M sont directement comparables.
| Configuration | Modèle et quantification | Génération, tok/s | Prompt, tok/s |
|---|---|---|---|
| V100 PCIe 32 GB | Qwen3.8 27B, UD-Q4_K_XL | 33,4 | 826 |
| V100 SXM2 32 GB | Qwen3.6 27B, Q4_K_M | 32,2 | - |
| V100 SXM2 32 GB | Qwen3.6 27B, Q8_0 | 22,8 | - |
| RTX 5090 | Qwen3.6 27B, Q4_K_M | 77 | - |
Une vitesse de 32 à 33 tokens par seconde sur un modèle 27B en 4 bits suffit pour le chat et les tâches agentiques. La RTX 5090 est 2,4 fois plus rapide, mais elle coûte aussi presque 9 fois plus cher.
Les optimisations logicielles apportent davantage que le choix entre PCIe et SXM2. Avec le MTP, c’est-à-dire la prédiction de plusieurs tokens par étape, le modèle Qwen3.8 27B passe de 33 à 57 tokens par seconde. Le gain est maximal sur le code et moindre sur la prose. Le fork de vLLM est 10 % plus lent que llama.cpp avec une seule requête. En revanche, avec quatre requêtes simultanées, il atteint un total de 110 tokens par seconde, contre 75,7.
À mesure que le contexte s’allonge, la vitesse diminue : de 33,4 tokens par seconde avec un contexte vide à 28 pour 32 000 tokens et 15,8 pour 131 000 tokens. Il faut également surveiller le refroidissement. Chez un propriétaire, la carte était tombée à 15,7 tokens par seconde jusqu’à ce qu’il règle les ventilateurs du serveur à leur vitesse maximale.
Lors d’un test, la V100 s’est montrée plus économe que la RTX 4070. Sur Qwen3.5 4B, elle a atteint 107 tokens par seconde à 154 W, contre 91 tokens à 173 W pour la 4070, soit 30 % de tokens par joule en moins. La 4070 traite toutefois le prompt plus rapidement : 5860 tokens par seconde contre 4445.
Entraînement, calculs et jeux
Les 32 Go permettent de fine-tuner en FP16 des modèles plus volumineux, mais en l’absence de BF16 et de FlashAttention 2, les pipelines d’entraînement modernes doivent être remaniés. Selon les mesures de Lambda effectuées sur des versions SXM2, l’A100 est 1,6 à 3,4 fois plus rapide pour l’entraînement.
En FP64, la V100 reste performante. Ses 7 TFLOPS représentent environ cinq fois ceux de la RTX 4090, et ses 32 Go peuvent accueillir de grands maillages pour la CFD ainsi que des modèles de dynamique moléculaire.
Cette carte ne convient pas aux jeux. Elle ne possède ni sorties vidéo, ni DLSS, ni ray tracing, et ses performances sont légèrement inférieures à celles de la RTX 4060 Ti.
Prise en charge logicielle
La branche de pilotes R580 est la dernière à prendre en charge Volta. CUDA 13 ne se compile pas pour cette architecture, ce qui limite les utilisateurs à CUDA 12.x. Les compilations prêtes à l’emploi de llama.cpp et de LM Studio abandonnent progressivement la prise en charge de la V100. Chez un propriétaire, la quantification du cache KV est passée silencieusement sur le processeur, précisément en raison de l’absence de Volta dans CUDA 13.
La plate-forme est maintenue par des passionnés : forks de vLLM pour sm_70, portage d’ExLlamaV3 et compilations de llama.cpp avec MTP. Cela suffit pour des expérimentations à domicile. Dans un système de production, vous dépendrez de la durée pendant laquelle leurs auteurs continueront à les maintenir.
Prix et lieux d’achat
Les V100 neuves ne sont plus fabriquées depuis longtemps ; la carte se vend désormais uniquement d’occasion.
| Offre | Configuration | Prix |
|---|---|---|
| eBay États-Unis, bas de la fourchette (octobre 2026) | V100 PCIe 32 GB | ~$685-695 |
| eBay États-Unis, moyenne des annonces actives | V100 PCIe 32 GB | ~$920 |
| Amazon / Newegg (octobre 2026) | V100 PCIe 32 GB | $799 / $839 |
| Certains vendeurs étrangers | V100 PCIe 32 GB | $400-500 |
| Module SXM2 + adaptateur | V100 SXM2 32 GB | ~$250-600 |
| IT Creations | V100S PCIe 32 GB | $8937 |
| TechMikeNY, Dell PowerEdge R740 | serveur avec une seule V100 PCIe 32 GB | $12 156 |
Le prix plancher sur eBay n’a presque pas bougé depuis le début de l’année : environ $707 en février, contre environ $685 aujourd’hui. Une carte à moins de $500 ne se trouve que chez certains vendeurs étrangers. Ces lots, comme les moins chers sur eBay, sont généralement dépourvus de garantie. Il faut ajouter un ventilateur avec carénage : sans flux d’air de serveur, le radiateur passif surchauffe.
Les revendeurs et assembleurs de serveurs demandent un ordre de grandeur de plus. Dans une configuration serveur, vous payez principalement les processeurs, la mémoire et les disques.
Concurrents et alternatives
Tesla V100 SXM2 32 GB avec adaptateur. Même die et même capacité, fréquence supérieure de 10 %, pour un total de $250-600 avec l’adaptateur. Les inconvénients sont l’assemblage à réaliser soi-même, le ventilateur d’origine bruyant et une consommation de 300 W en charge. Pour un PC domestique, c’est le moyen le moins cher d’accéder à 32 Go de HBM2.
Deux V100 PCIe 16 GB. Environ $470 pour obtenir les mêmes 32 Go. llama.cpp répartira le modèle entre les couches, et la génération restera au niveau d’une seule carte. Il faudra deux emplacements x16 ainsi qu’une alimentation disposant d’une marge de 500 W.
GeForce RTX 3090. Sa génération est 20 à 40 % plus rapide et elle traite le prompt 2,4 fois plus vite. Elle prend également en charge BF16 et FlashAttention, avec des pilotes encore suivis. Un modèle 27B en 4 bits tient dans ses 24 Go, mais avec moins de marge pour le contexte ; les modèles 32B en Q5-Q6 n’y tiennent déjà plus. Elle coûte environ $1386, soit deux fois plus que la V100.
GeForce RTX 5090. Elle dispose des mêmes 32 Go, mais offre une vitesse nettement supérieure. En raison de la pénurie de mémoire, son prix commence à $6000, contre un prix recommandé de $1999. Cela représente environ $190 par gigaoctet, contre $22 pour la V100.
AMD Instinct MI50 32 GB. Sa vitesse de génération est comparable à celle de la V100, mais le traitement du prompt est plus de deux fois plus lent. Elle coûte $120-210 chez les fournisseurs d’Alibaba et $500-650 sur eBay. En pratique, llama.cpp et le PyTorch de base sont les principaux logiciels à fonctionner de manière stable sur cette carte.
Conclusion
Selon les standards actuels, la V100 PCIe 32 GB est un processeur de calcul lent doté d’une mémoire vaste et rapide. Elle suffit pour conserver en mémoire un modèle de 27 à 32 milliards de paramètres avec un long contexte et l’utiliser à un rythme confortable. Les limites apparaissent avec les prompts longs, l’entraînement et les logiciels. Cette carte ne convient pas aux systèmes de production.
Le prix raisonnable de la version PCIe est de $450-500 maximum. À son prix actuel de $700, elle est moins intéressante qu’un module SXM2 de 32 Go avec adaptateur. Le supplément demandé pour la version PCIe ne se justifie que si la carte est installée dans un serveur en rack comme le Dell R740 ou le HPE DL380 : on ne peut pas y installer d’adaptateur, tandis que le flux d’air prévu par le serveur règle le problème du refroidissement.
Si 24 Go suffisent et que vous avez besoin de vitesse avec une prise en charge logicielle correcte, mieux vaut payer davantage pour une RTX 3090. Si vous recherchez un maximum de mémoire pour un minimum d’argent, la V100 SXM2 32 GB ou la MI50 sont plus intéressantes.
Comparaison de GPU
Comparer Tesla V100 PCIe 32 GB avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Comparaisons de GPU associées


Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/index.php/fr/gpu/nvidia-tesla-v100-pcie-32-gb" target="_blank">NVIDIA Tesla V100 PCIe 32 GB</a>