NVIDIA GeForce RTX 5080
GeForce RTX 5080 : 13 % plus rapide que la RTX 5070 Ti en 4K, mais 76 % plus chère
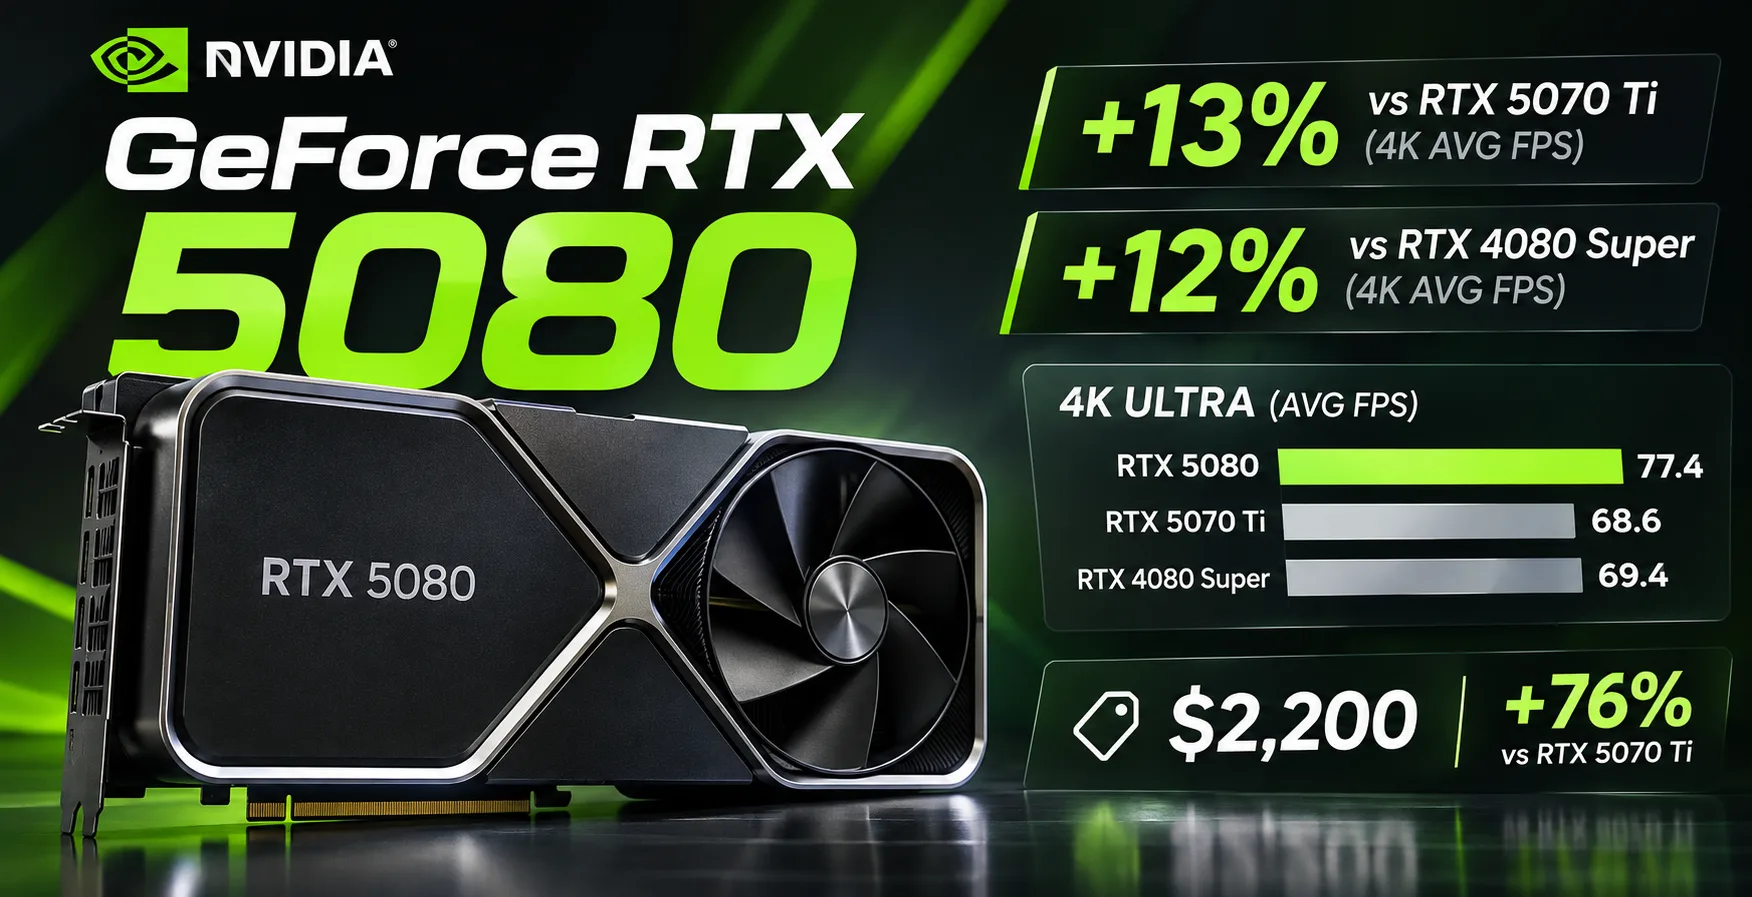
La GeForce RTX 5080 est sortie en janvier 2025 au prix de $999, mais en octobre 2026, le prix minimal des offres disponibles aux États-Unis a atteint $2200. Dans le même temps, la RTX 5070 Ti, vendue $1250, ne lui cède en moyenne que 13 % en fréquence d’images en 4K. L’écart de prix atteint $950, alors que les deux cartes disposent de 16 Go de mémoire vidéo et prennent en charge le DLSS Multi Frame Generation.
La mise à niveau par rapport à la RTX 4080 Super s’est également révélée limitée. D’après les tests de Tom's Hardware, la RTX 5080 est environ 12 % plus rapide que son prédécesseur en 4K sans ray tracing. Son avantage le plus marqué sur la RTX 5070 Ti apparaît dans les jeux faisant un usage intensif du ray tracing, mais même dans ce cas, le gain ne justifie pas la différence de prix.
Blackwell et GDDR7 : ce qui a changé
La RTX 5080 repose sur le processeur graphique GB203, doté de 10 752 cœurs CUDA. Elle utilise de la mémoire GDDR7 offrant une bande passante de 960 Go/s, contre de la GDDR6X pour la RTX 4080 Super. La bande passante a augmenté de 30 %, mais la quantité de mémoire reste inchangée.
| Caractéristique | RTX 5080 | RTX 4080 Super | RTX 5070 Ti |
|---|---|---|---|
| Architecture | Blackwell | Ada Lovelace | Blackwell |
| Cœurs CUDA | 10 752 | 10 240 | 8 960 |
| Mémoire | 16 Go GDDR7 | 16 Go GDDR6X | 16 Go GDDR7 |
| Bande passante | 960 Go/s | 736 Go/s | 896 Go/s |
| Fréquence Boost | 2617 MHz | 2550 MHz | 2452 MHz |
| TGP | 360 W | 320 W | 300 W |
La RTX 5080 intègre des cœurs RT de quatrième génération, des cœurs Tensor de cinquième génération, le PCIe 5.0 et le DisplayPort 2.1b.
Le TGP nominal est passé de 320 à 360 W, même si la consommation réelle dépend de la charge. NVIDIA recommande une alimentation de 850 W. La connexion s’effectue au moyen d’un câble d’alimentation à 16 broches ou de l’adaptateur fourni vers trois connecteurs à 8 broches.
3DMark Time Spy
| Carte graphique | Score graphique |
|---|---|
| GeForce RTX 4090 | 36 676 |
| GeForce RTX 5080 | 31 987 |
| Radeon RX 9070 XT | 29 464 |
| GeForce RTX 4080 Super | 27 920 |
| GeForce RTX 5070 Ti | 27 727 |
Résultats de ComputerBase.
La RTX 5080 devance la RTX 4080 Super et la RTX 5070 Ti d’environ 15 %, mais reste derrière la RTX 4090 de la génération précédente.
Tests en jeu : 1440p et 4K sans mise à l’échelle
Les résultats récapitulatifs de Tom's Hardware pour juin 2026 permettent de comparer les cartes graphiques sans DLSS, FSR ni génération d’images.
| Carte graphique | 1440p Ultra | 4K Ultra | 4K avec RT |
|---|---|---|---|
| RTX 4090 | 143,4 | 89,1 | 52,2 |
| RTX 5080 | 128,3 | 77,4 | 42,1 |
| RTX 4080 Super | 118,6 | 69,4 | 38,5 |
| RTX 5070 Ti | 116,8 | 68,6 | 36,7 |
| Radeon RX 9070 XT | 116,5 | 65,8 | 30,1 |
FPS moyens. La rastérisation et le ray tracing ont été mesurés dans des ensembles de jeux distincts.
En 1440p, la RTX 5080 est 10 % plus rapide que la RTX 5070 Ti ; en 4K, son avantage atteint 13 %. La RTX 4080 Super cède environ 12 % à la nouvelle carte en 4K, tandis que la RTX 4090 conserve la tête.
Avec le ray tracing, l’avantage de la RTX 5080 sur la RTX 5070 Ti atteint 15 %, et 40 % sur la Radeon RX 9070 XT. Toutefois, une moyenne de 42 FPS en 4K avec RT signifie qu’il faudra recourir à la mise à l’échelle ou réduire les réglages pour obtenir une fréquence d’images plus élevée.
Death Stranding 2 : comparaison avec DLSS et FSR
Les tests de ComputerBase réalisés en mars 2026 utilisaient des réglages graphiques très élevés, le DLSS 4 en mode Quality pour les cartes NVIDIA et le FSR 4.1 en mode Quality pour la Radeon RX 9000. La génération d’images était désactivée.
| Carte graphique | 1440p | 4K | 4K avec RT |
|---|---|---|---|
| RTX 4090 | 124,8 | 105,5 | 65,5 |
| RTX 5080 | 125,8 | 96,4 | 57,0 |
| RTX 4080 Super | 104,1 | 82,3 | 49,2 |
| RTX 5070 Ti | 110,4 | 84,6 | 49,2 |
| Radeon RX 9070 XT | 106,9 | 79,0 | 41,2 |
FPS moyens. Le mode RT utilise le ray tracing au niveau maximal. La qualité d’image avec le DLSS et le FSR peut différer.
La RTX 5080 est 14 % plus rapide que la RTX 5070 Ti en 4K et 16 % plus rapide avec le ray tracing. La RTX 4090 conserve la tête en 4K, même si elle cède légèrement face à la nouvelle carte en 1440p.
Prix : combien coûte la performance supplémentaire
Selon une étude de TechSpot publiée le 2 novembre 2026, les prix minimaux des cartes graphiques disponibles dans les magasins américains en octobre s’élevaient à $2200 pour la RTX 5080, $1250 pour la RTX 5070 Ti et $870 pour la Radeon RX 9070 XT.
| Carte graphique | Prix aux États-Unis | FPS en 4K | Prix par FPS |
|---|---|---|---|
| RTX 5080 | $2200 | 77,4 | $28,42 |
| RTX 5070 Ti | $1250 | 68,6 | $18,22 |
| Radeon RX 9070 XT | $870 | 65,8 | $13,22 |
Le prix par FPS est calculé à partir des résultats moyens en 4K Ultra sans ray tracing. Cet indicateur sert uniquement à comparer le coût de la performance.
Pour chaque FPS, la RTX 5080 coûte 56 % plus cher que la RTX 5070 Ti. La Radeon RX 9070 XT offre environ 85 % des performances de la RTX 5080 pour un prix 2,5 fois inférieur.
La RTX 5070 Ti a elle aussi fortement augmenté par rapport à son prix recommandé de $749, mais elle reste un achat plus intéressant face à la RTX 5080.
DLSS et ray tracing
La RTX 5080 prend en charge le DLSS Multi Frame Generation, qui crée des images supplémentaires entre celles calculées par le moteur du jeu. Cette technologie améliore la fluidité visuelle, mais n’apporte pas une amélioration proportionnelle de la réactivité des commandes.
La RTX 5070 Ti prend en charge la même technologie. L’avantage de la RTX 5080 réside dans sa fréquence d’images initiale plus élevée, en particulier dans les jeux utilisant le path tracing. Pour les propriétaires de moniteurs 4K à fréquence de rafraîchissement élevée, cette différence peut être importante, même si, dans les jeux exigeants, la RTX 5080 ne permet pas toujours de se passer de mise à l’échelle.
Blender, montage vidéo et intelligence artificielle
La RTX 5080 prend en charge CUDA, OptiX et l’encodage matériel AV1. Ses deux encodeurs NVENC de neuvième génération accélèrent le traitement des formats vidéo compatibles, notamment le HEVC 10 bits 4:2:2.
Dans les tests de Puget Systems, les résultats du Blender Benchmark sont les suivants :
| Carte graphique | Blender Benchmark |
|---|---|
| RTX 5090 | 15 872 |
| RTX 5080 | 9 035 |
| RTX 5070 Ti | 7 882 |
| Radeon RX 9070 XT | 3 722 |
La RTX 5080 est 15 % plus rapide que la RTX 5070 Ti. La Radeon RX 9070 XT est nettement moins performante pour le rendu via HIP ; les accélérateurs NVIDIA sont donc à privilégier pour une utilisation régulière de Blender.
Pour les modèles d’intelligence artificielle exécutés en local, la RTX 5080 est limitée par ses 16 Go de mémoire vidéo. Par exemple, un modèle de langage de 32 milliards de paramètres avec une quantification sur 4 bits ne tient généralement pas entièrement dans ce volume, une fois les données auxiliaires et le cache KV pris en compte. Les besoins exacts dépendent du format de quantification et de la taille du contexte.
Si le modèle tient dans la VRAM, la RTX 5080 offre une vitesse de calcul élevée. Pour les modèles plus volumineux, une capacité accrue de mémoire vidéo est souvent plus utile qu’un GPU plus puissant.
Faut-il acheter une GeForce RTX 5080 en 2026 ?
À $2200, il est difficile de recommander la RTX 5080 pour les jeux courants. La RTX 5070 Ti coûte $950 de moins, dispose des mêmes 16 Go de mémoire et ne cède en moyenne que 13 % en FPS en 4K. La Radeon RX 9070 XT est encore plus intéressante si une grande performance en ray tracing n’est pas nécessaire.
La RTX 5080 peut se justifier pour jouer en 4K avec des effets graphiques lourds, pour Blender et pour les tâches CUDA qui se contentent de 16 Go de mémoire vidéo. Les propriétaires d’une RTX 4080 Super ne devraient pas changer de carte : un gain d’environ 12 % en 4K est trop faible pour justifier un remplacement aussi coûteux.
Comparaison de GPU
Comparer GeForce RTX 5080 avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
3x DisplayPort 2.1b
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Comparaisons de GPU associées


Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/index.php/fr/gpu/nvidia-geforce-rtx-5080" target="_blank">NVIDIA GeForce RTX 5080</a>