NVIDIA Tesla V100 PCIe 32 GB

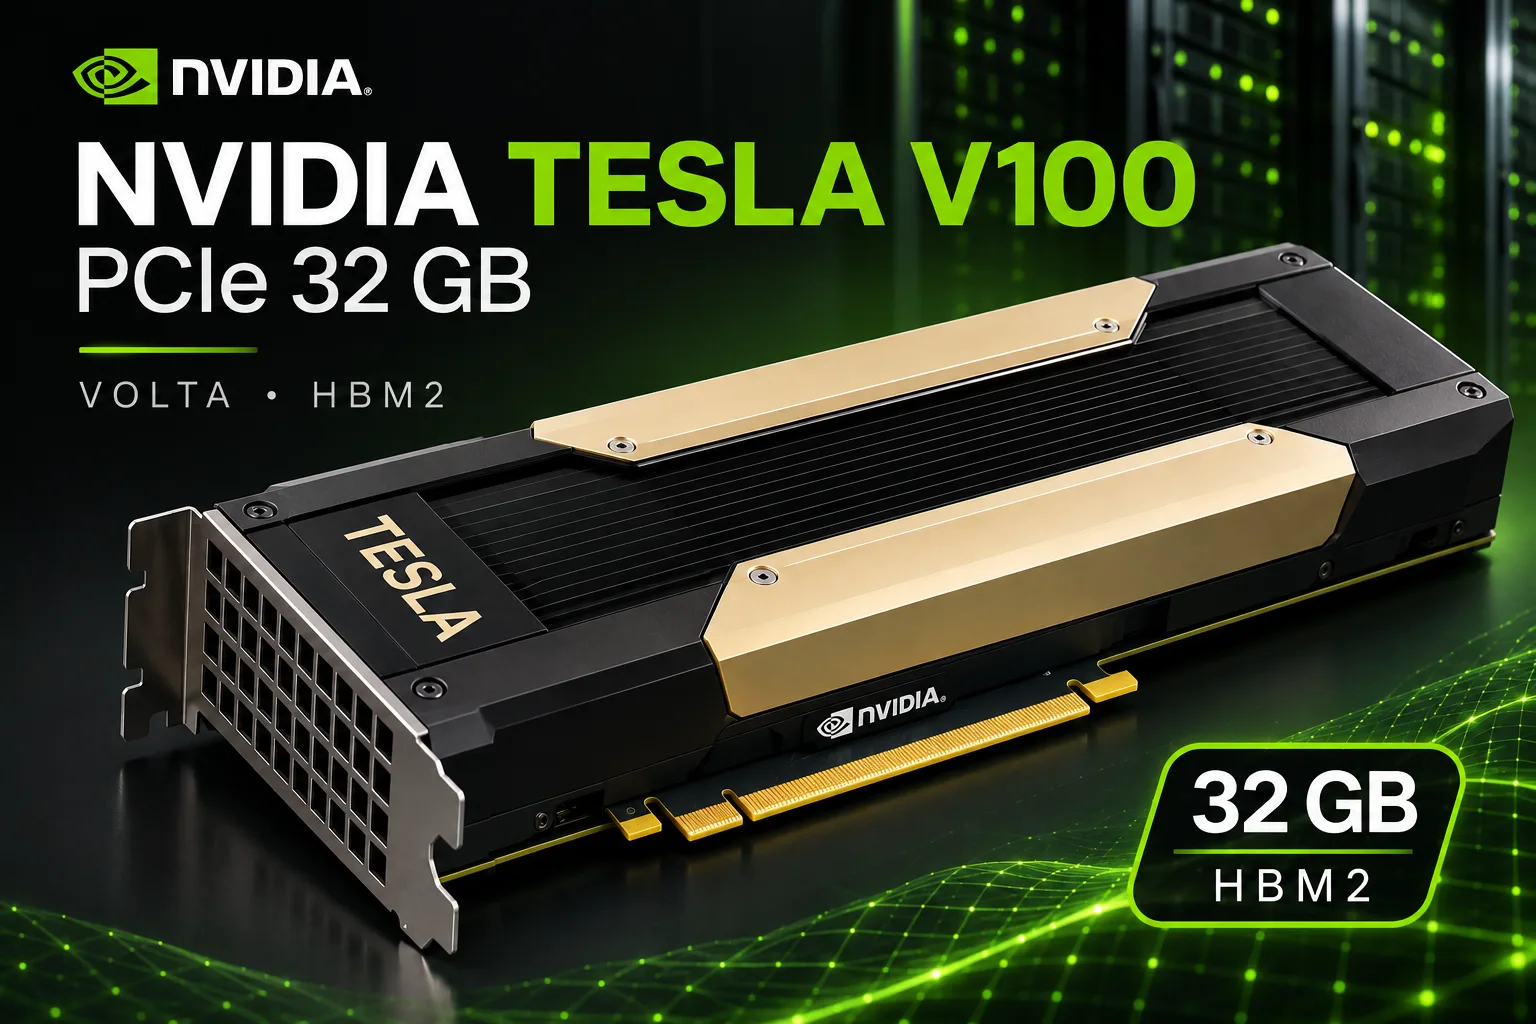
Tesla V100 PCIe 32 GB: Speicher für Modelle mit 27 Milliarden Parametern, aber mit Aufpreis für PCIe
Die Tesla V100 PCIe 32 GB ist eine Version des Serverbeschleunigers V100 mit verdoppelter Speicherkapazität. NVIDIA brachte sie im März 2018 für rund 11.500 $ auf den Markt. Heute werden ausgemusterte Karten auf eBay für etwa 700 $ verkauft.
Chip, Taktraten und die Speicherbandbreite von 900 GB/s entsprechen der 16-GB-Version. 2026 ist jedoch vor allem die Kapazität entscheidend. In 32 GB passen dichte Modelle mit 27-32 Milliarden Parametern in 4-Bit-Quantisierung und langem Kontext, wobei die V100 dabei etwa 30 Tokens pro Sekunde erreicht.
Es gibt zwei Nachteile. Volta erhält keine neuen Treiber mehr und unterstützt CUDA 13 nicht. Außerdem kostet die PCIe-Version fast dreimal so viel wie die 16-GB-Variante und deutlich mehr als ein SXM2-Modul mit gleicher Kapazität.
Einordnung innerhalb der Produktfamilie
Alle V100 basieren auf dem GV100-Chip: TSMC-12-nm-Fertigung, 5120 CUDA-Kerne und 640 Tensor-Kerne der ersten Generation sowie vier HBM2-Stacks an einem 4096-Bit-Bus. Die 32-GB-Versionen und ihre engsten Verwandten:
| Modell | Speicher | Speicherbandbreite | Boost | TDP | Besonderheiten |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | dieselbe Karte mit halb so viel Speicher |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | passiver Kühler, kein NVLink und keine Videoausgänge |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | Serveranschluss SXM2, NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | Überarbeitung aus dem Jahr 2019 |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | Videoausgänge, professioneller Treiber |
Die angegebene Leistung der PCIe-Version beträgt 14 TFLOPS in FP32, 7 TFLOPS in FP64 und 112 TFLOPS auf den Tensor-Kernen. Die Tensor-Kerne arbeiten ausschließlich mit FP16. Volta verfügt weder über RT-Kerne noch über BF16 oder TF32.
In den Angeboten findet sich dieselbe Referenzplatine unter verschiedenen Teilenummern: PNY TCSV100M-32GB-PB, Dell 490-BENZ und 0HR5WD, HPE Q9U36A, Lenovo 4X67A12088 sowie Cisco UCSC-GPU-V100-32=.
Leistung
Sprachmodelle
Die Geschwindigkeit bei der Token-Generierung wird durch die Speicherbandbreite begrenzt. Deshalb arbeitet die 32-GB-V100 bei kleineren Modellen genauso schnell wie die 16-GB-Version. Messungen der Entwickler von llama.cpp mit derselben Codeversion:
| Karte | Speicher | gpt-oss 20B, Prompt (pp2048), Tokens/s | gpt-oss 20B, Generierung (tg128), Tokens/s | Llama 8B Q4_0, Generierung, Tokens/s |
|---|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1362 | 65 | 52 |
| Instinct MI50/MI60 | 32 GB HBM2 | 1066 | 144 | - |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 2436 | 151 | 128 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5824 | 210 | 155 |
| GeForce RTX 4090 | 24 GB GDDR6X | 13 127 | 264 | 179 |
| GeForce RTX 5090 | 32 GB GDDR7 | 21 011 | 412 | 282 |
Bei gpt-oss 20B generiert die V100 28 % langsamer als die RTX 3090 und liegt gleichauf mit der AMD-Karte. Im Test wird nicht angegeben, ob eine MI50 oder eine MI60 zum Einsatz kam. Den Prompt verarbeitet die V100 2,3-mal schneller als die AMD-Karte, aber 2,4-mal langsamer als die 3090.
Wegen der 32 GB wird diese Karte für dichte Modelle mit 27 Milliarden Parametern gekauft. Nachfolgend Berichte von Besitzern: llama.cpp, eine Anfrage, keine Beschleunigungen. Die Zeilen mit SXM2 gelten auch für die PCIe-Version: Der Speicher ist identisch, und die Generierung wird genau durch ihn begrenzt. Direkt vergleichbar sind die Zeilen mit Qwen3.6 27B Q4_K_M.
| Konfiguration | Modell und Quantisierung | Generierung, Tokens/s | Prompt, Tokens/s |
|---|---|---|---|
| V100 PCIe 32 GB | Qwen3.8 27B, UD-Q4_K_XL | 33,4 | 826 |
| V100 SXM2 32 GB | Qwen3.6 27B, Q4_K_M | 32,2 | - |
| V100 SXM2 32 GB | Qwen3.6 27B, Q8_0 | 22,8 | - |
| RTX 5090 | Qwen3.6 27B, Q4_K_M | 77 | - |
32-33 Tokens pro Sekunde bei 27B in 4 Bit reichen für Chats und agentische Aufgaben aus. Die RTX 5090 ist 2,4-mal schneller, kostet aber auch fast neunmal so viel.
Softwaretechniken bringen mehr als die Wahl zwischen PCIe und SXM2. Mit MTP (der Vorhersage mehrerer Tokens pro Schritt) steigt Qwen3.8 27B von 33 auf 57 Tokens pro Sekunde. Der Zuwachs fällt bei Code am größten und bei Prosa am geringsten aus. Ein vLLM-Fork ist in einem Thread 10 % langsamer als llama.cpp. Dafür erreicht er bei vier gleichzeitigen Anfragen insgesamt 110 Tokens pro Sekunde gegenüber 75,7.
Mit wachsendem Kontext sinkt die Geschwindigkeit: von 33,4 Tokens pro Sekunde bei leerem Kontext auf 28 bei 32.000 Tokens und 15,8 bei 131.000 Tokens. Auch die Kühlung sollte man im Blick behalten. Bei einem Besitzer fiel die Leistung auf 15,7 Tokens pro Sekunde, bis er die Serverlüfter auf maximale Drehzahl stellte.
In einem der Tests erwies sich die V100 als effizienter als die RTX 4070. Bei Qwen3.5 4B erreichte sie 107 Tokens pro Sekunde bei 154 W, während die 4070 91 Tokens bei 173 W schaffte - also 30 % weniger Tokens pro Joule. Den Prompt verarbeitet die 4070 schneller: 5860 Tokens pro Sekunde gegenüber 4445.
Training, Berechnungen und Spiele
32 GB ermöglichen das Fine-Tuning größerer Modelle in FP16. Ohne BF16 und FlashAttention 2 müssen moderne Trainingspipelines jedoch angepasst werden. Messungen von Lambda mit SXM2-Versionen zufolge trainiert die A100 1,6- bis 3,4-mal schneller.
In FP64 ist die V100 weiterhin stark. 7 TFLOPS sind etwa fünfmal mehr als bei der RTX 4090, und in 32 GB passen große Gitter für CFD und Molekulardynamik.
Zum Spielen eignet sich die Karte nicht. Es gibt keine Videoausgänge, kein DLSS und keine Raytracing-Unterstützung; leistungsmäßig liegt sie knapp unter der RTX 4060 Ti.
Softwareunterstützung
Der Treiberzweig R580 ist der letzte mit Volta-Unterstützung. CUDA 13 kompiliert nicht für diese Architektur, sodass nur CUDA 12.x bleibt. Fertige Builds von llama.cpp und LM Studio verlieren allmählich die Unterstützung für V100. Bei einem Besitzer verlagerte sich die Quantisierung des KV-Caches wegen der fehlenden Volta-Unterstützung in CUDA 13 stillschweigend auf den Prozessor.
Die Plattform wird von Enthusiasten am Leben gehalten: durch vLLM-Forks für sm_70, den ExLlamaV3-Port und llama.cpp-Builds mit MTP. Für Experimente zu Hause reicht das aus. In einem produktiven System hängt man jedoch davon ab, wie lange die Entwickler diese Projekte noch unterstützen.
Preise und Bezugsquellen
Neue V100 werden schon lange nicht mehr hergestellt; heute wird die Karte ausschließlich gebraucht verkauft.
| Angebot | Konfiguration | Preis |
|---|---|---|
| eBay USA, untere Grenze (Oktober 2026) | V100 PCIe 32 GB | ~$685-695 |
| eBay USA, Durchschnitt der aktiven Angebote | V100 PCIe 32 GB | ~$920 |
| Amazon / Newegg (Oktober 2026) | V100 PCIe 32 GB | $799 / $839 |
| Einzelne ausländische Verkäufer | V100 PCIe 32 GB | $400-500 |
| SXM2-Modul + Adapter | V100 SXM2 32 GB | ~$250-600 |
| IT Creations | V100S PCIe 32 GB | $8937 |
| TechMikeNY, Dell PowerEdge R740 | Server mit einer V100 PCIe 32 GB | $12 156 |
Die Untergrenze auf eBay bewegt sich seit Jahresbeginn kaum: im Februar etwa 707 $, aktuell etwa 685 $. Unter 500 $ findet man die Karte nur bei einzelnen ausländischen Verkäufern. Für solche Angebote gibt es in der Regel ebenso wenig Garantie wie für die günstigsten eBay-Angebote. Zum Preis sollte man noch einen Lüfter mit Luftleitkanal hinzurechnen: Ohne Server-Luftstrom überhitzt der passive Kühler.
Wiederverkäufer und Serveranbieter verlangen eine Größenordnung mehr. Bei einer Serverkonfiguration bezahlt man hauptsächlich für Prozessoren, Arbeitsspeicher und Laufwerke.
Konkurrenten und Alternativen
Tesla V100 SXM2 32 GB mit Adapter. Derselbe Chip und dieselbe Speicherkapazität, 10 % höherer Takt, zusammen mit Adapter für 250-600 $. Nachteile sind der notwendige Eigenbau, der laute Standardlüfter und 300 W unter Last. Für einen Heim-PC ist dies der günstigste Weg zu 32 GB HBM2.
Zwei V100 PCIe 16 GB. Etwa 470 $ für dieselben 32 GB. llama.cpp teilt das Modell auf die Layer auf, sodass die Generierung auf dem Niveau einer einzelnen Karte bleibt. Benötigt werden zwei x16-Steckplätze und ein Netzteil mit Reserven für 500 W.
GeForce RTX 3090. Bei der Generierung 20-40 % schneller, bei der Prompt-Verarbeitung 2,4-mal schneller, außerdem mit BF16, FlashAttention und unterstützten Treibern. Ein 27B-Modell in 4 Bit passt in ihre 24 GB, allerdings mit weniger Spielraum für den Kontext; 32B in Q5-Q6 passt nicht mehr hinein. Sie kostet etwa 1386 $ und damit doppelt so viel wie die V100.
GeForce RTX 5090. Ebenfalls 32 GB, aber deutlich höhere Geschwindigkeit. Wegen der Speicherknappheit kostet sie ab 6000 $ statt der empfohlenen 1999 $. Das entspricht etwa 190 $ pro Gigabyte gegenüber 22 $ bei der V100.
AMD Instinct MI50 32 GB. Die Generierung liegt auf dem Niveau der V100, die Prompt-Verarbeitung ist mehr als doppelt so langsam. Bei Anbietern auf Alibaba kostet sie 120-210 $, auf eBay 500-650 $. Stabil laufen darauf vor allem llama.cpp und das grundlegende PyTorch.
Fazit
Nach heutigen Maßstäben ist die V100 PCIe 32 GB ein langsamer Rechenbeschleuniger mit großem und schnellem Speicher. Sie reicht aus, um ein Modell mit 27-32 Milliarden Parametern und langem Kontext vorzuhalten und in komfortablem Tempo damit zu arbeiten. Einschränkungen zeigen sich bei langen Prompts, beim Training und bei der Software. Für produktive Systeme ist die Karte nicht geeignet.
Ein angemessener Preis für die PCIe-Version liegt bei höchstens 450-500 $. Für die aktuellen 700 $ unterliegt sie einem 32-GB-SXM2-Modul mit Adapter. Der Aufpreis für PCIe ist nur gerechtfertigt, wenn die Karte in einen Rack-Server wie den Dell R740 oder HPE DL380 eingebaut wird: Dort lässt sich kein Adapter verwenden, während die standardmäßige Luftführung das Kühlungsproblem löst.
Wenn 24 GB ausreichen und hohe Geschwindigkeit mit ordentlicher Softwareunterstützung gefragt ist, sollte man lieber den Aufpreis für eine RTX 3090 bezahlen. Wer möglichst viel Speicher für möglichst wenig Geld braucht, fährt mit einer V100 SXM2 32 GB oder einer MI50 besser.
GPU-Vergleich
Tesla V100 PCIe 32 GB mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
Verwandte GPU-Vergleiche


In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/index.php/de/gpu/nvidia-tesla-v100-pcie-32-gb" target="_blank">NVIDIA Tesla V100 PCIe 32 GB</a>