NVIDIA Tesla P100 SXM2

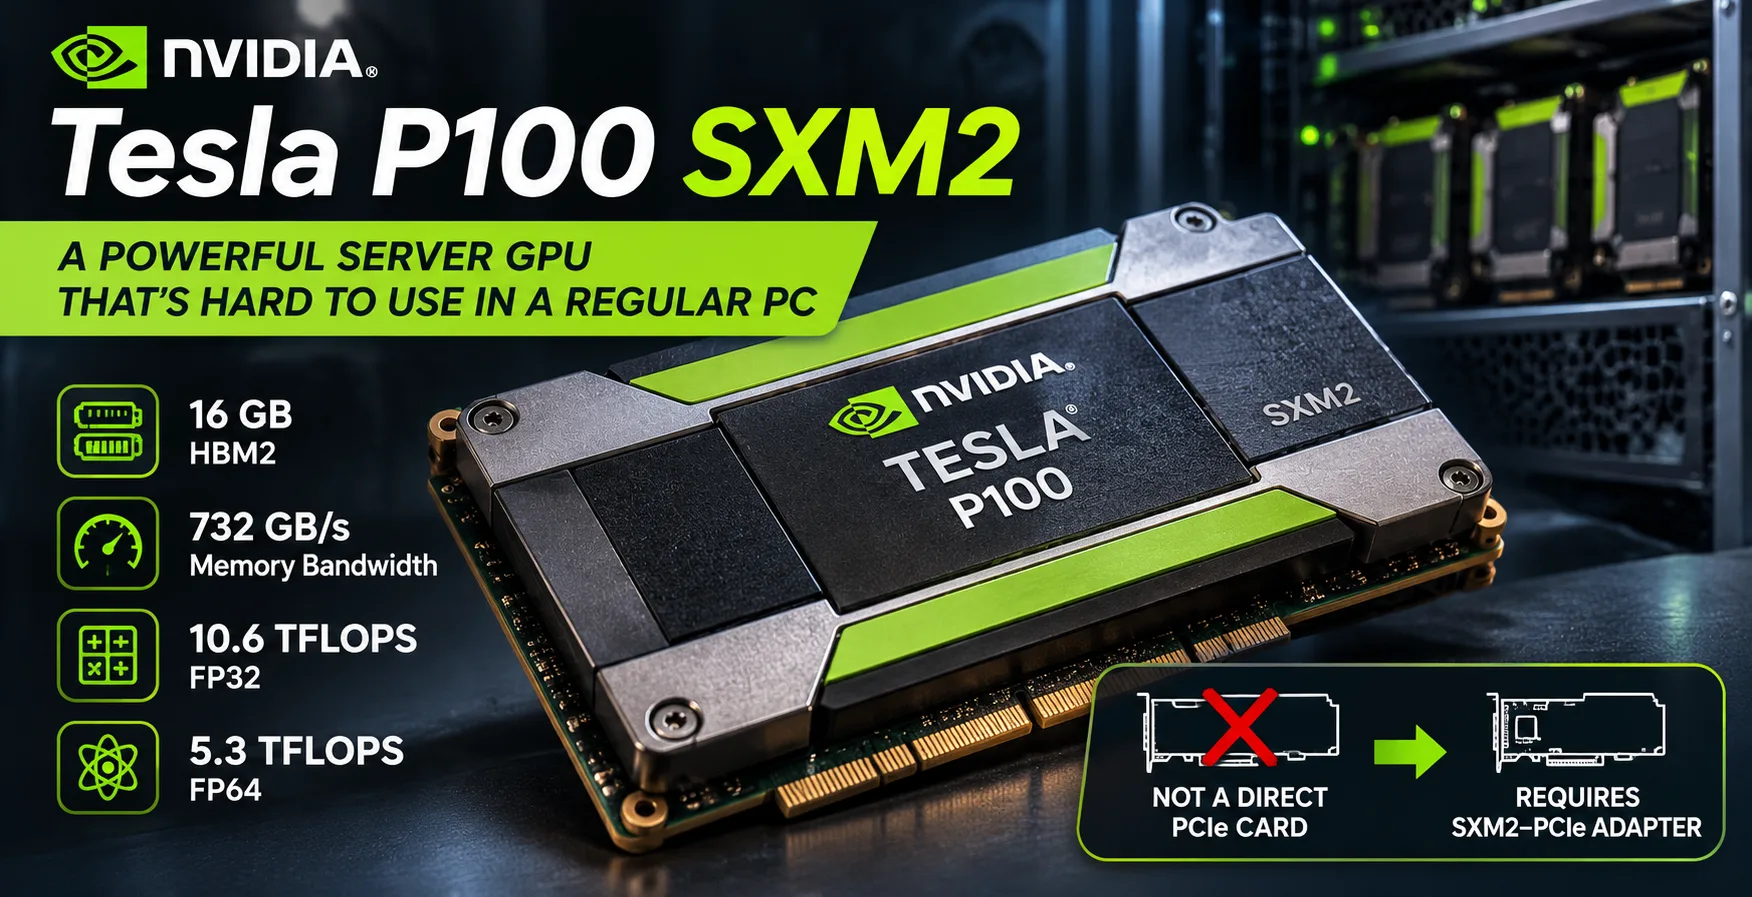
NVIDIA Tesla P100 SXM2: eine günstige Server-GPU, die sich nur schwer in einen gewöhnlichen PC einbauen lässt
Die NVIDIA Tesla P100 SXM2 lockt Enthusiasten mit einer Kombination aus 16 GB HBM2-Speicher, hoher FP64-Leistung und einem niedrigen Preis auf dem Gebrauchtmarkt. Dieser Beschleuniger aus dem Jahr 2016 hat jedoch einen entscheidenden Nachteil: Statt eines standardmäßigen PCIe-Anschlusses verwendet er den Serveranschluss SXM2. Für den Einbau in einen gewöhnlichen Computer werden ein Adapter, eine separate Kühlung und eine Kompatibilitätsprüfung benötigt. Dadurch kann das günstige Modul letztlich teurer werden als die bequemere PCIe-Version.
Warum sich SXM2 nur schwer an einen gewöhnlichen PC anschließen lässt
Die Tesla P100 SXM2 wurde für spezialisierte Server entwickelt, darunter NVIDIA-DGX-Systeme. Sie verfügt über keinen standardmäßigen PCIe-Anschluss und lässt sich nicht direkt in einen Mainboard-Steckplatz einsetzen.
Auf dem Gebrauchtmarkt sind SXM2-PCIe-Adapter erhältlich. Ein passender Anschluss allein garantiert jedoch noch keine Funktionsfähigkeit. Vor dem Kauf müssen mehrere Fragen geklärt werden:
- Stromversorgung. Der Beschleuniger verbraucht bis zu 300 W. Der Adapter muss die erforderliche Stromversorgung des Moduls gewährleisten.
- Kühlung. SXM2 ist für ein Server-Kühlsystem ausgelegt. Für ein gewöhnliches Gehäuse wird ein kompatibler Kühlkörper mit ausreichend starker Belüftung benötigt.
- Kompatibilität. Es muss geprüft werden, ob der konkrete Adapter, das Mainboard und der Treiber das jeweilige Modul unterstützen.
- Keine Videoausgänge. Die Tesla P100 ist nicht für den direkten Anschluss eines Monitors vorgesehen.
Die zusätzlichen Kosten können den Preisvorteil vollständig zunichtemachen. Nach einer Einschätzung des amerikanischen Gebrauchtmarkts im August 2026 wurden funktionsfähige P100-SXM2-Module für etwa $47-60 verkauft. Gleichzeitig wurde einer der SXM2-PCIe-Adapter mit ausgewiesener P100-Unterstützung im September für ungefähr $109 angeboten - ohne die zusätzlichen Kosten für Kühlung und Versand.
In diesem Beispiel liegt der Preis des Adapters fast doppelt so hoch wie der des Beschleunigers selbst. Daher ist es unsinnig, den Kauf einer SXM2 allein anhand des Modulpreises zu beurteilen.
Unterschiede zwischen Tesla P100 SXM2 und P100 PCIe
Beide Versionen basieren auf demselben Grafikprozessor GP100 mit Pascal-Architektur. Sie verfügen jeweils über 3584 CUDA-Kerne, und die Varianten mit 16 GB HBM2 bieten dieselbe Speicherbandbreite von 732 GB/s.
Die wichtigsten Unterschiede betreffen Taktraten, Stromversorgung und Anschluss.
| Merkmal | Tesla P100 SXM2 | Tesla P100 PCIe 16 GB |
|---|---|---|
| Anschluss | SXM2 | PCIe 3.0 x16 |
| Basistakt | 1328 MHz | 1126 MHz |
| Boost-Takt | 1480 MHz | 1303 MHz |
| GPU-Interconnect | NVLink, bis zu 160 GB/s | PCIe 3.0 |
| Maximale Leistungsaufnahme | 300 W | 250 W |
Die höheren Taktraten verschaffen der SXM2 bei der theoretischen FP32-Rechenleistung einen Vorsprung von etwa 14 %. Ihre maximale Leistungsaufnahme liegt allerdings um 50 W höher.
Ein weiterer Vorteil der SXM2 ist NVLink, über das die Beschleuniger Daten untereinander austauschen können. Diese Möglichkeit ist in kompatiblen Multiprozessor-Servern nützlich. Bei der Installation über einen gewöhnlichen PCIe-Adapter geht der Vorteil von NVLink verloren.
Bei einem einzelnen Beschleuniger in einem Desktop-PC fallen die Vorteile der SXM2 gegenüber der PCIe-Version vergleichsweise gering aus.
Leistung und Benchmarks
Der GP100 unterscheidet sich von den meisten Consumer-GPUs durch seine hohe Rechengeschwindigkeit bei doppelter Genauigkeit (FP64). Bei der Tesla P100 SXM2 erreicht sie 5,3 TFLOPS, wodurch sich der Beschleuniger für wissenschaftliche Berechnungen und numerische Modellierung eignet.
Zum Vergleich wurden Ergebnisse aus Geekbench 7 OpenCL sowie die theoretische Rechenleistung mehrerer konkreter Grafikkarten herangezogen.
| Grafikkarte | Geekbench 7 OpenCL | FP32, TFLOPS | FP64, TFLOPS |
|---|---|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 | 15,7 | 7,8 |
| NVIDIA GeForce RTX 3060 | 88 251 | 12,7 | 0,20 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 | 10,6 | 5,3 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 | 9,3 | 4,7 |
| NVIDIA Tesla T4 16 GB | 61 276 | 8,1 | ~0,25 |
Geekbench 7 OpenCL - Ergebnisse des öffentlichen Geekbench-Rankings vom Oktober 2026, mehr ist besser. FP32 und FP64 sind theoretische Kennzahlen und keine Geekbench-Ergebnisse. Sie dienen zum Vergleich der Rechenfähigkeiten der Architekturen.
In Geekbench erzielt die P100 SXM2 etwa 22 % mehr Punkte als die PCIe-Version mit 16 GB. Der Unterschied fällt größer aus, als die technischen Daten vermuten lassen. Die Ergebnisse wurden jedoch auf unterschiedlichen Systemen erzielt und erlauben nicht die Annahme, dass dieser Leistungszuwachs garantiert ist.
Bei der GeForce RTX 3060 ist die Situation interessanter. Ihre Geekbench-Werte liegen praktisch gleichauf, bei FP64 übertrifft die Server-Tesla die RTX 3060 theoretisch jedoch um mehr als das 26-Fache. Der Grund ist die spezielle Konfiguration der Recheneinheiten des GP100, die unter anderem auf wissenschaftliche Aufgaben ausgelegt ist.
Ähnliche OpenCL-Ergebnisse bedeuten allerdings keine gleichwertige Leistung in Spielen, beim Rendering oder in neuronalen Netzen.
Die Tesla V100 SXM2 ist dank der Volta-Architektur, der größeren Anzahl an Recheneinheiten und der höheren Speicherbandbreite deutlich schneller als die P100. Außerdem verfügt die V100 über Tensor Cores, die Pascal fehlen.
Für welche Aufgaben die P100 SXM2 noch geeignet ist
Trotz ihres Alters ist der GP100 nicht als nutzlos zu betrachten. Bei Aufgaben, die die Besonderheiten der Architektur nutzen können, bleiben einige Vorteile erhalten:
- Wissenschaftliche Berechnungen und Modellierung mit intensiver Nutzung von FP64.
- CUDA-Berechnungen mit kompatibler Software.
- Verarbeitung von Datenmengen, bei denen die hohe HBM2-Speicherbandbreite von Vorteil ist.
- Experimente mit Server-GPUs und Multiprozessor-Konfigurationen über NVLink.
Bei FP16 erreicht die P100 SXM2 theoretisch 21,2 TFLOPS. Dieser Wert sollte jedoch nicht direkt mit der Leistung der Tensor Cores modernerer Beschleuniger verglichen werden. Die Unterschiede bei Architektur und unterstützten Operationen sind zu groß.
Lokale neuronale Netze und CUDA-Einschränkungen im Jahr 2026
Die 16 GB Grafikspeicher machen die P100 für die Ausführung lokaler Sprachmodelle interessant. Beispielsweise können quantisierte Modelle mit 7-8 Milliarden Parametern bei geeigneten Einstellungen vollständig im Speicher des Beschleunigers Platz finden.
Die Speicherkapazität ist jedoch nur eine von mehreren Eigenschaften, die den praktischen Einsatz von LLMs bestimmen.
Der GP100 basiert auf der Pascal-Architektur und verfügt über die CUDA-Rechenfähigkeit 6.0. Die letzte Version des CUDA Toolkit, die das Kompilieren von Programmen für Pascal unterstützt, ist 12.9. In CUDA 13 wurde die Unterstützung dieser Architektur beim Kompilieren neuer Anwendungen eingestellt. Der letzte NVIDIA-Treiberzweig mit Pascal-Unterstützung ist R580.
Das bedeutet nicht, dass ältere Programme plötzlich nicht mehr funktionieren. Neuere Versionen von Bibliotheken für maschinelles Lernen können jedoch eine modernere Architektur voraussetzen. Für die Ausführung bestimmter Modelle müssen ältere Softwareversionen installiert oder kompatible Komponenten selbst kompiliert werden.
Das Fehlen von Tensor Cores begrenzt die Geschwindigkeit moderner Berechnungen für neuronale Netze. Daher ist eine P100 SXM2 mit ihren 16 GB HBM2 nicht zwangsläufig schneller als eine Consumer-RTX mit weniger Speicher.
Bei lokalen LLMs ist es wichtiger, die Unterstützung des konkreten Modells und der Softwareumgebung zu prüfen, als sich an FP16-Werten oder der Speicherbandbreite zu orientieren.
Lohnt sich der Kauf einer Tesla P100 SXM2 im Jahr 2026?
Wenn bereits ein Server mit kompatiblen SXM2-Anschlüssen vorhanden ist, eignet sich die Tesla P100 weiterhin für FP64-Berechnungen und die Arbeit mit älterer CUDA-Software. Der niedrige Preis auf dem Gebrauchtmarkt macht sie für solche Systeme attraktiv.
In einem gewöhnlichen Desktop-PC sieht die Situation anders aus. Der Leistungszuwachs gegenüber einer P100 PCIe ist gering, während die Kosten für Adapter, Kühlung und Stromversorgung den Preis des Beschleunigers selbst übersteigen können.
Für Experimente mit lokalen LLMs ist eine modernere GeForce RTX mit Tensor Cores und Unterstützung für aktuelle Software die bequemere Wahl. Wird dagegen ausdrücklich die GP100-Architektur benötigt, erspart die PCIe-Version mit 16 GB die Suche nach einem SXM2-Adapter. Auch für sie ist allerdings eine leistungsstarke gerichtete Belüftung erforderlich.
Fazit: Die Tesla P100 SXM2 ist nach wie vor ein leistungsfähiger FP64-Beschleuniger, aber kein guter Kandidat für den günstigen Aufbau eines gewöhnlichen PCs. Der Kauf ist sinnvoll, wenn kompatible Hardware vorhanden ist oder ein technisches Experiment im Vordergrund steht. Am Modul selbst zu sparen, um anschließend für dessen Anschluss mehr auszugeben, lohnt sich in der Regel nicht.
GPU-Vergleich
Tesla P100 SXM2 mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
Verwandte GPU-Vergleiche

In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/index.php/de/gpu/nvidia-tesla-p100-sxm2" target="_blank">NVIDIA Tesla P100 SXM2</a>